Tencent의 Hy4 flash는 순수한 성능 우위를 앞세우기보다 가격 대비 성능으로 경쟁하도록 설계됐습니다. 총 2,240억 개의 파라미터를 갖추면서도 추론 시에는 120억 개만 활성화해, 대규모 오프라인 용량을 유지하면서 실행 비용을 낮추는 것을 목표로 합니다. Tencent는 멀티모달 입력과 100만 토큰 컨텍스트 창을 강조하며, 여러 추론 최적화를 통해 초당 150개가 넘는 토큰을 디코딩한다고 주장합니다. 모델을 검토하는 팀에 Hy4 flash는 상당한 컨텍스트 처리 능력과 시각 이해를 갖추면서도 일부 최첨단 모델보다 작업당 비용이 훨씬 낮은 실용적인 절충안이 될 수 있습니다.
Hy4 flash는 내부적으로 Hy 계열에 도입된 여러 아키텍처 기능을 활용합니다. 장기 지식을 효율적으로 저장하는 Engram 파라미터화, 필요한 곳에 연산을 집중하는 LatentMoE 조건부 용량, 그리고 컨텍스트를 효율적으로 확장하는 하이브리드 어텐션이 적용됩니다. Tencent는 추론 시 메모리 사용량과 캐시 I/O 비용을 낮추기 위한 의도적인 설계 선택으로 KV 캐시 용량도 크게 줄였다고 밝혔습니다. 또한 후속 학습의 강화 학습 덕분에 일반적인 작업에서 평균 출력 토큰 길이가 절반으로 줄었다고 설명합니다. 이는 출력 토큰 과금 감소와 많은 업무 흐름의 처리 시간 단축으로 이어질 수 있습니다.
기업 환경에서 실무적으로 가장 의미 있는 특징은 100만 토큰 컨텍스트 창과 초당 150개를 넘는다고 주장하는 디코딩 속도입니다. Tencent는 메가커널 최적화, 4비트 양자화, DFly 실행 전략, 소형 KV 캐시를 결합해 이러한 성능을 구현했다고 설명합니다. 긴 컨텍스트와 빠른 디코딩을 활용하면 문서 전체와 슬라이드 자료, 여러 파일로 구성된 대화를 한 번에 처리할 수 있습니다. 기존에는 이런 작업에 비용이 많이 드는 청크 분할이나 상태 통합, 에이전트 오케스트레이션이 필요했습니다. 실제 환경에서도 모델의 컨텍스트 처리 안정성이 뒷받침된다면 고객 업무 흐름의 엔지니어링 복잡도와 지연 시간을 줄일 수 있습니다.
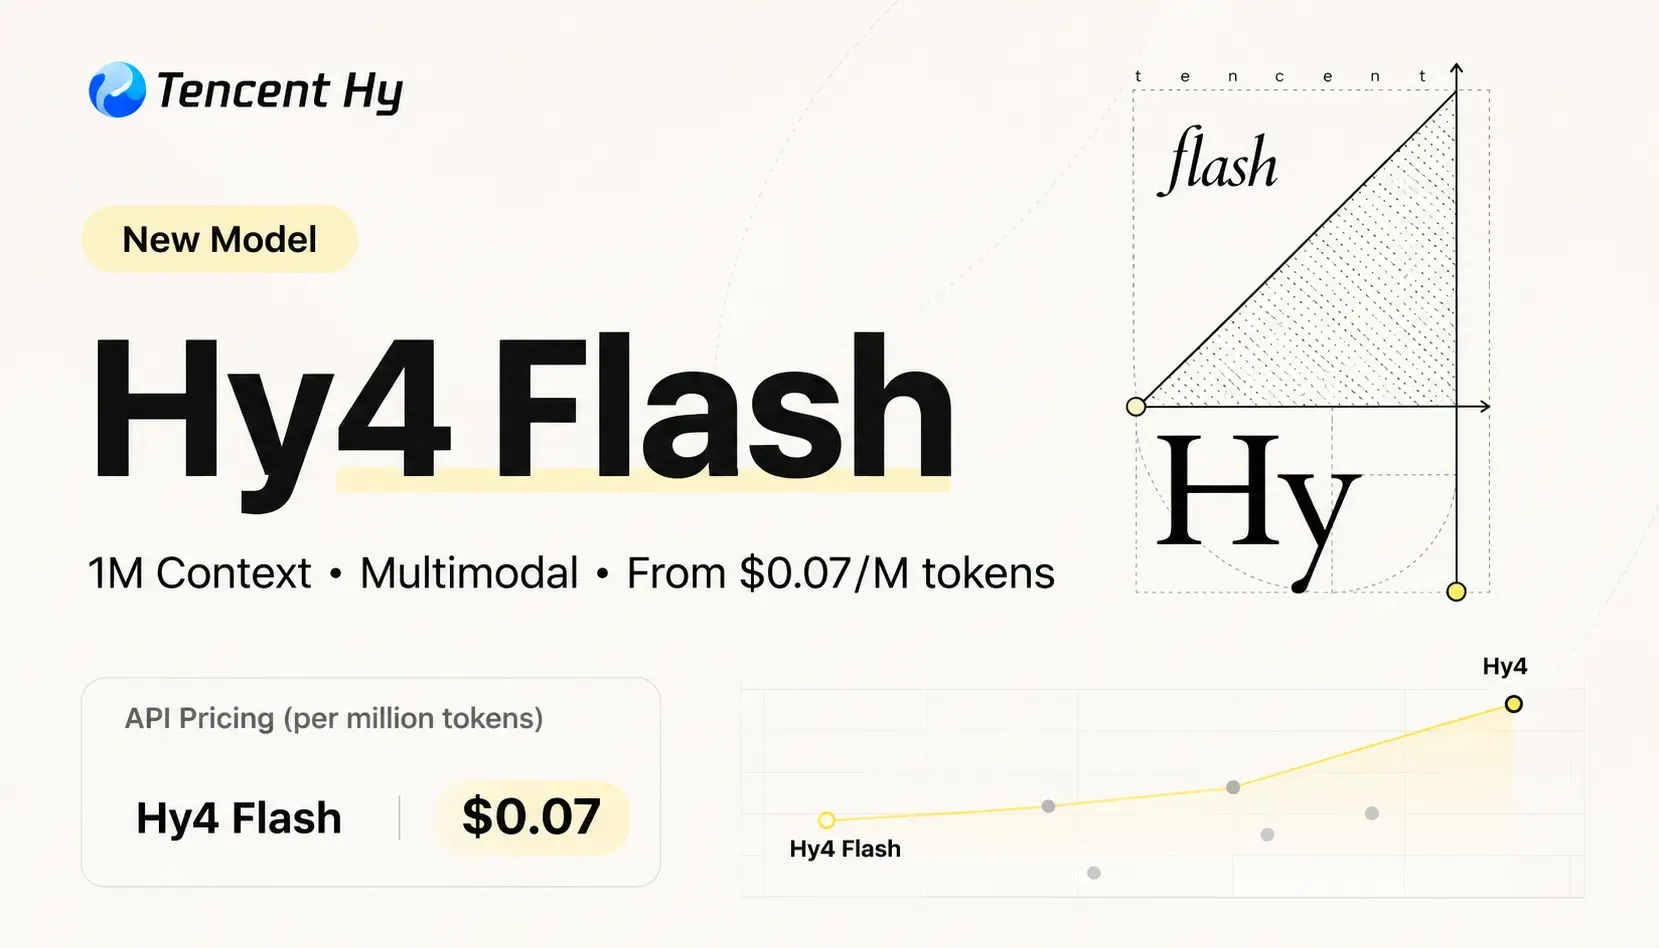
Tencent가 공개한 API 가격은 입력 토큰 100만 개당 약 0.070달러, 출력 토큰 100만 개당 0.281달러이며, 캐시된 입력에는 매우 낮은 요금이 적용됩니다. 회사는 내부 WorkIndex 기준으로 Hy4 flash의 작업당 비용이 더 큰 Hy4 모델과 다른 최첨단 모델보다 훨씬 낮다고 주장합니다. 이 설명은 처리량과 예측 가능한 비용, 문서 작업을 중시하는 조직에 유용한 판단 기준이 될 수 있습니다. Hy4 flash를 도입하면 운영 비용을 크게 낮출 가능성이 있습니다. 다만 Tencent의 내부 벤치마크와 블라인드 사용자 평가 결과는 참고 자료로 보되, 독립적으로 검증된 사실로 간주해서는 안 됩니다. 실제 도입 전에는 대표성 있는 제3자 작업을 통해 비용과 품질을 비교 검증해야 합니다.