

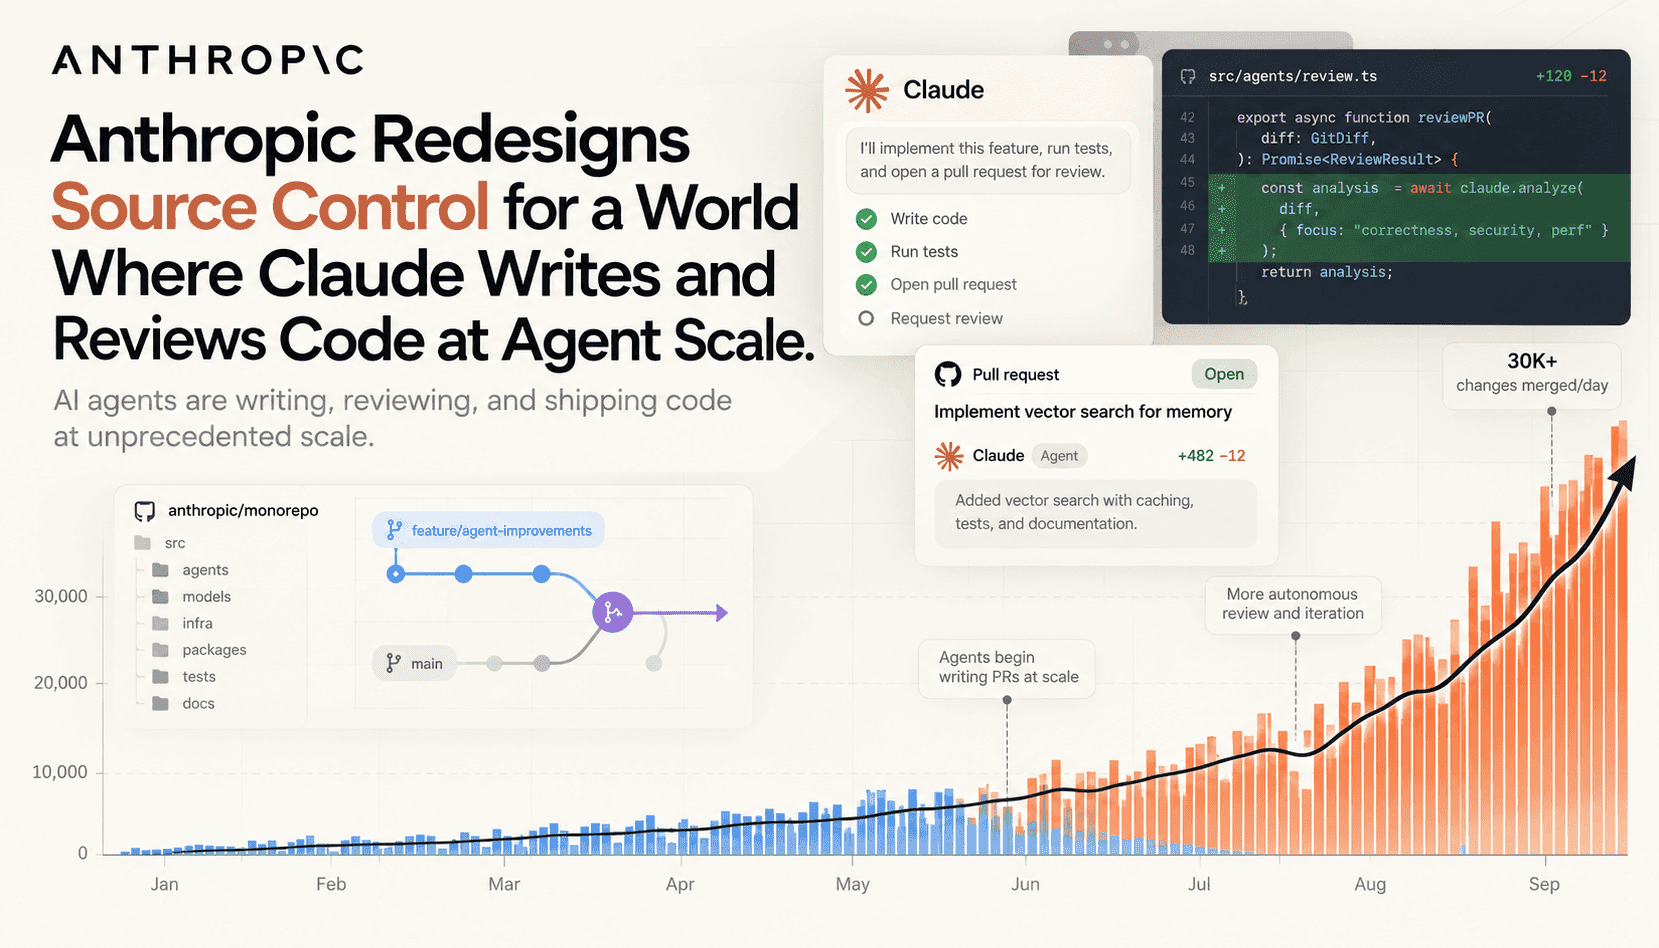
A migração da Anthropic do Git para um sistema próprio — o Scion — foi uma resposta estrutural a uma virada operacional: agentes autônomos, especialmente Claude, começaram a produzir e mesclar dezenas de milhares de alterações por dia, rompendo as premissas incorporadas em ferramentas criadas para fluxos de trabalho na escala humana. A empresa percebeu que as premissas descentralizadas (clones completos, troca baseada em packfiles e referências locais) se tornaram um entrave quando a maioria dos clientes são agentes conectados que precisam apenas de partes de um repositório. O Scion reformula o problema como uma questão de metadados de alta capacidade, gerenciados no servidor, e entrega seletiva de arquivos. Essa mudança de perspectiva tem implicações para a forma como as equipes projetam pipelines, monitoram o estado e auditam alterações.
Em sua essência, o Scion substitui as operações sobre o grafo completo do Git por conjuntos de alterações no servidor e índices derivados desses conjuntos. Em vez de enviar packfiles imutáveis a cada cliente, o Scion disponibiliza blobs endereçados por conteúdo, solicitações direcionadas de árvores e APIs de servidor para blame, ancestralidade e diferenças. A cópia de trabalho é opcional: tarefas de CI e pesquisa podem consultar os metadados no servidor ou materializar apenas os caminhos que leem. Isso reduz drasticamente o uso de rede, CPU e armazenamento e torna a criação de commits barata e sem bloqueios — algo essencial quando o número de mesclagens diárias cresce em uma ordem de grandeza.
Do ponto de vista operacional, essa mudança exige repensar todo o conjunto de ferramentas: CI, revisão de código, IAM e observabilidade precisam partir do princípio de que o VCS é centrado no servidor. Pulls e builds passam a usar padrões de leitura orientados por cache em servidores em camadas, em vez de clones em massa de espelhos. Os dados derivados (índices de blame, históricos de caminhos e listas de saltos) precisam ser calculados e armazenados de forma incremental; decidir entre o cálculo antecipado e o sob demanda afeta diretamente a latência, o armazenamento e os custos operacionais. As equipes terão de reformular a inicialização de tarefas, a experiência local dos desenvolvedores e o planejamento de capacidade, priorizando caches de objetos, downloads retomáveis e isolamento regional.
Para as lideranças de engenharia, as perguntas práticas são imediatas: como confiar em alterações geradas por agentes em grande escala? Como instrumentar e aplicar políticas? E como evitar a criação de um gargalo central de coordenação? A experiência da Anthropic mostra que é possível responder a essas questões combinando aplicação de políticas no servidor, interfaces programáticas de revisão, pipelines de validação adversarial e uso criterioso de referências. As concessões técnicas — menos autonomia local, mais processamento centralizado e novas tarefas de manutenção de dados derivados — são compensadas por grandes ganhos de velocidade e reprodutibilidade, além da capacidade de operar na escala de agentes.