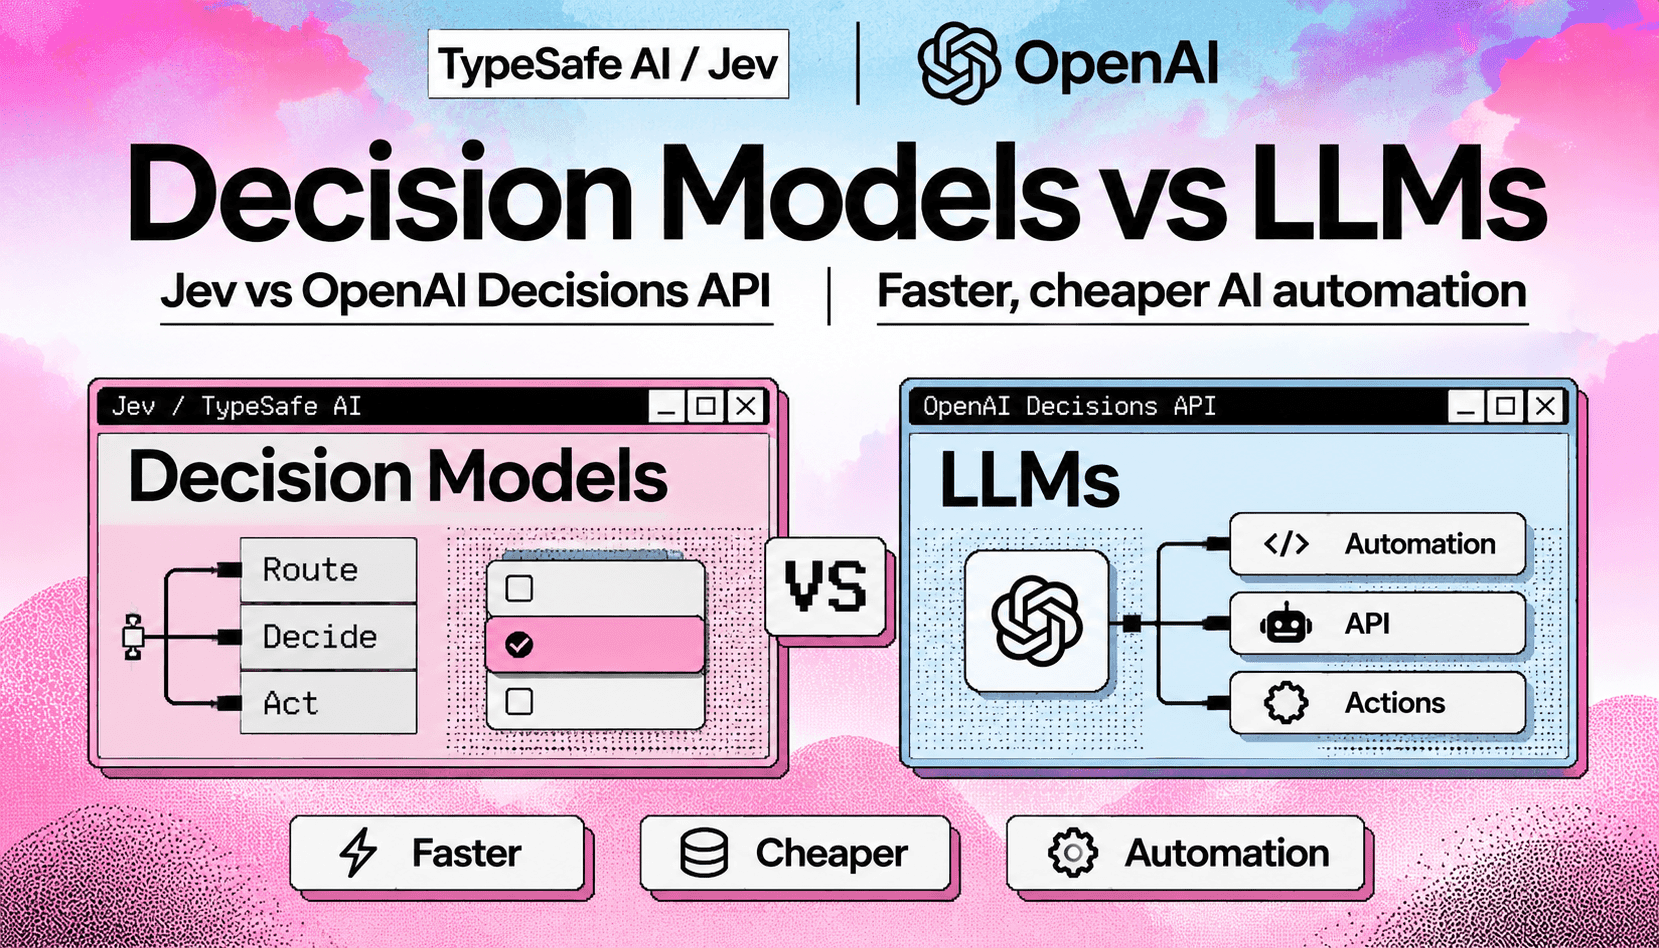
Các mô hình ra quyết định như Jev và Decisions API của OpenAI đang nổi lên như những lựa chọn tinh gọn thay thế LLM tạo sinh trong tự động hóa doanh nghiệp với lưu lượng lớn. Bài viết so sánh khả năng phân loại, độ trễ, chi phí, chấm điểm và khả năng giải thích, đồng thời phác thảo các kiến trúc thực tiễn giúp xác định khi nào nên chuyển yêu cầu đến mô hình ra quyết định, khi nào nên gọi LLM và cách kết hợp cả hai.
Các doanh nghiệp xây dựng quy trình tự động hóa thường xuyên phải đối mặt với một vấn đề dai dẳng: LLM tạo sinh rất linh hoạt, nhưng tốn kém và chậm nếu được dùng cho mọi quyết định định tuyến, chấm điểm hay phân loại nhị phân. Một thế hệ mô hình ra quyết định nhỏ gọn mới—đại diện là các sản phẩm như Jev và Decisions API của OpenAI—nhắm chính xác vào những trường hợp sử dụng này. Chúng được huấn luyện để phân loại một cách xác định, cung cấp kết quả độ tin cậy đã hiệu chỉnh và được thiết kế để hoạt động với độ trễ cũng như chi phí tính toán thấp hơn LLM suy luận toàn diện. Sự thay đổi này không nhằm thay thế LLM, mà là ghép năng lực của mô hình với đúng tác vụ để đạt được hiệu suất và chi phí có thể dự đoán.
Mô hình ra quyết định phát huy hiệu quả trong các tác vụ phân loại có cấu trúc, định tuyến và thực thi chính sách, nơi đầu vào được ánh xạ vào một tập hợp kết quả tương đối nhỏ. Trên thực tế, đó có thể là phân loại ý định nhanh, định tuyến giao dịch gian lận/không gian lận, kiểm tra điều kiện đủ đơn giản hoặc chấm điểm giàu đặc trưng để cung cấp dữ liệu cho các tác nhân ở bước sau. Có thể triển khai chúng dưới dạng vi dịch vụ ở biên hoặc bên trong công cụ quy tắc, rồi dùng làm bộ lọc ban đầu trước khi gọi một mô hình suy luận lớn hơn. Nhờ đầu ra gọn nhẹ và dễ dự đoán, chúng giúp đáp ứng các SLA về độ trễ chặt chẽ hơn và đơn giản hóa việc giám sát so với cách giao mọi việc cho mô hình tạo sinh.
Bài viết này so sánh các khía cạnh có thể đo lường—độ trễ, chi phí mỗi quyết định, chấm điểm độ tin cậy và khả năng giải thích—giữa các mô hình ra quyết định tiêu biểu như Jev và Decisions API của OpenAI với các LLM tạo sinh lớn hơn. Tiếp đó, bài viết phác thảo những kiến trúc thực tiễn kết hợp lớp ra quyết định với LLM để giảm số lượt gọi tốn kém, tăng độ tin cậy và chỉ duy trì năng lực suy luận ở những nơi thực sự cần thiết. Cuối cùng là hướng dẫn vận hành: khi nào nên chọn mô hình định tuyến hoặc chấm điểm, khi nào cần giữ lại luồng suy luận và cách đo lường hệ thống kết hợp để phát hiện, giảm thiểu việc định tuyến sai.
Khi nào nên định tuyến đến mô hình ra quyết định, khi nào nên gọi LLM suy luận
Để thiết kế hệ thống kết hợp, hãy bắt đầu bằng một nguyên tắc đơn giản: đưa các luồng xác định, tần suất cao và rủi ro thấp qua mô hình ra quyết định; dành LLM cho những tác vụ cần tổng hợp, suy luận dài hoặc sáng tạo. Ví dụ, dùng mô hình ra quyết định để phân loại ý định, lọc thư rác/gian lận hoặc kiểm tra điều kiện đủ. Chuyển những trường hợp mơ hồ hoặc có độ tin cậy thấp sang LLM để suy luận sâu hơn. Hãy thiết lập ngưỡng độ tin cậy cùng một quy trình dự phòng nhanh để mô hình ra quyết định vừa lọc chi phí vừa đóng vai trò như mạng lưới an toàn cho LLM, hạn chế các lượt gọi tốn kém mà vẫn giữ nguyên năng lực suy luận cho những trường hợp phức tạp thực sự.
Về vận hành, hãy bổ sung các chỉ số theo dõi phân bố định tuyến, tỷ lệ đầu vào được chuyển lên LLM và tỷ lệ lỗi của cả hai luồng. Khi mới đưa vào sản xuất, hãy đặt ngưỡng thận trọng rồi điều chỉnh chặt hơn khi đã thu thập được kết quả có nhãn. Cách triển khai theo từng giai đoạn này giúp giảm rủi ro kinh doanh và tạo ra một công cụ đo lường được để cân bằng chi phí, độ trễ và độ chính xác.
Kết hợp mô hình để giảm chi phí và độ trễ của quy trình tác nhân
Kiến trúc tác nhân kết hợp ghép một lớp ra quyết định nhanh với LLM suy luận để giảm thiểu các lượt gọi tốn kém trong quy trình nhiều bước. Chẳng hạn, tác nhân có thể nhờ mô hình ra quyết định chuyển yêu cầu của người dùng đến một công cụ chuyên dụng, chỉ gọi LLM khi mô hình ra quyết định trả về độ tin cậy thấp hoặc khi cần suy luận qua nhiều bước. Mẫu này giảm số lượt gọi LLM tiêu tốn token trong vòng lặp tác nhân và cắt giảm độ trễ tích lũy. Việc tự động mở rộng quy mô cũng đơn giản hơn: mô hình ra quyết định xử lý trực tiếp các đợt tăng tải, còn một cụm LLM nhỏ hơn nhiều chỉ đảm nhiệm những trường hợp ngoại lệ.
Một số lưu ý khi triển khai: ưu tiên đầu ra nhị phân hoặc phân loại đa lớp với ít lớp từ mô hình ra quyết định, đo lường độ trễ đầu-cuối ở từng chặng và duy trì luồng chuyển cấp gọn nhẹ, có người tham gia xử lý các kết quả rủi ro cao. Khoản tiết kiệm sẽ cộng dồn trong các hệ thống có cơ chế phân nhánh—định tuyến nhiều yêu cầu con—vì mỗi lượt gọi LLM được tránh sẽ nhân mức tiết kiệm xuyên suốt quy trình.