

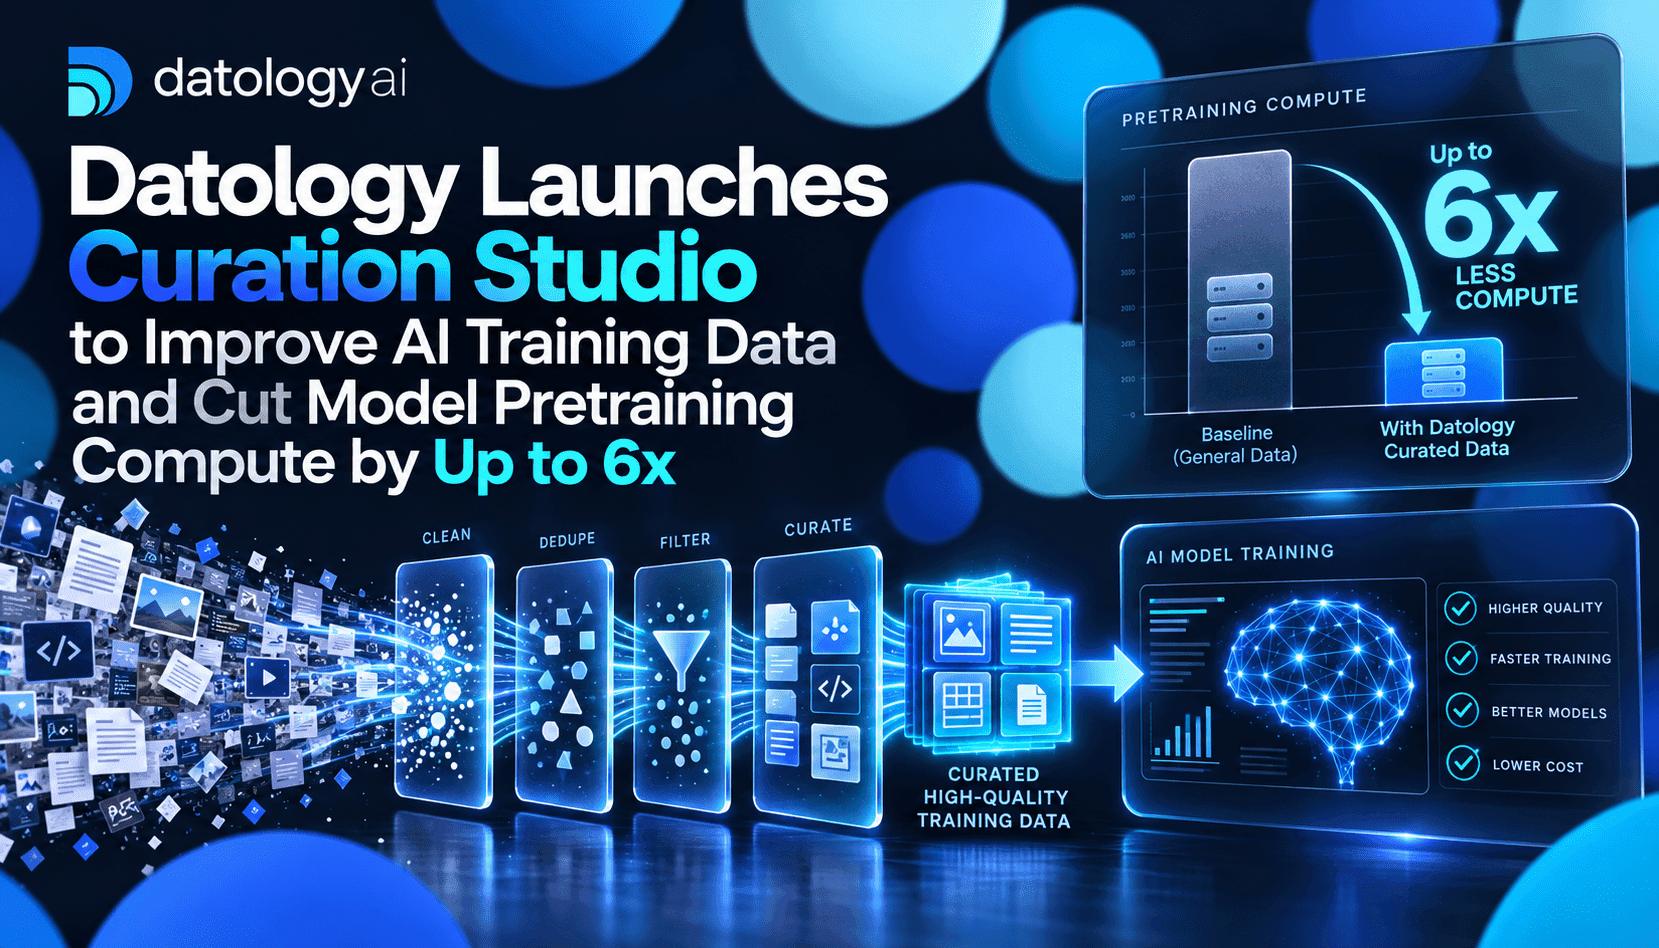
Datology 全新的 Curation Studio 定位為原始內容與模型訓練之間的營運層。它不只是持續匯入更多 Token,而是透過「清理、校準、生成、組合」四階段流程,找出對您關注的任務最有價值的訊號。這項做法之所以重要,是因為 Datology 的實驗顯示,相較於盲目增加預訓練運算量,策展訓練資料能更有效率地提升模型的實際效能。對工程與產品團隊來說,這也改變了資源配置的重心:從原始 GPU 使用時數,轉向資料生命週期工程與合成資料擴增策略。
其技術核心在概念上並不陌生,關鍵在於規模化落地:嚴謹的資料污染清除與啟發式清理、依文件評分並調整權重、以高品質來源範例為依據生成合成資料,以及可設定的組合引擎,能依不同訓練階段混合資料子集。Datology 表示,他們的實驗發現,使用策展資料集訓練的小型模型,即使使用較少 Token,也能媲美甚至超越以更多運算資源訓練的大型基準模型。對實務工作者而言,這代表一項直接可行的取捨:以更聰明的策展流程和推論成本更低的小型服務模型,換取較少的預訓練 FLOPs。
要在企業規模落實前沿資料策展,工程挑戰不容小覷。Datology 表示,他們採用 PB 級資料處理流程、自訂運算子圖,以及大量中間資料快取,藉此處理數百 TB 至數 PB 的資料,同時避免成本或執行時間失控。這些工作,正是實驗室研究與產品團隊能在客戶 VPC 內實際運行的方案之間的差異。對考慮自行打造專屬模型的企業而言,這種產品模式別具意義:企業能保有資料控制權、維護資料來源脈絡,也無須將原始智慧財產傳送至外部服務,同時仍可運用進階資料策展技術。
商業效益主要體現在兩項可量化指標:每單位預訓練運算量所達成的模型效能,以及每項任務的推論成本。Datology 舉例指出,使用較少 Token 預訓練的策展版 12B 模型,表現勝過使用更多運算資源的 30B 大型基準模型,展現了資料策展如何同時降低有效能模型的規模與訓練預算。對決策者來說,重點很明確:及早投資資料工具與流程,並以經運算量標準化的基準來衡量效能,而不應只看 Token 數。