

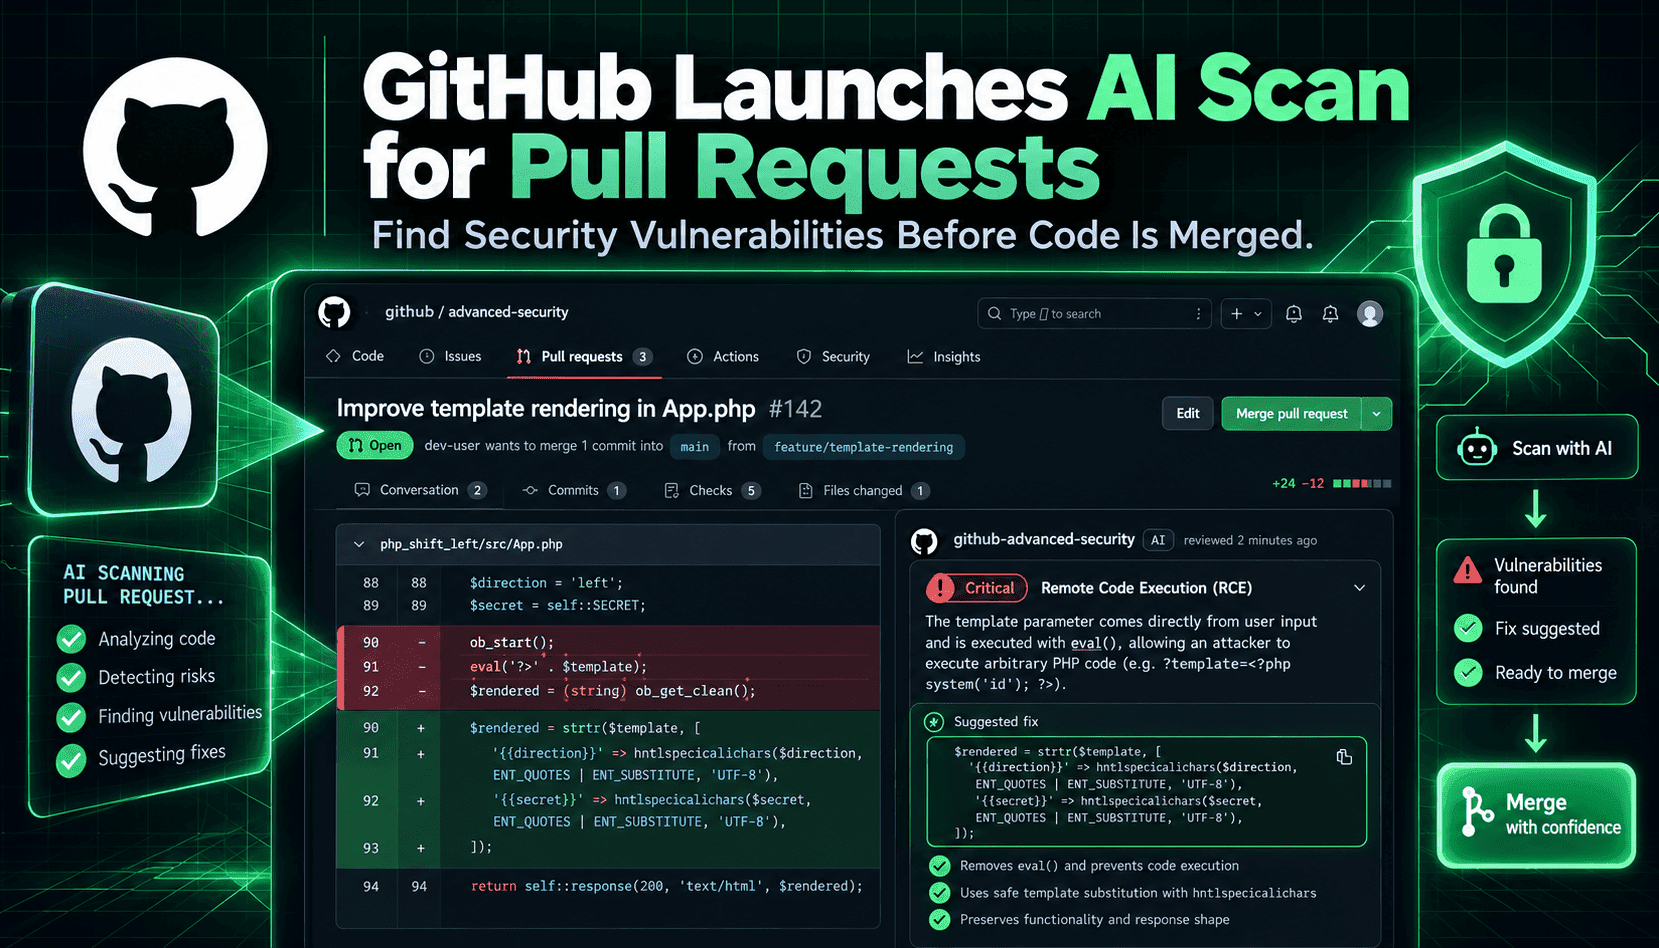
GitHub 宣布 Pull Request AI Scan 正式推出,代表程式碼安全整合進日常開發流程的方式正迎來重要轉變。AI Scan 並非取代 CodeQL 的確定性模式比對,而是運用專為 Pull Request 情境打造的模型,分析變更行、周邊程式碼及儲存庫結構。這種脈絡感知能力,讓它能在 CodeQL 尚未涵蓋的語言與檔案中提出調查結果,甚至提供自動修正建議,例如 PHP、Shell、Terraform HCL、Dockerfile、JSP 和 Blazor。對於快速交付產品的團隊來說,兩者結合有望及早發現靜態規則難以察覺的檢查遺漏、不安全預設值或部署階段的設定錯誤。
在實際運作上,啟用程式碼掃描和儲存庫的 AI Scan 設定後,AI Scan 就會執行,並在「Conversation」和「Files changed」分頁與 CodeQL 結果一同顯示,同時以「AI」標示。重要的是,掃描結果僅供參考:不會讓程式碼掃描檢查失敗,也無法透過 rulesets 阻擋合併。這項設計顯示 GitHub 希望加快回饋速度,又不設下硬性門檻,並將最終判斷留給開發者。對組織而言,這也帶來幾個設計問題:如何將 AI 建議納入分流流程、何時需要人工簽核,以及如何讓 AI 產生的自動修正符合現有 CI/CD 與安全政策。
從技術角度來看,AI 輔助掃描與傳統靜態分析有三項實際差異。第一,模型能跨檔案整合脈絡,並從程式碼模式與註解推斷意圖,而不只是依賴語法規則。第二,模型可以提出務實的修正方式,也就是具備程式碼脈絡感知能力、但結果帶有機率性的自動修正。第三,模型能涵蓋缺乏成熟查詢函式庫的語言與設定格式。不過,這些優勢也伴隨不同的失誤風險:修正內容憑空捏造、忽略邊界情況,或提出範圍過廣的判斷。因此,在將 AI 掃描結果視為可靠依據之前,必須先驗證結果,並建立可重複執行的人機協作流程。
實務上,團隊應將 AI Scan 視為分層安全策略中的新訊號。運用它及早發現可能的問題、在 PR 討論中補充說明,並透過自動忽略規則加快處理嘈雜且低風險的問題。對於高風險發現,例如驗證、授權、密碼學與注入路徑相關問題,則應要求人工確認,並以 CodeQL、SAST 工具和 Pull Request 測試交叉驗證。追蹤與記錄同樣重要:記錄 AI Credit 用量、保留自動修正的稽核軌跡,並追蹤誤報,以便調整模型行為或透過儲存庫層級設定限制掃描範圍。