

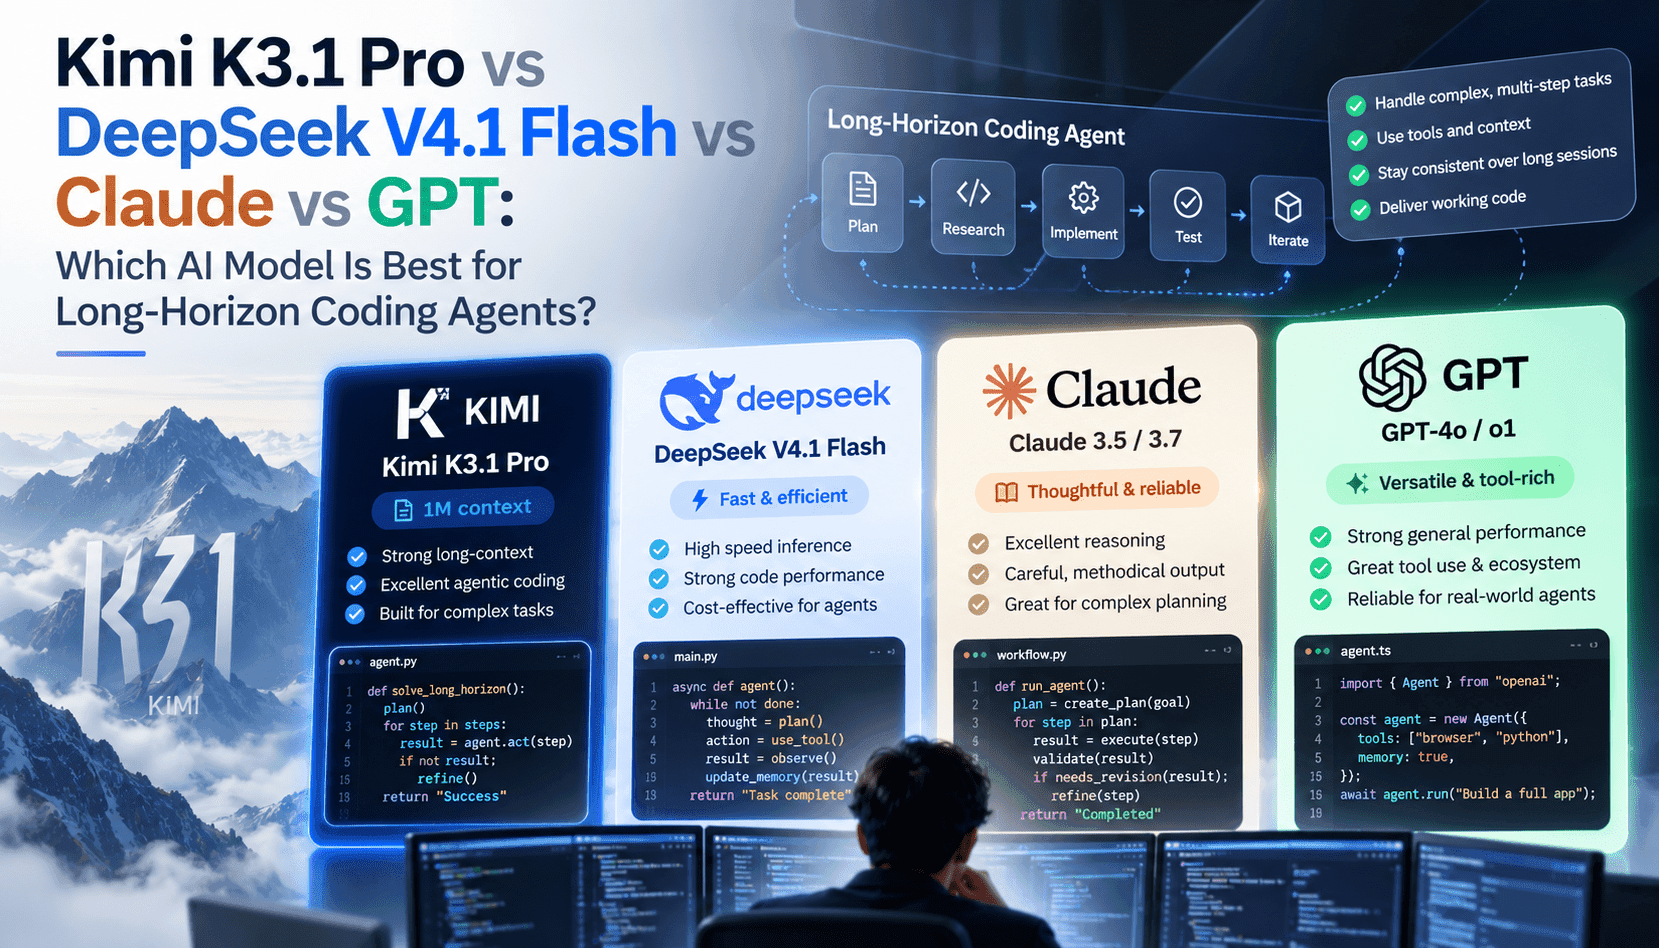
評估長程式開發代理,不能只看單輪程式碼補全的表現。這類代理必須能在多次工具呼叫間持續推理、跨工作階段穩健快取狀態、有效處理增量更新,並讓每項開發任務的成本保持可預測。Kimi K3.1 Pro 的 100 萬 token 上下文視窗與思考模式原語,明確針對這類工作流程而設;DeepSeek Flash 版本著重低延遲與串流吞吐量,Claude 強調安全性與可控推理,而 GPT 系列模型則具備廣泛的生態系,對話式工具鏈往往也名列前茅。對工程團隊來說,重點不是哪款模型客觀上「最好」,而是哪款最符合程式碼儲存庫規模、CI/CD 節奏、預算與風險承受度。
將模型功能對應到代理工作流程時,實際取捨就會浮現。當代理需要推理橫跨多個模組的歷史脈絡、長篇設計文件和累積的工具輸出時,100 萬 token 上下文便能派上用場,例如涉及多個 PR 的重構或跨儲存庫遷移。但若代理沒有運用選擇性精簡、檢索增強提示與工作階段快取策略,避免傳送無關 token,再大的上下文也無用武之地。更快的推論(例如 K3.1 Pro Highspeed 或 DeepSeek Flash)能縮短實際執行時間、減少開發者等待;然而,token 單價、批次大小與 I/O 開銷,才決定更快的模型是否真的能降低正式環境的營運成本。
開放權重模型改變了部署的成本考量:團隊可以在私有硬體上執行代理、自行掌控遙測資料並避免受制於單一供應商,但也必須自行承擔營運工作,包括服務延遲、長上下文分片,以及持續更新安全過濾機制。專有前沿模型則能節省時間:更出色的開箱即用推理能力、整合式工具生態系與代管防護機制,都能減少工程負擔。該如何選擇,取決於組織更重視資料隱私與內部部署的低延遲,還是希望盡量減少整合工作,並仰賴供應商 SLA 取得安全更新與模型改進。
除了原始能力,也要評估模型在多工具代理中的表現:是否支援確定性的工具呼叫規格、結構化思考模式、工具輸出串流,以及具權限控管的核准流程?Kimi 的思考模式與工作階段控制功能,旨在減少長流程中的幻覺;DeepSeek Flash 的效能有助於降低緊湊 CI 迴圈中的逾時情況;Claude 以安全為先的啟發式機制,適合合規要求嚴格的企業;GPT 系列模型則受惠於豐富的生態系連接器與第三方協調框架。比較各模型的整合難度、可稽核性,以及工具在計畫執行途中失效時的復原能力。