

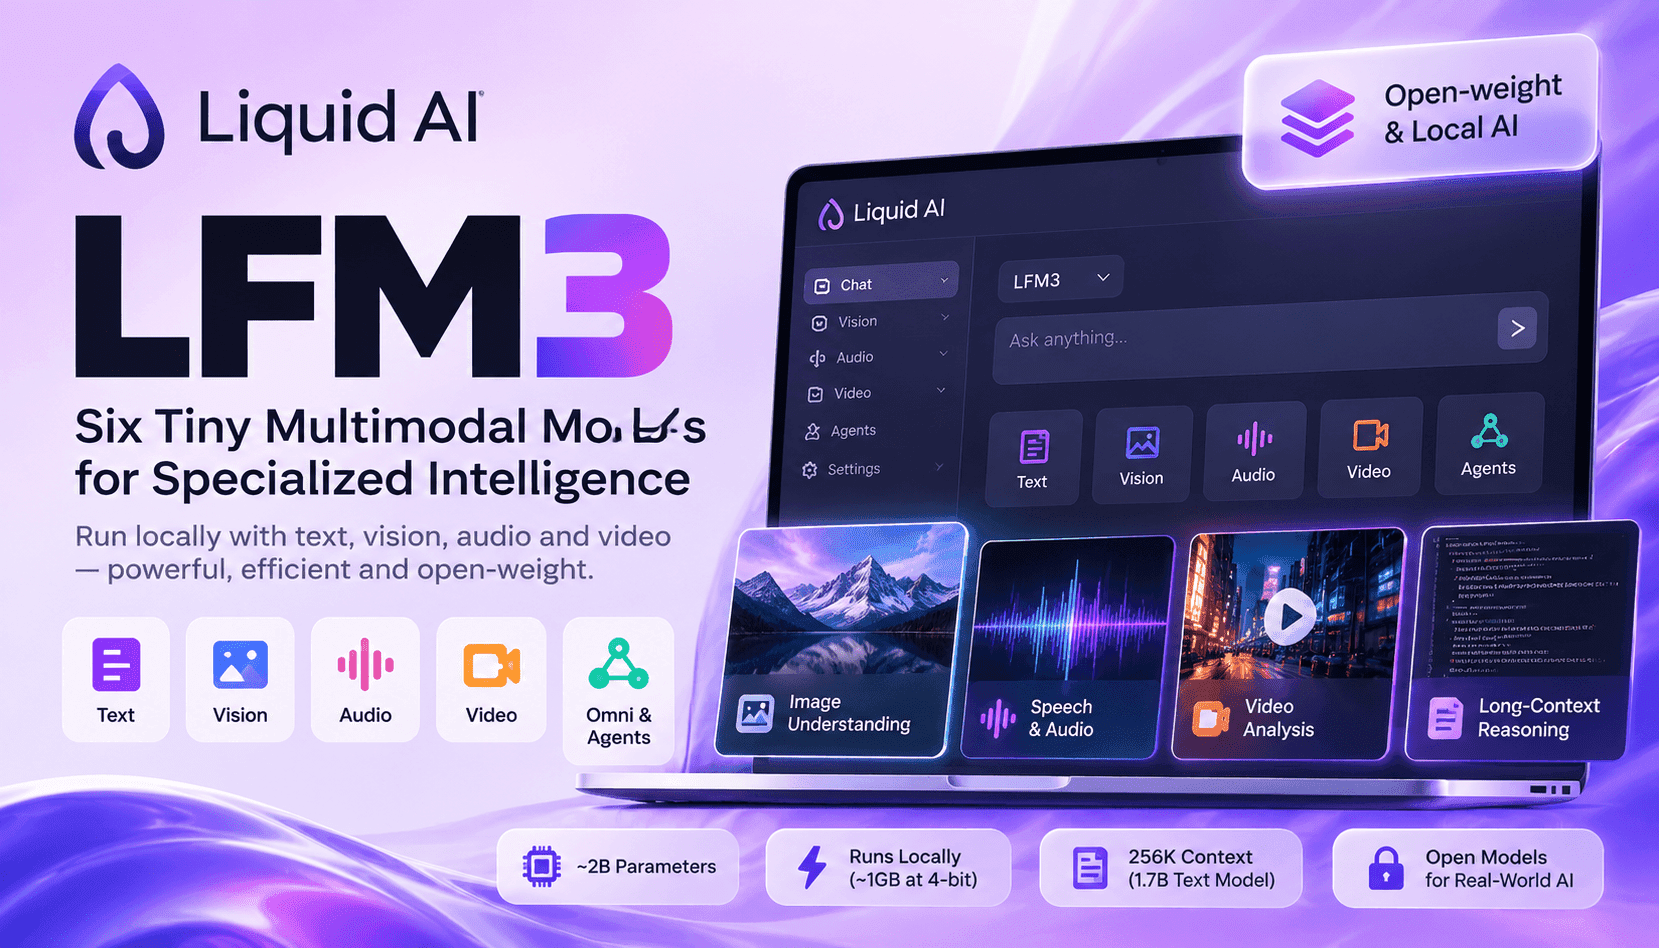
Liquid AI 發表 LFM3,展現務實的策略轉向:團隊不再一味追求更大型的通用模型,而是以單一 17 億參數骨幹為基礎,打造六款專用模型。這個系列針對多模態能力進行精細最佳化,涵蓋文字、視覺、音訊、全模態與決策模型,並將重點放在裝置端處理效能、長上下文能力及本機微調。對實務工作者而言,這點至關重要,因為整套技術刻意針對真實部署限制設計:有限的 RAM/快閃記憶體、單張 GPU 訓練,以及對延遲敏感的互動式工作負載。
在技術架構上,LFM3 採用三重混合設計,結合閘控短卷積、滑動視窗注意力與選擇性全域注意力;這種設計能以更少參數實現更多能力,同時讓長上下文的成本維持在可控範圍。旗艦文字模型 LFM3-1.7B 支援 256K token 的上下文視窗,並可透過 4 位元格式量化至約 1GB。超長上下文搭配極小的量化體積,讓模型得以在私有環境中支援持續運作的背景代理、大型文件推理與工具操作;在這些環境裡,資料不能傳送至雲端 API,或使用雲端 API 的成本過高。
除了核心架構,Liquid AI 也推出全新的視覺與音訊編碼器,在提升影片與語音處理能力的同時降低運算負擔。視覺模型以成對影格的時間切片處理影片,將序列長度減半;音訊模型則支援串流語音、多語言 ASR/TTS 及工具呼叫工作流程。這些能力結合後,可打造能聆聽、觀看並採取行動的混合式代理,且首個 token 延遲極低。對車載對話助理、嵌入式機器人,以及處理多模態資料的企業私有代理而言,這是不可或缺的特性。
評估 LFM3 的團隊,實際上最需要思考的是該在哪些情境、以何種方式取代雲端 API。LFM3 專為重視隱私、處理量與延遲穩定性勝過極致準確度的場景而設計,例如處理敏感資料的企業助理、受監管產業的地端自動化、AI PC 上的嵌入式感知系統,以及連線受限的邊緣設備。本文將探討部署模式、如何以單張 GPU 微調、相較雲端模型的效能取捨,以及遷移過程中需要管理的營運風險。