

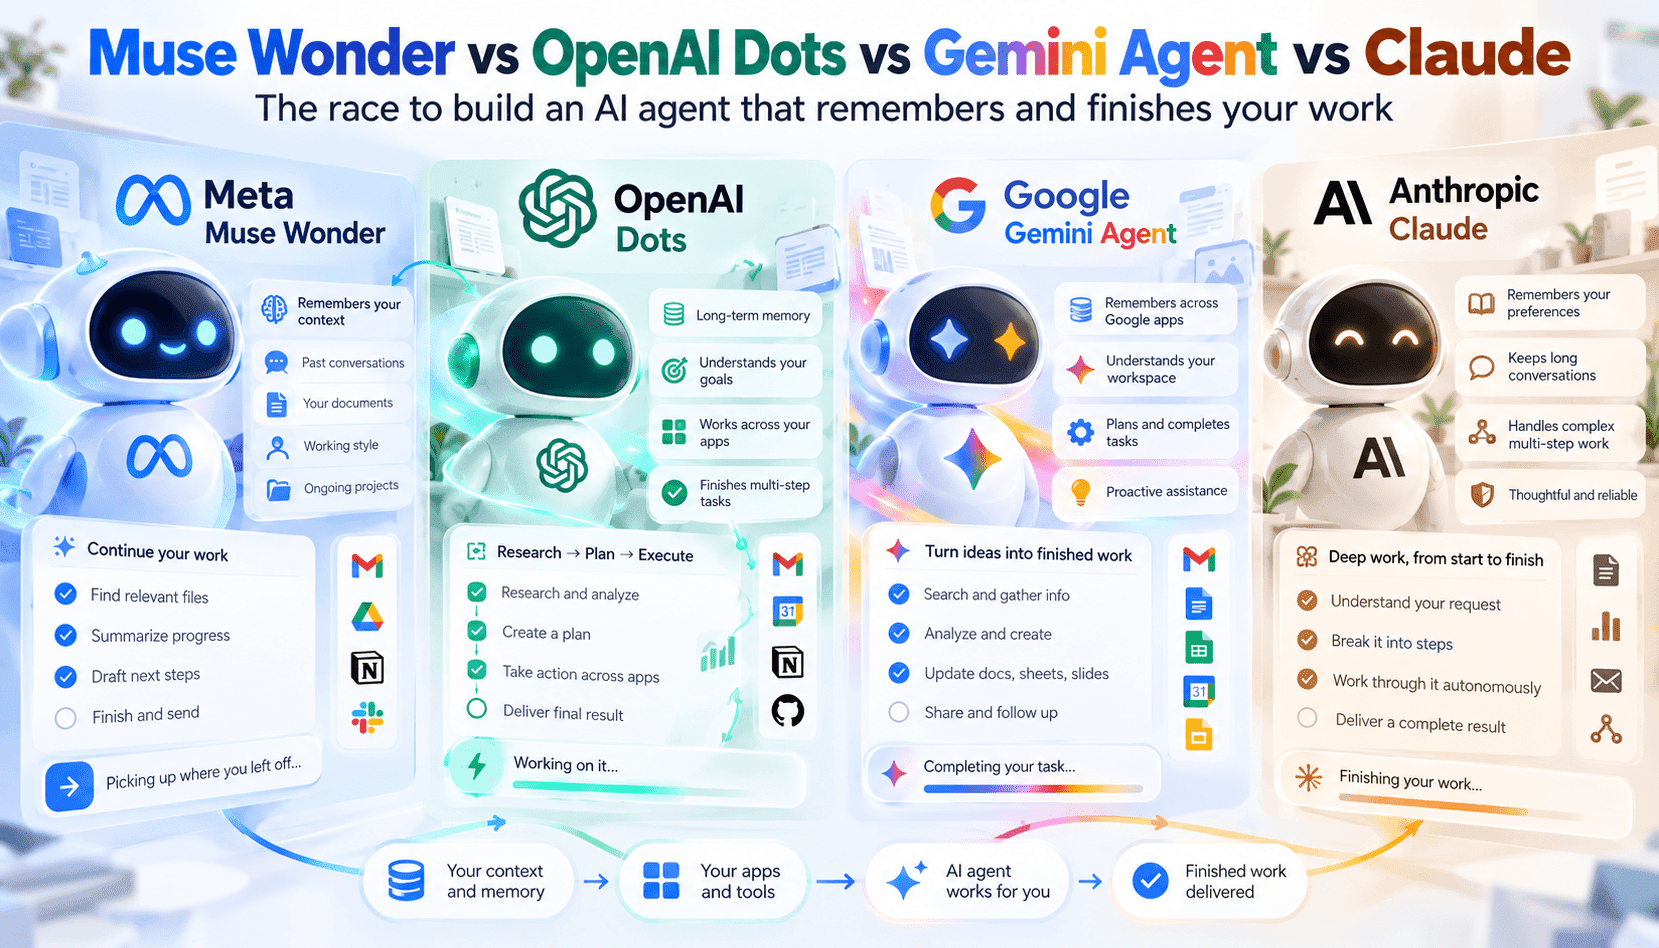
Meta 推出 Muse Wonder 值得關注,因為它將記憶與持續執行視為基本能力,而不是附加功能。Muse 將 Active Memory 定位為具範圍限制、能理解任務的儲存機制,並以 Active Focus 作為長期工作的持續執行模式,試圖彌合對話式助理與自主數位工作者之間的落差。對產品負責人而言,這帶來的實際意義很明確:新一代模型正促使供應商回答一系列營運問題——如何呈現記憶、誰能讀取或寫入記憶、如何落實核准機制,以及代理如何從中斷的任務中復原並接續執行。
比較 Muse、OpenAI Dots、Google Gemini Agent 與 Anthropic Claude,可以看出以能力為先與以治理為先的設計各有取向。OpenAI Dots 著重廣泛的工具組合能力與開發者體驗,擁有快速發展的工具生態系,也逐步加入持續性情境。Gemini 強調與 Google Workspace 及瀏覽器操作的深度整合,有利於以網頁為主的工作流程,但也帶來企業資料對應方面的疑問。Claude 優先考量安全性與可控的記憶模式,重視行為可預測性,而非積極追求自主性。Muse 則介於兩者之間,結合前沿程式設計能力與領域專業知識,並提供明確的記憶與復原機制。
從工程與治理的角度來看,這些差異至關重要。Muse 的 Active Memory 似乎是為選擇性保留資訊與任務範圍管理而設計;若能落實存取控制,就有助於降低資料外洩風險。OpenAI Dots 生態系讓開發者能靈活快速地串接工具,但整合與治理的責任大多仍落在採用者身上。Google 的優勢在於企業整合與具身分識別能力的工具;Anthropic Claude 則提供較保守的預設設定與更完善的安全檢查。團隊選擇平台時,必須權衡整合速度,以及存取控制與稽核軌跡是否清晰。
對採購者與建置者而言,眼前的抉擇不只是看哪個模型在基準測試中能力最強,更要看平台能否在跨越數天、不同訊息、行事曆事件、文件與第三方應用程式的任務中,持續展現可靠一致的行為。這代表必須測試多日任務流程、部分失敗後的復原、核准工作流程,以及大規模管理控制。本文接下來將剖析 Muse Wonder 帶來的改變、其他平台在實務上的比較、值得留意的營運風險,以及團隊在採購或規劃試行時可採用的實用檢核清單。