

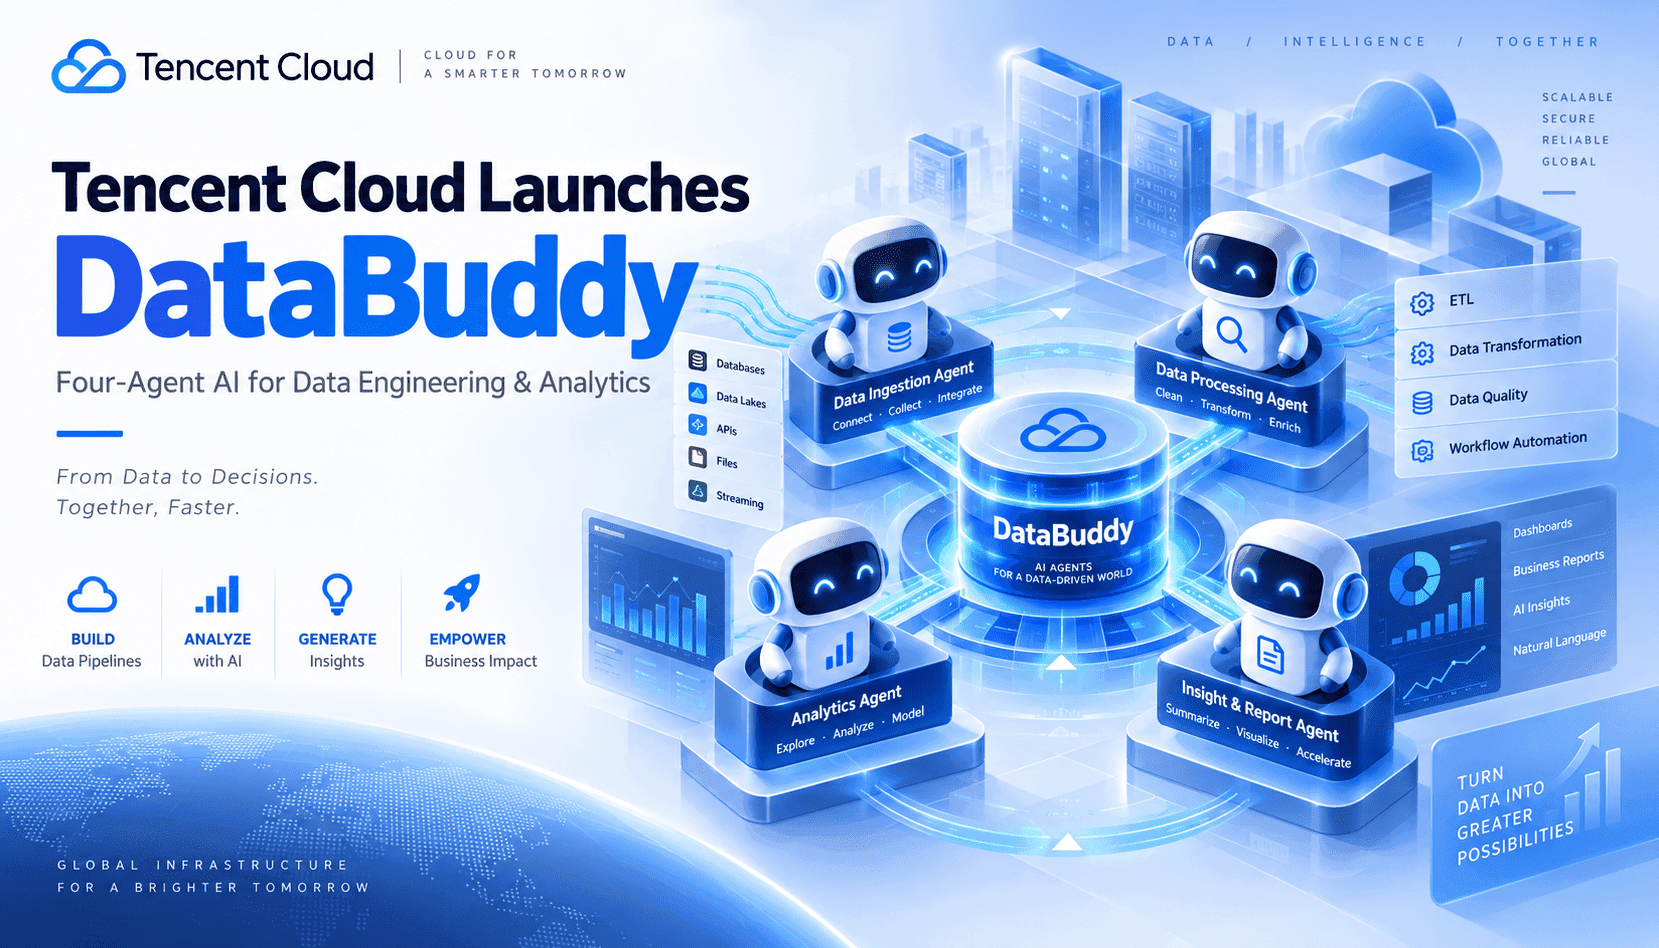
騰訊雲的 DataBuddy 將四代理人模式封裝成一項服務,專注解決企業數據最棘手的問題:緩慢且依賴工單的 ETL 和 BI 變更。DataBuddy 不再將請求交由過勞的工程師處理,而是協調代理人組裝管道、撰寫 SQL 並在治理規則下解釋結果。這種方法既有主見又務實:將例行數據工作編碼為代理人角色,像服務一樣衡量,並保留人工審核以確保存取、隱私和成本。這種轉變類似 DevOps 的成熟過程——工具、自动化和政策取代了英雄主義和電子表格。
在系統內部,一個代理人負責任務規劃,一個像數據工程師一樣生成連接器、轉換和 SQL,第三個作為分析師產出洞察和敘述,第四個則負責質量和政策合規審查。最後一個角色至關重要:它會在結果發佈到儀表板或筆記本前,檢查結構假設、連接、洩漏風險及個人識別信息(PII)暴露。若正確執行,日誌會記錄提示、決策、生成代碼和血緣,讓團隊能重現結果、回滾變更,並跨數據集比較代理人表現——這對信任和審計至關重要。
這套系統適合放在哪裡?可將 DataBuddy 視為位於湖倉與消費者之間的控制平臺。它應該補充現有的 Spark/SQL 作業、成本治理和目錄工具,而非取代。適用場景包括積壓嚴重的 BI 變更、必須遵守政策的臨時探索,以及重複的數據攝取或質量任務。企業級的開放問題包括:如何與身份認證、目錄和 VPC 網絡綁定;如何在表/欄位層級執行最小權限;以及如何分配計算資源以限制支出而不影響吞吐量。
決策框架:先在有限領域(如銷售運營或行銷歸因)、已知事實表和兩個可信維度中試點。定義通過/失敗標準:首次洞察時間、查詢準確度與標準 SQL 比較、捕捉的數據質量違規及每個成功任務的成本。將輸出導向現有儀表板,而非新孤島。保持人工審核以處理政策例外。若試點達標,透過新增數據產品擴展,而非隨機表格——將每個產品視為具備 SLA、血緣、測試和警報的合約,DataBuddy 代理人則作為執行層。