

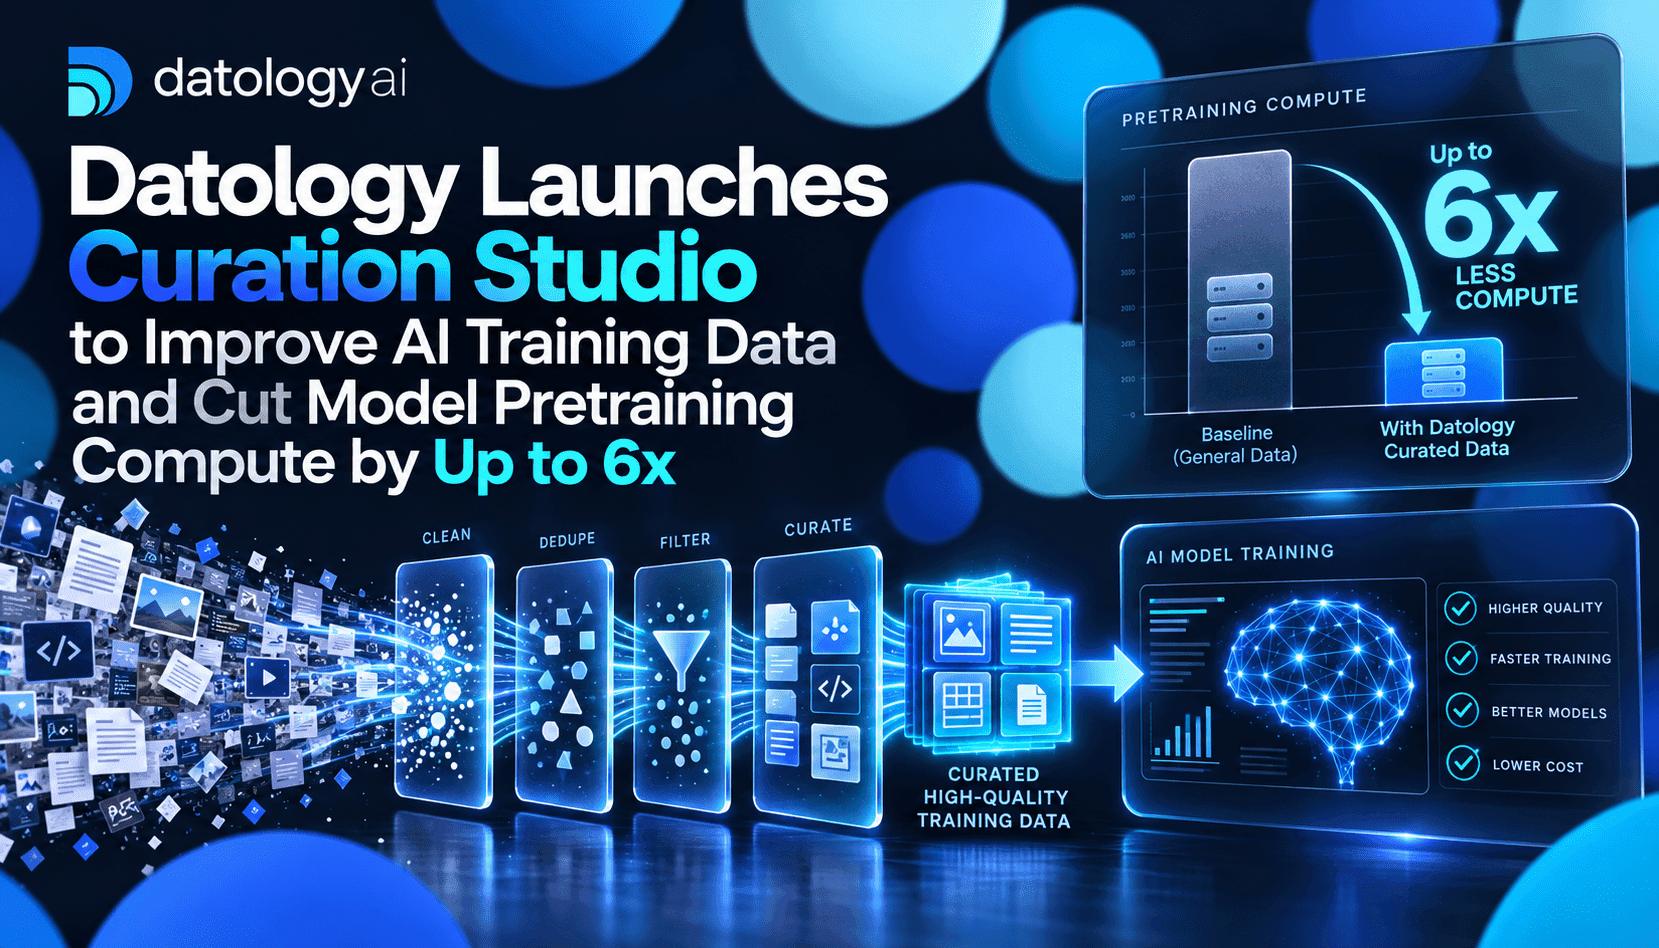
Datology 全新的 Curation Studio 定位为原始内容与模型训练之间的运营层。它不会一味摄入越来越多的 token,而是通过“清理、校准、生成、编排”四阶段流程,提取对你关注的任务最有价值的信息。Datology 的实验表明,与盲目增加预训练算力相比,策展训练数据能更高效地提升模型的实际表现。对于工程和产品团队来说,这意味着关注重点和预算投向都需要调整:从原始 GPU 时长转向数据生命周期工程和合成数据增强策略。
其技术核心在理念上并不陌生,真正的挑战在于规模化执行:严格去污染和启发式清洗、按文档评分与重新加权、基于高质量源示例生成合成数据,以及可配置的编排引擎——根据不同训练阶段混合各类数据子集。Datology 表示,他们的实验发现,使用经过策展的数据集训练的小模型,即使使用的 token 更少,也能达到或超过使用更多算力训练的大型基线模型。对实践者而言,这带来了直接的实际意义:可以用更智能的数据策展流程替代一部分预训练 FLOPs,并采用推理成本更低的小型模型提供服务。
要在企业规模落地前沿数据策展,需要应对不小的工程挑战。Datology 称,其流程涉及 PB 级数据管道、自定义算子图和大量中间缓存,以便处理数百 TB 乃至 PB 级的数据,同时避免成本或运行时间失控。这正是实验室研究与可在客户 VPC 中运行的产品之间的区别。对于正在评估自建专有模型的企业而言,这种产品模式意义重大:既能掌控数据、保留来源追溯能力,也无需将原始知识产权发送给外部服务,同时仍可受益于先进的数据策展技术。
商业价值主要体现在两个可衡量的结果上:单位预训练算力带来的模型表现,以及每项任务的推理成本。Datology 给出的案例中,使用较少 token 进行预训练的 12B 策展模型,胜过了算力消耗高得多的 30B 大型基线模型。这说明,数据策展有助于同时缩小高效生产模型的规模和训练预算。对决策者而言,结论十分明确:尽早投资数据工具和管道,并设计以算力归一化基线衡量表现的实验,而不是只看 token 数量。