

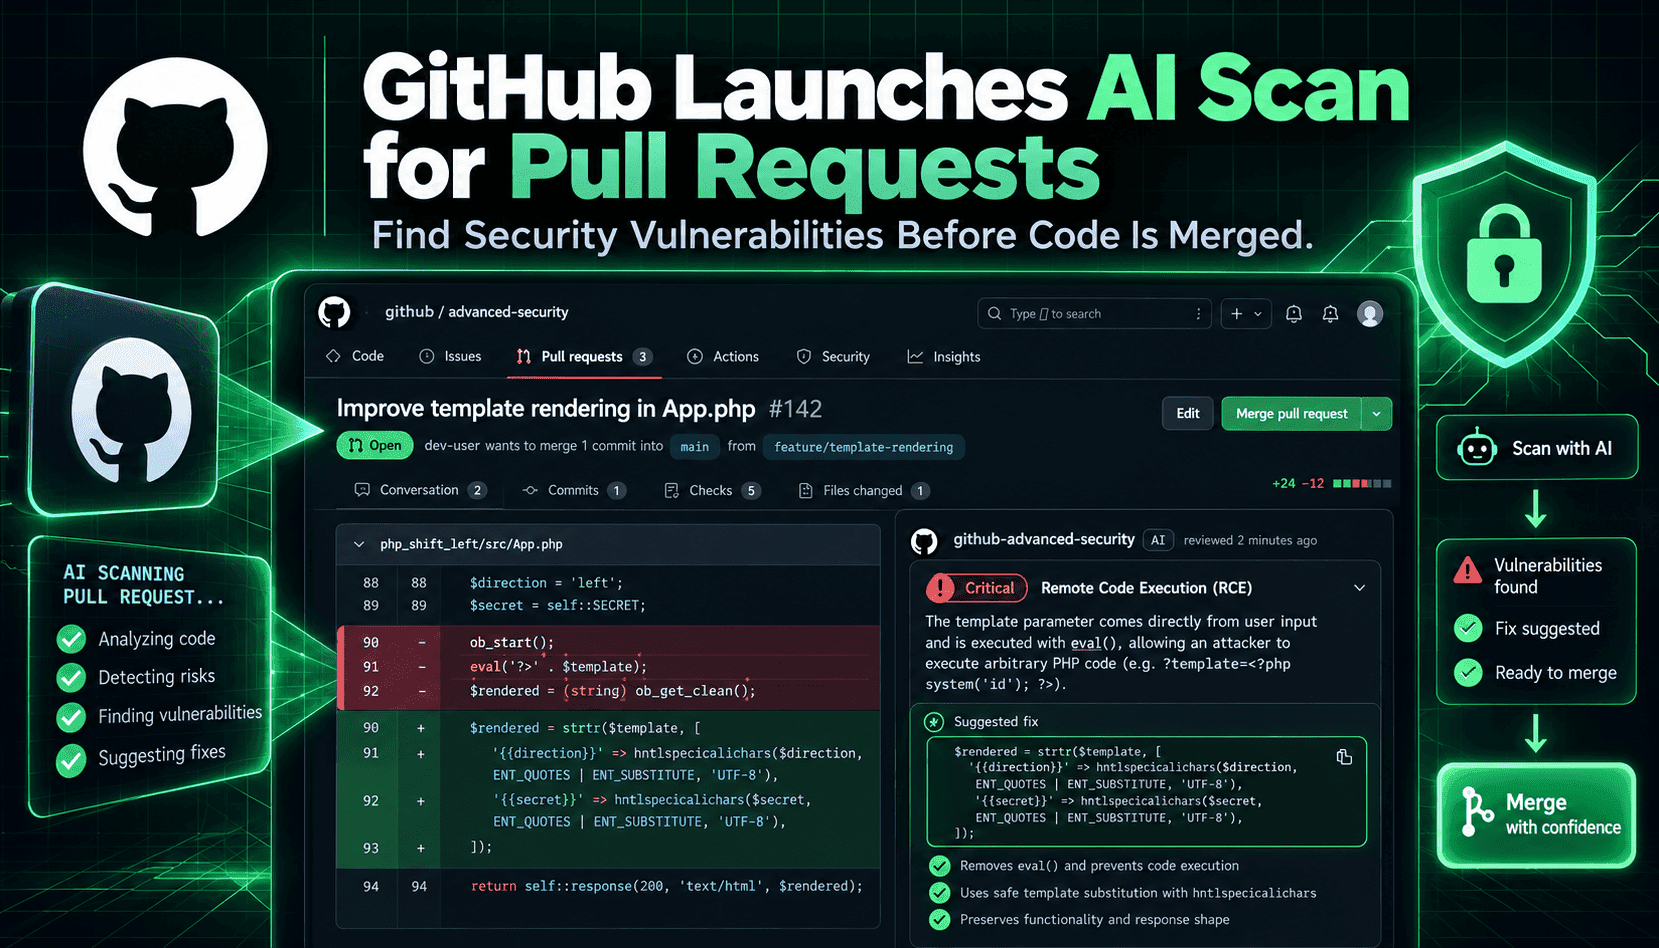
GitHub 宣布 Pull Request AI Scan 正式上线,这标志着代码安全融入日常开发流程的方式迎来了显著变化。AI Scan 并非取代 CodeQL 的确定性模式匹配,而是针对特定 Pull Request 的上下文应用专门训练的模型,包括变更行、周边代码和代码库结构。借助这种上下文视角,它能够提出安全问题及自动修复建议,覆盖 CodeQL 尚未支持的语言和文件,例如 PHP、Shell、Terraform HCL、Dockerfile、JSP 和 Blazor。对于快速交付的团队而言,这种组合有望更早发现缺失的合理性检查、不安全的默认设置,或静态规则难以捕捉的部署配置错误。
在实际运行中,启用代码扫描和代码库的 AI Scan 设置后,AI Scan 就会执行;结果会与 CodeQL 的结果一同显示在 Conversation 和 Files changed 标签页中,并明确标注“AI”。需要注意的是,扫描结果仅供参考:它们不会导致代码扫描检查失败,也无法通过规则集阻止合并。这一设计表明,GitHub 希望加快反馈速度,但不设置硬性门槛,最终判断仍由开发者做出。对组织而言,这也带来一些设计问题:如何将 AI 提示纳入分流流程、何时要求人工签核,以及如何让 AI 生成的自动修复符合现有 CI/CD 流程和安全策略。
从技术角度看,AI 辅助扫描与传统静态分析在实践中有三点区别。第一,模型可以跨文件整合上下文,并根据代码模式和注释推断意图,而不只是依赖语法规则。第二,模型可以提出切实可行的修复方案——也就是自动修复;这些方案会考虑代码上下文,但本质上仍具有概率性。第三,它能够覆盖尚无成熟查询库支持的语言和配置格式。这些优势也带来了不同的失效风险:修复建议可能凭空捏造、漏掉边界情况,或提出过于宽泛的结论。因此,在将 AI 扫描结果视为权威结论之前,必须做好验证,并建立可重复执行的人工参与流程。
在实践中,团队应将 AI Scan 视为分层安全策略中的一项新信号。可以利用它更早发现潜在问题,为 PR 讨论补充解释,并通过自动关闭规则,加快处理噪声较多、风险较低的问题。对于身份验证、授权、密码学和注入路径等高风险发现,应要求人工确认,并结合 CodeQL、SAST 工具和 Pull Request 测试进行交叉验证。监控也很重要:记录 AI Credit 用量,为自动修复保留审计轨迹,并跟踪误报,以便通过代码库级设置调整模型行为或限制其适用范围。