

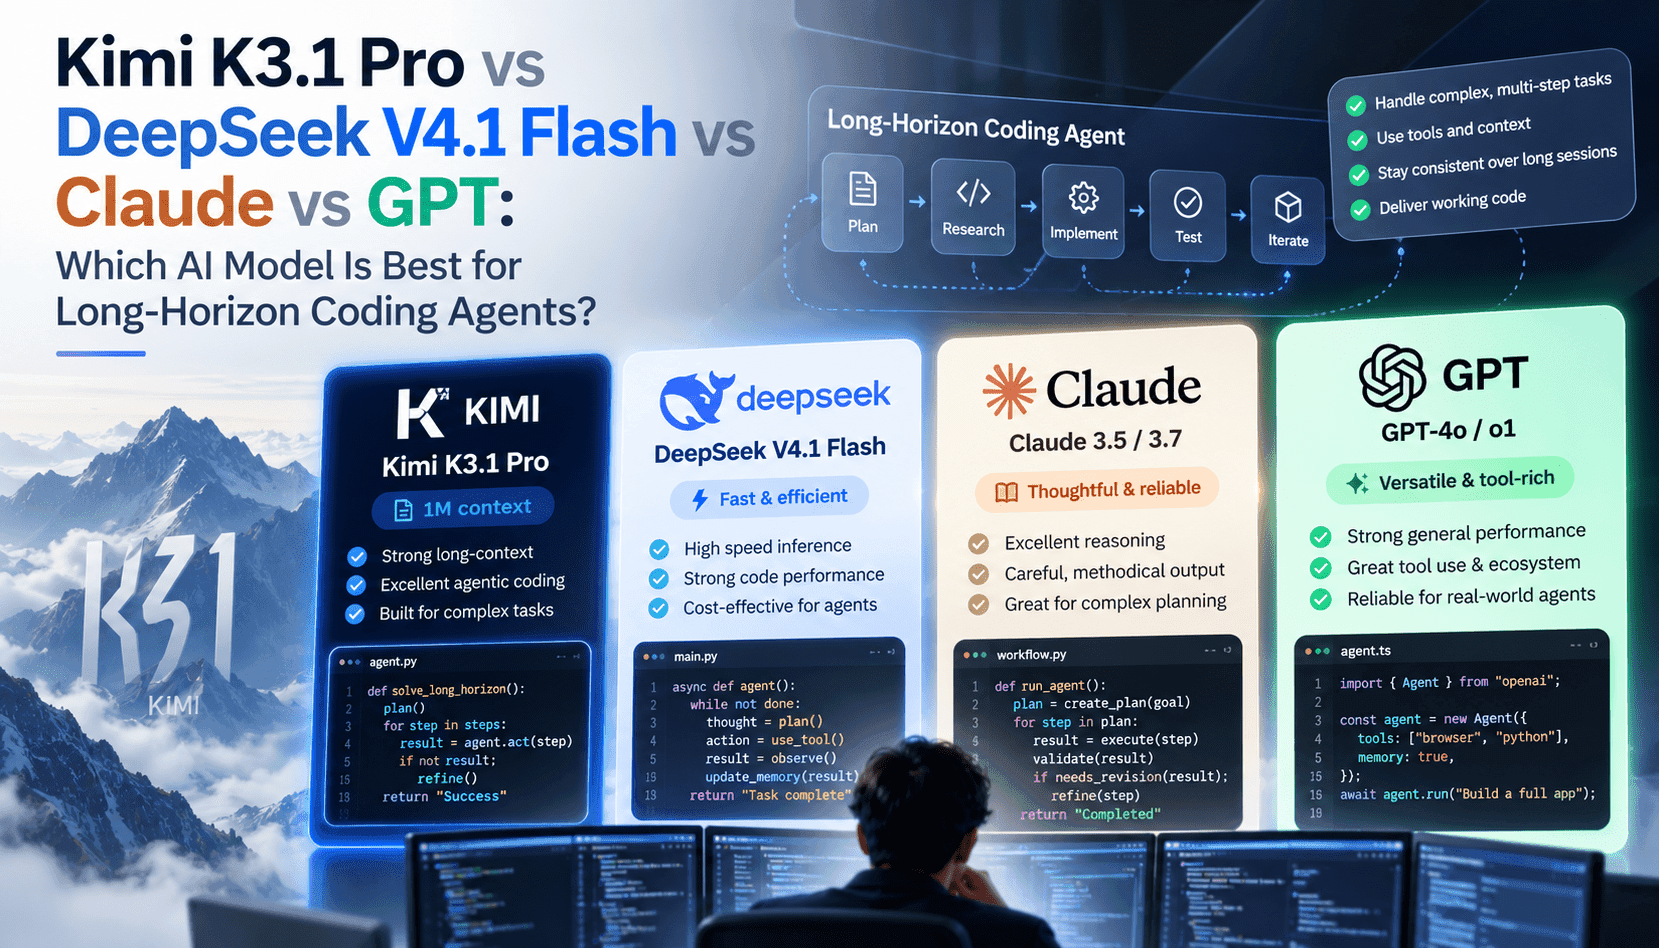
长周期编码智能体的评估标准,与单轮代码补全截然不同。它们需要在多次工具调用中持续推理、跨会话可靠缓存状态、高效处理增量更新,并确保每项开发任务的成本可预测。Kimi K3.1 Pro 的 100 万 token 上下文窗口和思考模式原语,正是为这种工作流设计的;DeepSeek Flash 版本侧重低延迟和高吞吐流式处理;Claude 强调安全性与可控推理;GPT 系列模型则拥有广泛的生态系统,且往往提供一流的对话式工具链。对工程团队而言,关键不是哪款模型客观上“最好”,而是哪款最适合团队的代码库规模、CI/CD 节奏、预算情况和风险承受能力。
将模型特性与智能体工作流对应起来,实际取舍就会变得清晰。当智能体需要结合多个模块的历史记录、篇幅很长的设计文档和累积的工具输出进行推理时,100 万 token 的上下文会很有帮助,例如涉及多个 PR 的重构或跨代码库迁移。但只有通过选择性压缩上下文、检索增强提示和会话缓存策略,避免发送无关 token,这种能力才能真正发挥作用。更快的推理(如 K3.1 Pro Highspeed 或 DeepSeek Flash)可以缩短实际耗时,减少开发者等待;但要判断更快的模型能否真正降低生产环境的运营成本,还得看每 token 成本、批处理规模和 I/O 开销。
开放权重模型改变了部署的成本权衡:团队可以在私有硬件上运行智能体、掌控遥测数据并避免供应商锁定,但也必须承担运维负担,例如服务延迟、长上下文分片,以及持续更新安全过滤机制。专有前沿模型则能节省开发时间:更出色的开箱即用推理能力、集成工具生态和托管防护措施,都能减少工程投入。正确的选择取决于组织的优先事项:是更看重数据隐私和本地部署的低延迟,还是希望减少集成工作,并依靠服务提供商的 SLA 获得安全更新和模型改进。
除了原始能力,还要评估模型在多工具智能体中的表现:是否支持确定性的工具调用规范、结构化思考模式、工具输出流式传输和权限审批?Kimi 的思考模式和会话控制旨在减少长流程中的幻觉;DeepSeek Flash 的性能有助于降低紧凑 CI 循环中的超时;Claude 的安全优先启发式机制适合合规要求严格的企业;GPT 系列模型则受益于丰富的生态连接器和第三方编排框架。还应权衡各模型的集成难度、可审计性,以及工具在计划执行中途发生故障时的恢复能力。