

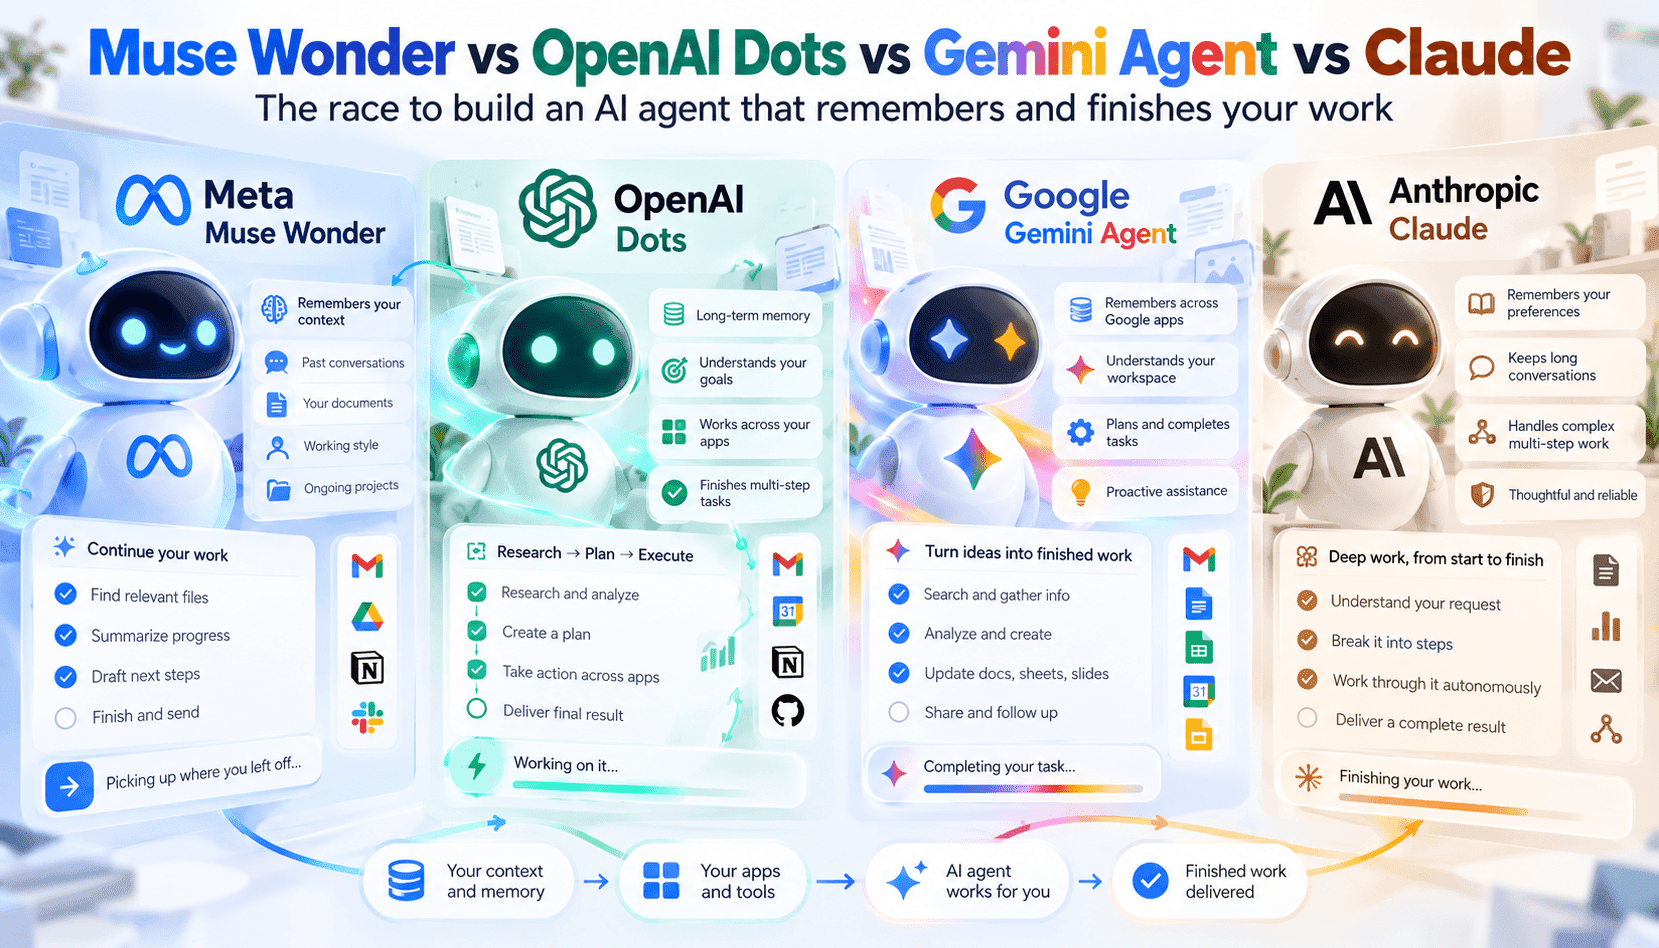
Meta 发布 Muse Wonder 值得关注,因为它将记忆和持续执行任务视为核心能力,而不是附加功能。Muse 将 Active Memory 定义为按范围划分、理解任务的存储机制,将 Active Focus 作为持续处理长期任务的模式——这些功能旨在弥合对话式助手与自主数字员工之间的差距。对产品负责人而言,这一代模型带来的实际影响很明确:供应商必须回答一系列运营层面的问题——记忆如何呈现、谁有权读取或写入、如何落实审批,以及智能体如何从中断的任务中恢复并继续执行。
将 Muse 与 OpenAI Dots、Google Gemini Agent 和 Anthropic Claude 进行比较,可以看到两种路线:以能力为先和以治理为先。OpenAI Dots 注重广泛的工具组合能力和开发者体验,工具生态发展迅速,持久上下文能力也在不断完善。Gemini 强调与 Google Workspace 和浏览器操作的深度集成,有利于以网页为核心的工作流,但也带来了企业数据映射方面的问题。Claude 优先考虑安全性和可控的记忆模式,倾向于保持行为可预测,而不是追求激进的自主性。Muse 则位于两者之间,将前沿编程能力和领域专业知识,与明确的记忆和恢复机制结合起来。
从工程和治理角度看,这些差异至关重要。Muse 的 Active Memory 似乎专为选择性持久化和任务范围管理而设计;如果落实访问控制,这有助于降低信息泄露风险。OpenAI Dots 生态让开发者能够灵活、快速地串联各种工具,但集成和治理责任很大程度上仍由采用者承担。Google 的优势在于企业集成和基于身份的工具;Anthropic Claude 则提供更审慎的默认设置和更完善的安全检查。选择平台时,团队需要权衡集成速度,以及访问控制和审计轨迹是否清晰。
对采购方和开发者来说,眼下要决定的并不只是哪个模型在基准测试中能力最强,而是平台能否确保任务跨越数天、涉及多条消息、日历事件、文档和第三方应用时,依然稳定、可重复地执行。这意味着要测试跨多日的任务流程、部分故障后的恢复、审批工作流,以及大规模场景下的管理控制。下文将解析 Muse Wonder 带来的变化、其他平台在实际使用中的表现、需要留意的运营风险,以及团队在采购或试点规划中可以采用的实用清单。