

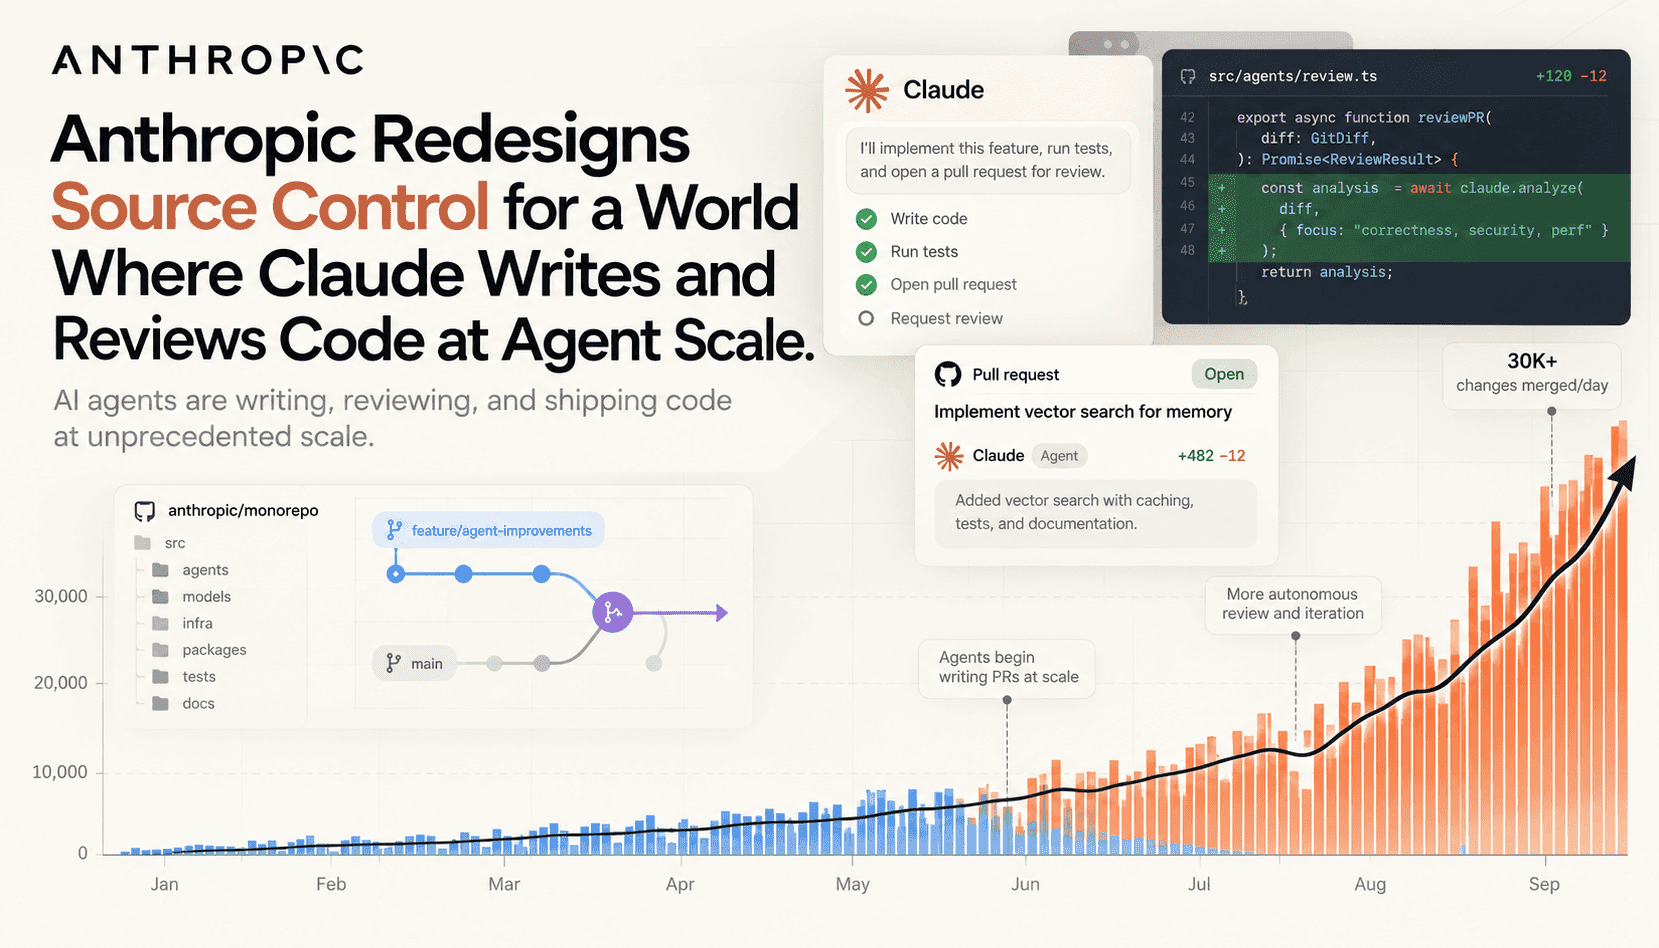
Anthropics Wechsel von Git zu einem maßgeschneiderten System namens Scion war eine strukturelle Reaktion auf einen betrieblichen Wendepunkt: Autonome Agenten, allen voran Claude, begannen täglich Zehntausende Änderungen zu erzeugen und zusammenzuführen. Damit gerieten Annahmen ins Wanken, auf denen Werkzeuge für menschliche Arbeitsabläufe beruhen. Das Unternehmen stellte fest, dass dezentrale Konzepte – vollständige Klone, Austausch über Packfiles und lokale Referenzen – zum Nachteil wurden, sobald die meisten Clients ständig verfügbare Agenten waren, die nur Teile eines Repositorys benötigten. Scion fasst das Problem neu: Im Mittelpunkt stehen Metadaten mit hohem Durchsatz auf dem Server und die gezielte Bereitstellung einzelner Dateien. Das hat Folgen dafür, wie Teams Pipelines gestalten, Zustände überwachen und Änderungen prüfen.
Im Kern ersetzt Scion Git-Operationen auf dem vollständigen Graphen durch serverseitige Changesets und daraus abgeleitete Indizes. Statt unveränderliche Packfiles an jeden Client zu übertragen, stellt Scion inhaltsadressierte Blobs, gezielte Tree-Abfragen und Server-APIs für Blame, Abstammung und Diffs bereit. Eine Arbeitskopie ist optional: CI- und Research-Jobs können Metadaten direkt beim Server abfragen oder nur die tatsächlich benötigten Pfade materialisieren. Dadurch sinken Netzwerk-, CPU- und Speicherbedarf drastisch. Außerdem lassen sich Commits schnell und ohne Sperren erstellen – unerlässlich, wenn die Zahl der täglichen Merges um eine Größenordnung steigt.
Im Betrieb erfordert dieser Wechsel ein Umdenken bei den Werkzeugen: CI, Code-Reviews, IAM und Observability müssen von einer serverzentrierten Versionsverwaltung ausgehen. Abrufe und Builds werden zu cachegesteuerten Lesezugriffen auf gestaffelte Server statt zu umfangreichen Klonvorgängen von Spiegelservern. Abgeleitete Daten – etwa Blame-Indizes, Pfadverläufe und Skip-Listen – müssen schrittweise berechnet und gespeichert werden. Die Entscheidung zwischen eager und lazy Berechnung wirkt sich unmittelbar auf Latenz, Speicherbedarf und Betriebskosten aus. Teams müssen den Start von Jobs, die lokale Entwicklererfahrung und die Kapazitätsplanung neu ausrichten: auf Objekt-Caches, fortsetzbare Abrufe und regionale Isolation.
Für Engineering-Verantwortliche stellen sich sofort praktische Fragen: Wie lässt sich Agenten-generierter Code in großem Maßstab vertrauenswürdig machen? Wie werden Richtlinien instrumentiert und durchgesetzt? Und wie verhindert man, dass ein zentraler Koordinationsengpass entsteht? Anthropics Erfahrung zeigt, dass sich diese Herausforderungen mit einer Kombination aus serverseitiger Richtliniendurchsetzung, programmatischen Review-Oberflächen, adversarialen Validierungspipelines und einem zurückhaltenden Umgang mit Referenzen bewältigen lassen. Die technischen Abstriche – weniger lokale Autonomie, mehr zentrale Rechenleistung und zusätzlicher Aufwand für die Pflege abgeleiteter Daten – werden durch enorme Gewinne bei Geschwindigkeit, Reproduzierbarkeit und dem Betrieb im Agentenmaßstab aufgewogen.