

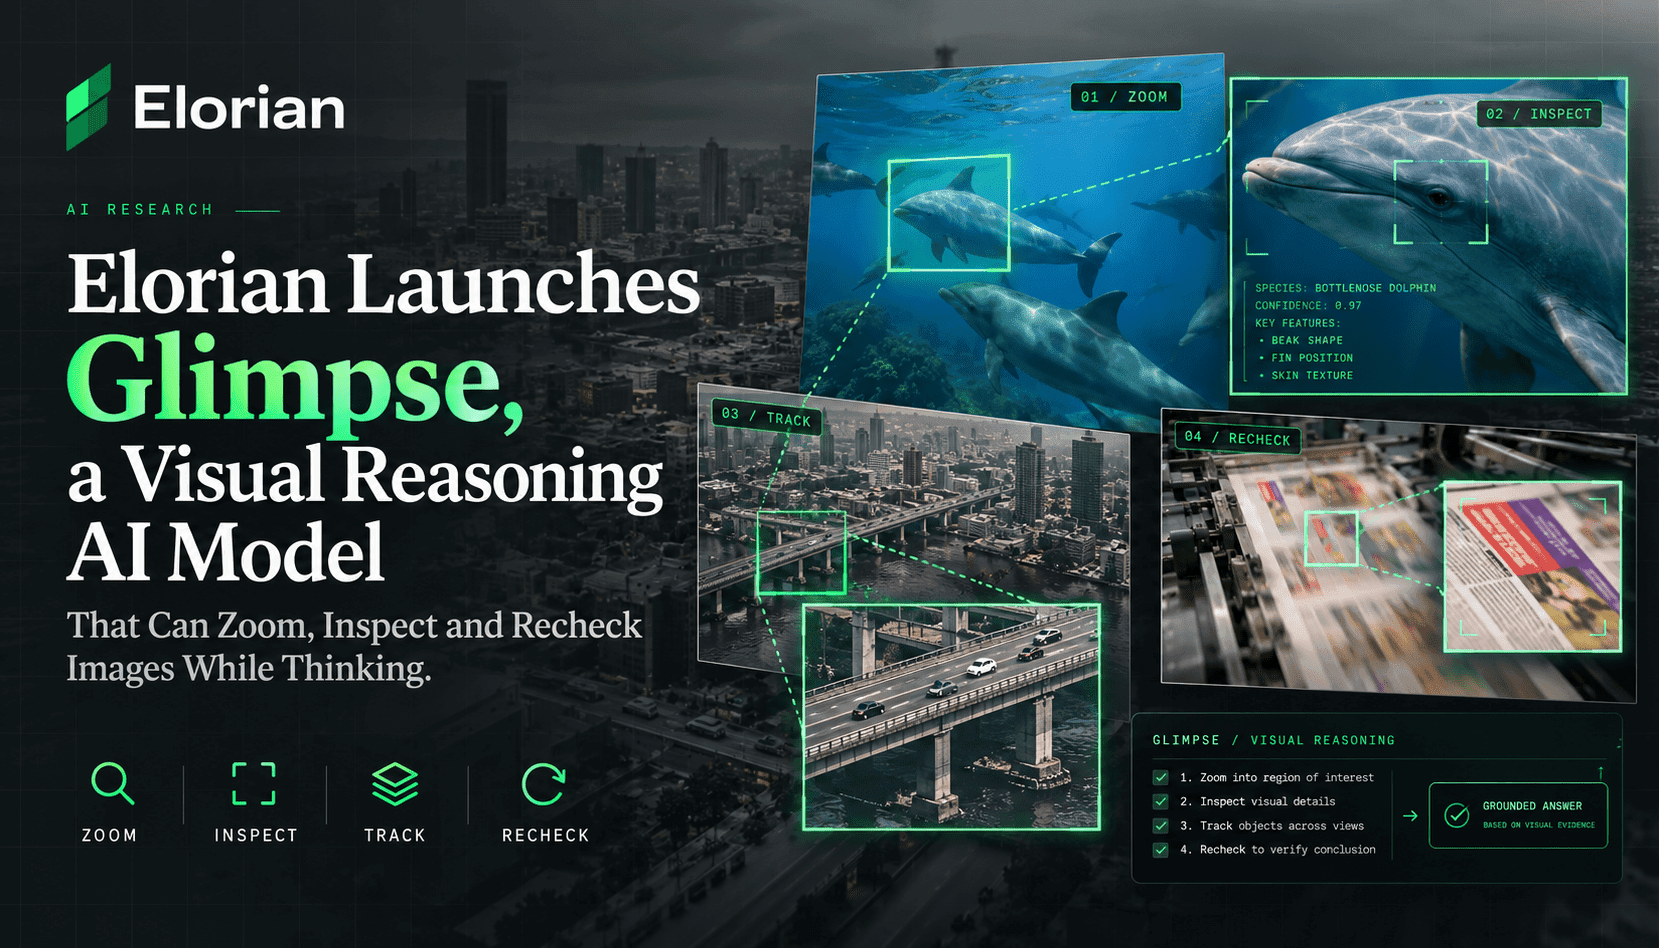
Elorians Glimpse markiert einen bewussten Kurswechsel darin, wie multimodale Systeme visuelle Eingaben verarbeiten. Statt ein Bild oder Video zu einer einzigen latenten Tokenfolge zu verdichten und auf Grundlage dieser eingefrorenen Zusammenfassung zu schlussfolgern, bewahrt Glimpse einen bearbeitbaren „visuellen Denkraum“, den das Modell während mehrstufiger Überlegungen erneut heranziehen kann. Konkret kann es Bildbereiche zuschneiden, für bestimmte Zeitabschnitte mehr Einzelbilder anfordern, die Pixel eines Objekts über die Zeit verfolgen oder kurze Code-Snippets ausführen, die visuelle Zwischenergebnisse erzeugen. So ist das Modell weniger auf fehleranfällige Wahrnehmung in einem einzigen Durchgang angewiesen und kommt besser mit mehrdeutigen oder dynamischen Szenen zurecht.
Aus Systemsicht besteht die zentrale technische Abwägung zwischen Rechenaufwand und Tokenbudget auf der einen und fundierter Genauigkeit auf der anderen Seite. Glimpses Design setzt bewusst zusätzliche Inferenzressourcen ein, um Belege erneut zu prüfen, statt bei einem Ansatz mit nur einem Durchgang aus dem Gedächtnis zu raten. Elorian zufolge erzielt diese gründliche Prüfung bessere Ergebnisse bei Aufgaben, die eine konstante Identitätszuordnung, zeitliches Schlussfolgern und präzises Zählen erfordern. Bei ausgewählten Benchmarks könne die Leistung mit deutlich größeren Spitzenmodellen mithalten oder sie übertreffen. Für Teams spricht das besonders dort für Glimpse, wo visuelle Genauigkeit, Nachvollziehbarkeit und schrittweise Überprüfung wichtiger sind als maximaler Durchsatz.
Die Einführung von Glimpse erfordert Abwägungen auf Produkt- und Forschungsebene: Man erhält ein Modell, das anhand visueller Belege schlussfolgert, muss dafür aber eine komplexere Orchestrierung in Kauf nehmen – etwa die Verwaltung abgetasteter Einzelbilder und von Denkraum-Artefakten sowie potenziell höhere Tokenkosten pro Sitzung. Elorians veröffentlichte Preise pro Token liegen deutlich unter denen mehrerer Spitzenmodelle. Das Unternehmen weist jedoch selbst darauf hin, dass das Modell bei gründlichem Nachdenken mehr Tokens verbraucht. Kurz gesagt: Glimpse verspricht eine bessere Belegkette und weniger Wahrnehmungsfehler bei bestimmten Aufgaben. Teams müssen jedoch Latenz, Kosten pro Entscheidung und Integrationsaufwand im Gesamtsystem messen, um einen Wechsel zu rechtfertigen.
Für Einkäufer und Entwickler liegt die praktische Schlussfolgerung auf der Hand: Glimpse eignet sich für Arbeitsabläufe, in denen die erneute Prüfung visueller Belege ein Vorteil und kein Fehler ist. Setzen Sie es zur Überprüfung von Robotern, zur Interpretation von Labordiagrammen, für die Qualitätssicherung in der Fertigung und für detaillierte Videobeschreibungen ein – überall dort, wo falsch-positive Ergebnisse oder verlorene Objektidentitäten teuer sind. Für die massenhafte, wenig kritische Verschlagwortung oder bei besonders hohen Latenzanforderungen kann ein herkömmliches multimodales Modell mit nur einem Durchgang weiterhin die bessere Wahl sein, bis die Token-Effizienz weiter steigt.