

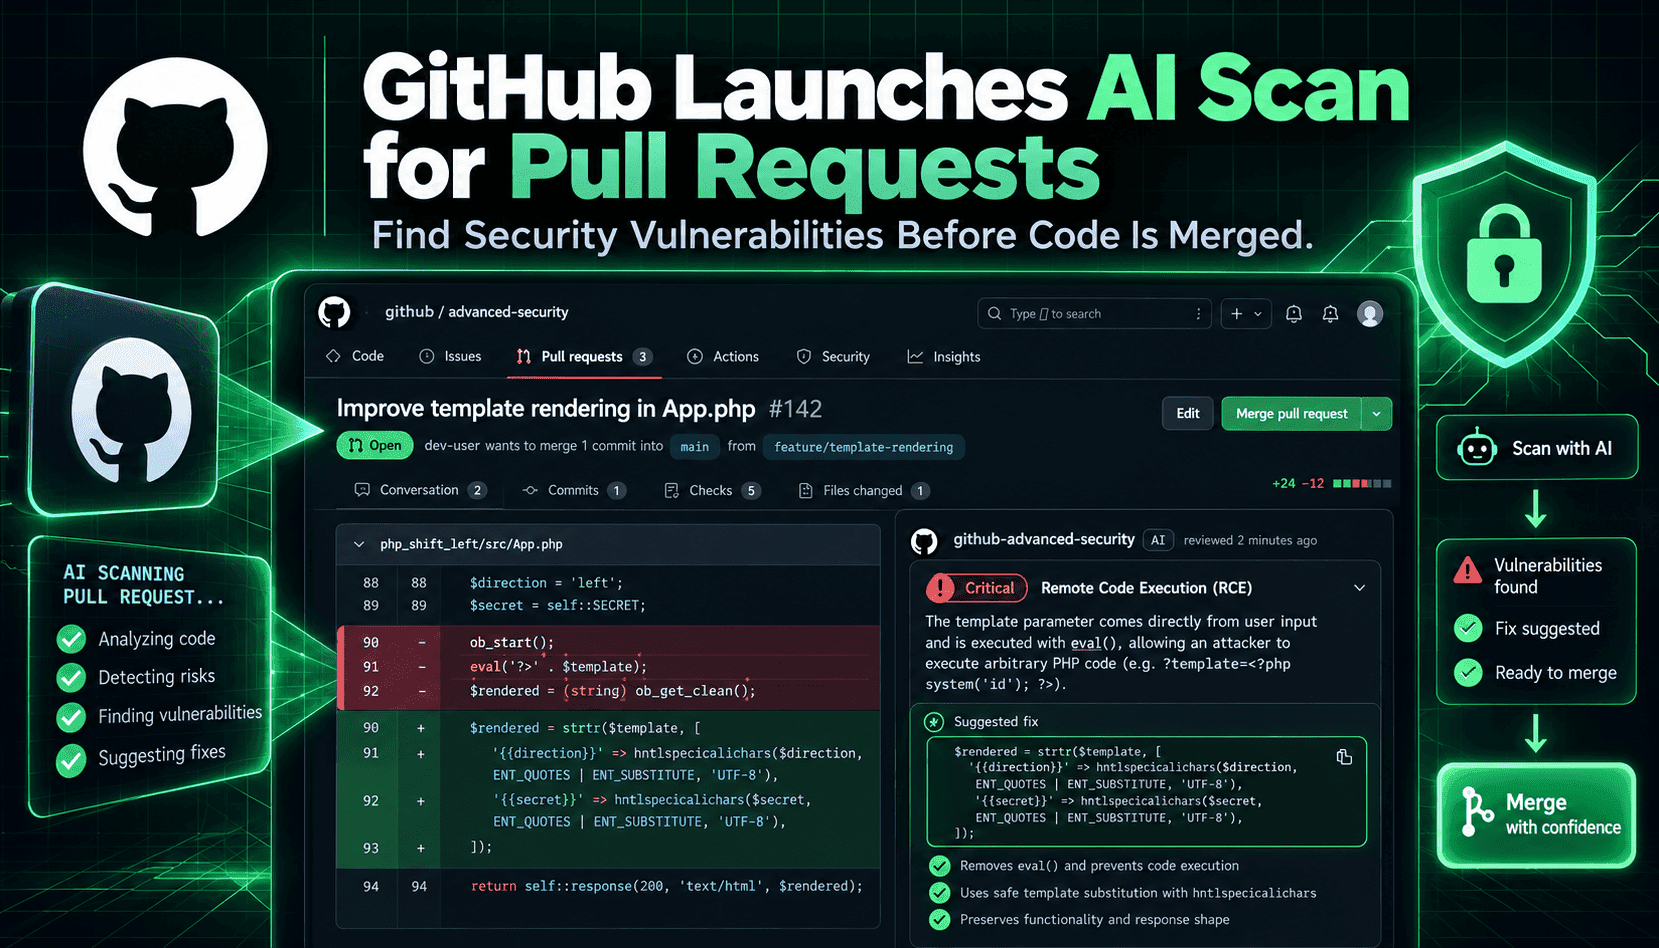
GitHubs Ankündigung, dass AI Scan für Pull Requests nun allgemein verfügbar ist, markiert einen bemerkenswerten Wandel bei der Integration von Codesicherheit in den Entwicklungsalltag. Statt die deterministische Mustererkennung von CodeQL zu ersetzen, wenden speziell entwickelte Modelle von AI Scan ihr Wissen auf den konkreten Kontext eines Pull Requests an: auf geänderte Zeilen, den umgebenden Code und die Struktur des Repositorys. Dank dieses Kontextverständnisses kann das Tool potenzielle Probleme erkennen und sogar automatische Korrekturen vorschlagen – auch in Sprachen und Dateiformaten, die CodeQL bislang nicht abdeckt, etwa PHP, Shell, Terraform HCL, Dockerfiles, JSP und Blazor. Für Teams, die schnell ausliefern, verspricht diese Kombination eine frühere Erkennung fehlender Plausibilitätsprüfungen, unsicherer Standardeinstellungen und Fehlkonfigurationen, die erst bei der Bereitstellung zum Problem werden und statische Regeln allein möglicherweise übersehen.
Im Betrieb läuft AI Scan, wenn Code Scanning und die entsprechende Repository-Einstellung aktiviert sind. Die Ergebnisse erscheinen zusammen mit CodeQL in den Tabs „Conversation“ und „Files changed“ und sind deutlich mit einem „AI“-Hinweis gekennzeichnet. Wichtig ist: Die Ergebnisse dienen lediglich als Empfehlungen. Sie lassen die Code-Scanning-Prüfung nicht fehlschlagen und können Zusammenführungen nicht über Regelwerke blockieren. Damit signalisiert GitHub, dass das Feedback beschleunigt werden soll, ohne harte Schranken einzuführen – die endgültige Entscheidung bleibt bei den Entwicklerinnen und Entwicklern. Für Unternehmen wirft das wichtige Fragen auf: Wie fließen unverbindliche KI-Ergebnisse in die Triage ein? Wann ist eine menschliche Freigabe erforderlich? Und wie lassen sich KI-generierte automatische Korrekturen mit bestehenden CI/CD- und Sicherheitsrichtlinien in Einklang bringen?
Technisch unterscheidet sich KI-gestütztes Scanning in drei Punkten von herkömmlicher statischer Analyse. Erstens können Modelle Zusammenhänge über mehrere Dateien hinweg herstellen und Absichten aus Code-Mustern und Kommentaren ableiten, statt sich ausschließlich auf Syntaxregeln zu stützen. Zweitens können sie pragmatische, codebezogene Korrekturen vorschlagen, deren Ergebnisse jedoch probabilistisch sind. Drittens decken sie Sprachen und Konfigurationsformate ab, für die es keine ausgereiften Abfragebibliotheken gibt. Diese Stärken bringen auch eigene Fehlerrisiken mit sich: erfundene Korrekturen, übersehene Sonderfälle oder zu weitreichende Behauptungen. Deshalb sind Überprüfungen und wiederholbare Abläufe mit menschlicher Kontrolle unverzichtbar, bevor KI-Ergebnisse als verlässlich gelten können.
In der Praxis sollten Teams AI Scan als zusätzlichen Hinweis innerhalb einer mehrschichtigen Sicherheitsstrategie nutzen. So lassen sich wahrscheinliche Probleme früher erkennen, PR-Diskussionen um Erklärungen ergänzen und die Triage unkritischer, wenig riskanter Meldungen durch automatisierte Ausschlussregeln beschleunigen. Bei schwerwiegenden Risiken – etwa in den Bereichen Authentifizierung, Autorisierung, Kryptografie oder Injection-Pfade – sollten Teams eine menschliche Bestätigung sowie Gegenprüfungen mit CodeQL, SAST-Tools und Pull-Request-Tests verlangen. Auch die Protokollierung ist wichtig: AI-Credit-Verbrauch erfassen, für automatische Korrekturen Prüfpfade führen und falsch positive Ergebnisse nachverfolgen, damit sich das Modellverhalten anpassen oder der Umfang über Einstellungen auf Repository-Ebene begrenzen lässt.