

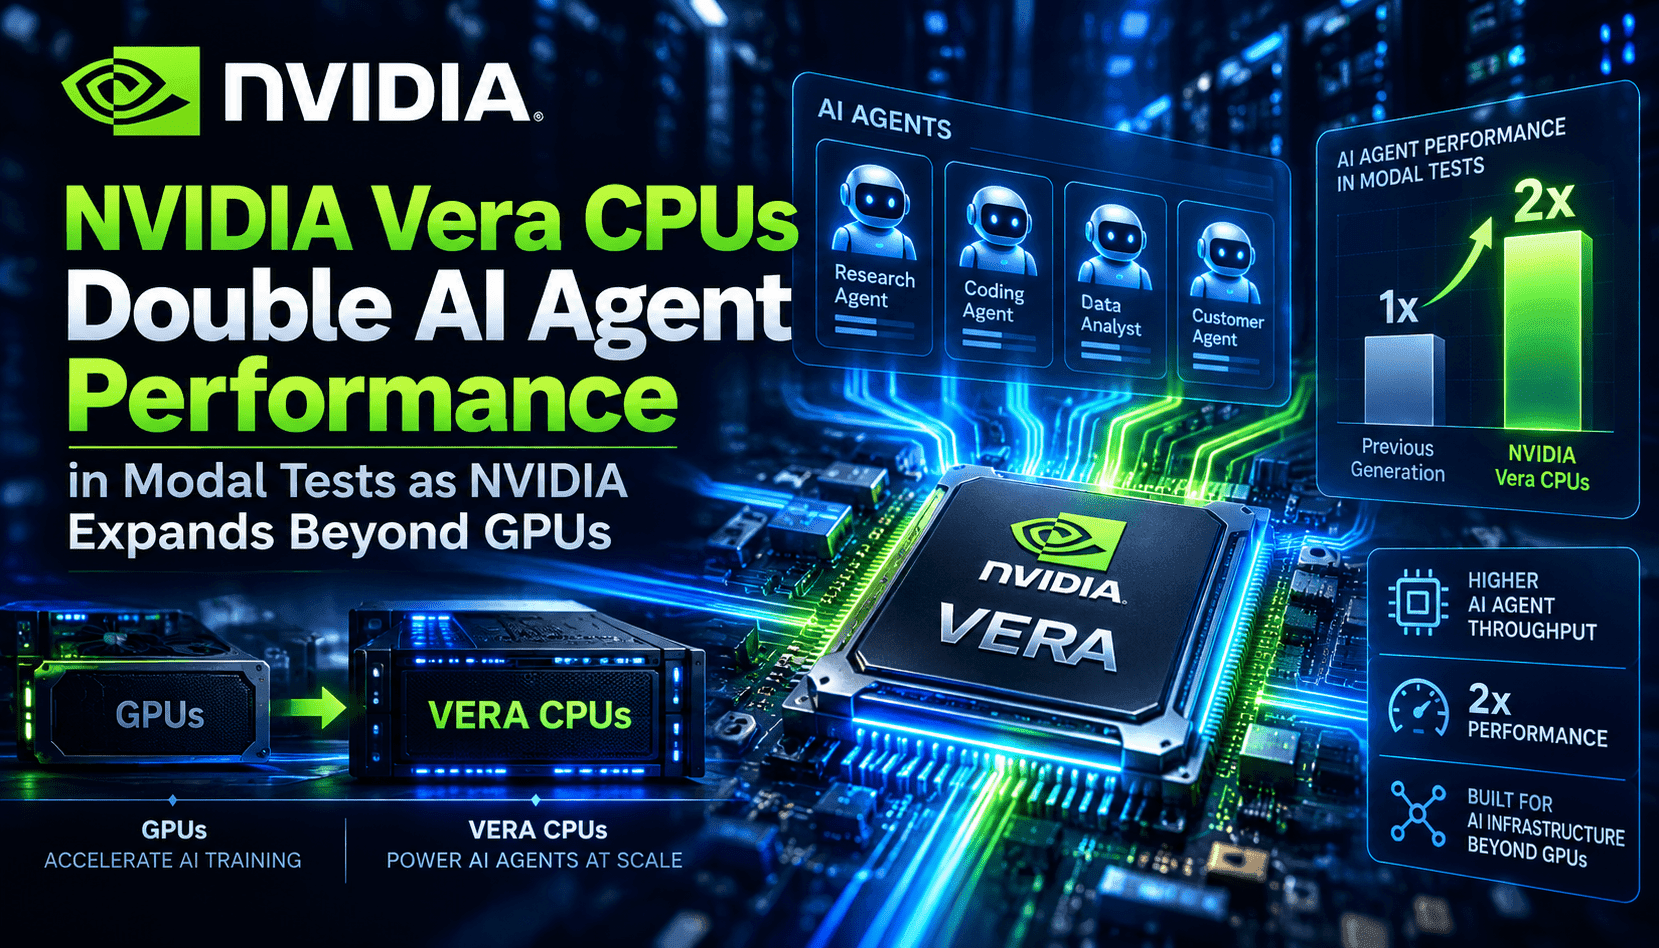
Erste Infrastrukturtests von Modal mit dem NVIDIA-Vera-Prozessor zeigen Berichten zufolge bei lang laufenden KI-Agenten ungefähr die doppelte Aufgabenleistung vergleichbarer Intel- und AMD-Systeme. Diese Agenten verbringen viele Zyklen damit, Tools zu orchestrieren, Kontextfenster zu verwalten, Daten zu serialisieren und zu deserialisieren sowie zwischen GPU-Aufrufen bedingte Logik auszuführen. Bei solchen gemischten Workloads sind CPU-Mikroarchitektur, Speicherdurchsatz und System-E/A-Latenz wichtiger als die reine FP-Leistung der GPU. Das Ergebnis von Modal ist kein allgemeingültiger Benchmark. Es deutet jedoch darauf hin, dass sich der End-to-End-Durchsatz von Agenten deutlich steigern lässt, wenn ein Teil der leistungsrelevanten Arbeit wieder auf eine moderne CPU verlagert wird.
CPUs gewinnen bei Agenten-Workloads wieder an Bedeutung, weil diese Systeme nicht einfach nur umfangreiche Matrixmultiplikationen ausführen: Sie verwalten Ereignisschleifen, koordinieren mehrstufige Schlussfolgerungen, übernehmen Abruf und Anreicherung von Informationen und binden Tools ein. Dabei entstehen zahlreiche kleine, latenzempfindliche Vorgänge und unvorhersehbare Speicherzugriffe. Hier zählen Single-Thread-Leistung, Cache-Verhalten und Speicherbandbreite. Eine CPU, die die Systemaufruflatenz senkt, die Serialisierung beschleunigt und bei vielen gleichzeitig laufenden, leichtgewichtigen Threads einen hohen Durchsatz hält, verkürzt die Laufzeit von Agenten deutlich stärker als zusätzliche GPU-Rechenleistung. Dadurch verschiebt sich auch, wo Leistungsoptimierungen und Kostenabwägungen den größten Nutzen bringen.
NVIDIAs Doppelstrategie – Grace für speicherintensive Workloads und Vera für CPU-Aufgaben – soll eine einheitliche Plattform schaffen: GPUs bleiben die leistungsstarken Inferenzmotoren, während CPUs und Speicherverbindungen Orchestrierung und Datenverarbeitung übernehmen. Für Cloud- und On-Premise-Anbieter könnte sich so das System besser ausbalancieren lassen: weniger CPU-Engpässe bei der GPU-Versorgung, ein kohärenterer Speicherzugriff für Kontextfenster und geringerer Overhead in Agenten-Pipelines mit mehreren Knoten. Zu beachten ist allerdings: Frühe Chips und Software-Stacks müssen erst ausreifen, Compiler und Laufzeitumgebungen benötigen Optimierung, und die Gesamtbetriebskosten hängen vom tatsächlichen Workload-Mix ab – nicht von eindrucksvollen Durchsatzzahlen allein.