

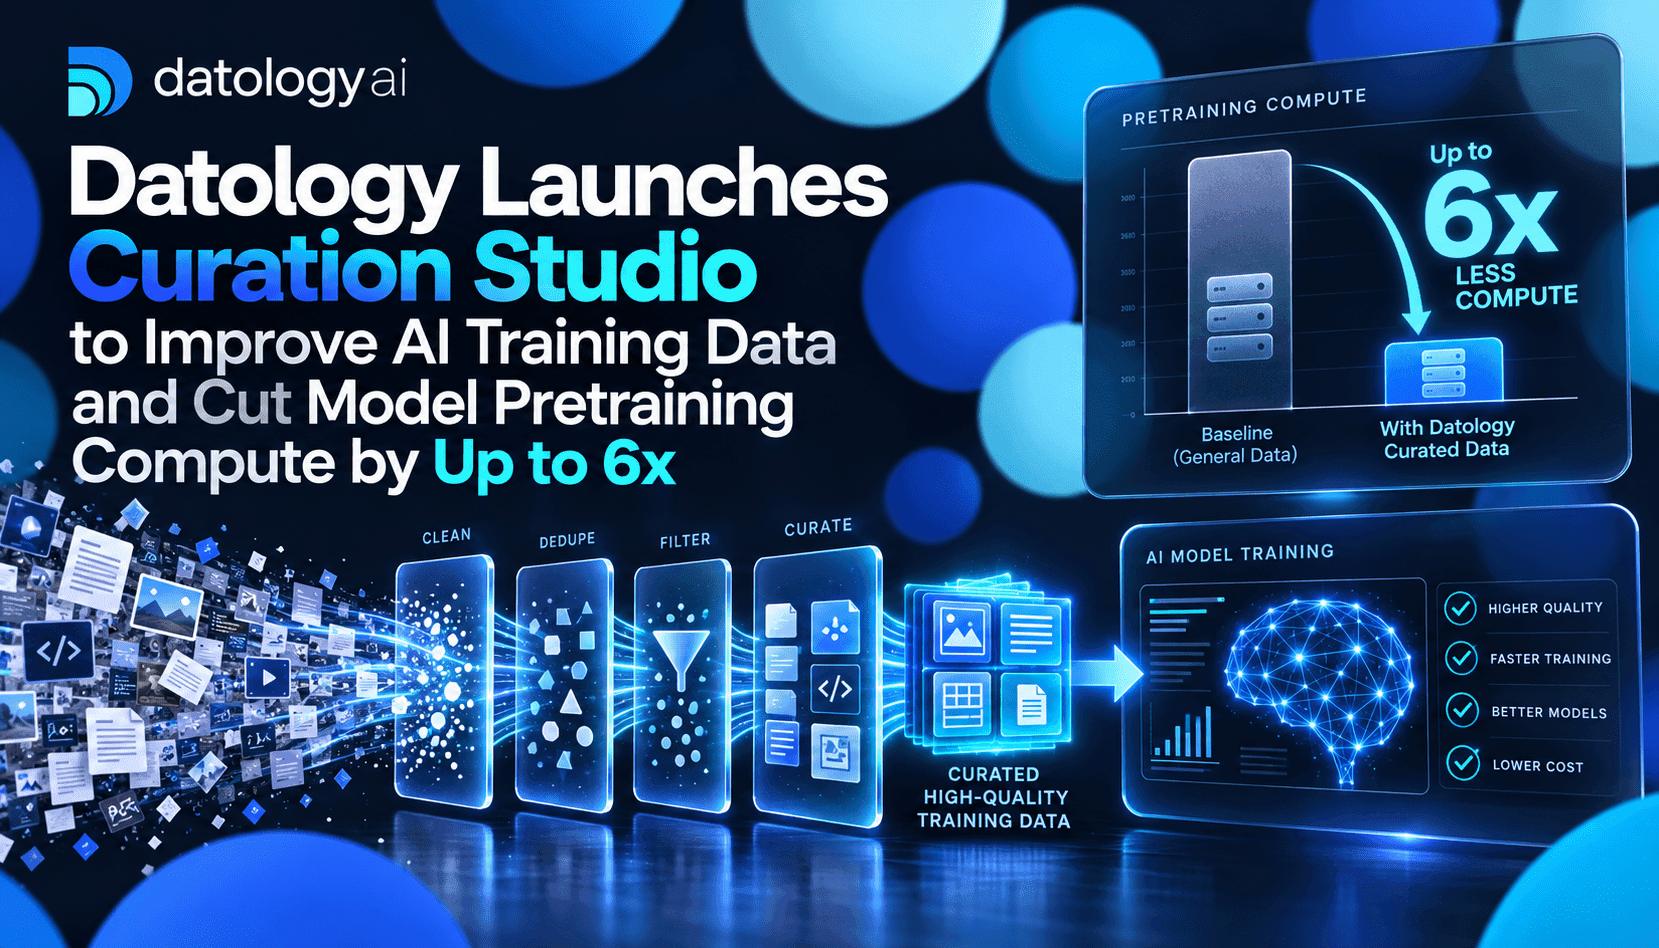
Curation Studio, la nueva herramienta de Datology, se presenta como una capa operativa entre el contenido sin procesar y el entrenamiento de modelos. En lugar de limitarse a incorporar cada vez más tokens, el producto aplica un proceso de cuatro etapas —limpiar, calibrar, crear y combinar— para destacar las señales de mayor valor para las tareas que te interesan. Este enfoque importa porque los experimentos de Datology muestran que es posible mejorar el rendimiento efectivo de un modelo con mucha más eficiencia mediante la curación de los datos de entrenamiento que aumentando a ciegas el cómputo de preentrenamiento. Para los equipos de ingeniería y producto, esto cambia dónde conviene invertir la atención y el presupuesto: menos en horas de GPU sin procesar y más en la gestión del ciclo de vida de los datos y las estrategias de ampliación sintética.
En esencia, la tecnología resulta familiar, aunque su ejecución opera a gran escala: desduplicación rigurosa y limpieza heurística, puntuación y ponderación de cada documento, generación sintética basada en ejemplos de origen de alta calidad y un motor de composición configurable que combina subconjuntos para distintas etapas del entrenamiento. Datology afirma haber realizado experimentos en los que los conjuntos de datos curados permitieron que modelos más pequeños, entrenados con menos tokens, igualaran o superaran a modelos de referencia más grandes, entrenados con mucho más cómputo. Para quienes trabajan en este ámbito, la implicación inmediata es práctica: se pueden intercambiar FLOP de preentrenamiento por flujos de trabajo de curación más inteligentes y modelos de inferencia más pequeños y económicos.
Llevar la curación de frontera a escala empresarial plantea exigencias de ingeniería considerables. Datology describe procesos a escala de petabytes, grafos de operadores personalizados y un amplio almacenamiento en caché de datos intermedios para procesar cientos de terabytes o petabytes sin disparar los costes ni los tiempos de ejecución. Ese trabajo es lo que permite pasar de la investigación de laboratorio a un producto que los equipos pueden ejecutar dentro de la VPC de un cliente. Para las empresas que evalúan desarrollar modelos propios, este modelo de producto es importante: conservan el control de los datos y su trazabilidad, y evitan enviar propiedad intelectual sin procesar a servicios externos, sin renunciar a técnicas avanzadas de curación.
El caso de negocio se centra en dos resultados medibles: el rendimiento del modelo por unidad de cómputo de preentrenamiento y el coste de inferencia por tarea. Los ejemplos de Datology —en los que un modelo curado de 12B, preentrenado con menos tokens, superó a un modelo de referencia de 30B que había utilizado mucho más cómputo— ilustran cómo la curación puede reducir tanto el tamaño como el presupuesto de entrenamiento de los modelos de producción eficaces. Para quienes toman decisiones, la conclusión es clara: inviertan pronto en herramientas y procesos de datos, y diseñen experimentos que midan el rendimiento frente a modelos de referencia normalizados por cómputo, no solo por cantidad de tokens.