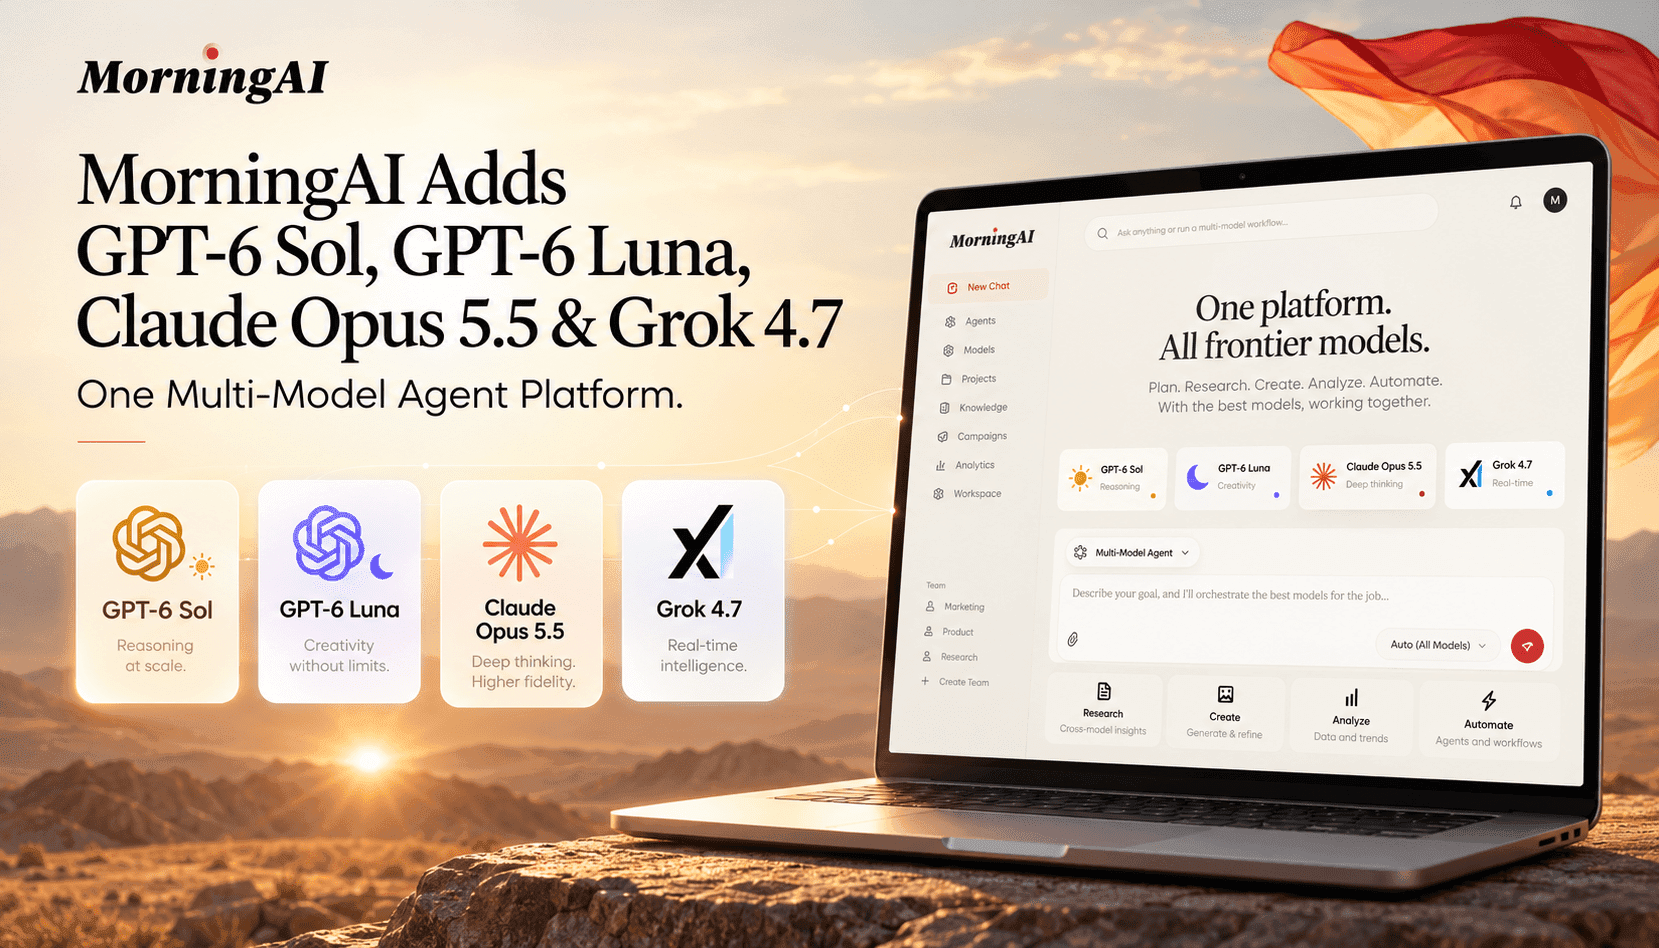
MorningAI ahora permite a los equipos elegir entre GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 o Grok 4.7 dentro de un solo Agente, y publicar contenido de Sanity CMS desde borrador hasta publicación programada con aprobaciones. La actualización consolida la elección de modelos, operaciones de contenido y seguimiento de tareas en un solo flujo de trabajo.
La última versión de MorningAI integra cuatro modelos emblemáticos—GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 y Grok 4.7—en un único compositor de Agentes, manteniendo al alcance las opciones de generaciones anteriores. Esto es importante porque la mayoría de los equipos no necesitan un modelo único para todo; necesitan una forma confiable de asignar el motor adecuado para cada tarea sin perder contexto ni generar fricciones en el flujo de trabajo. La plataforma recuerda tu selección, permitiéndote estandarizar elecciones para trabajos recurrentes y cambiar rápidamente cuando varían la velocidad, el presupuesto o la profundidad.
El segundo pilar es la gestión integral de Sanity CMS. Los Agentes pueden redactar, revisar, añadir o cambiar imágenes, programar y publicar, todo con controles de aprobación integrados. En lugar de mover contenido entre herramientas, escritores y operadores permanecen en un solo hilo para avanzar desde la ideación hasta la publicación programada. Esto no es solo una novedad, sino una mejora en la eficiencia: menos traspasos, estados más claros y auditorías más sencillas cuando la dirección pregunta qué se publicó, por qué y con qué modelo respaldando el trabajo.
Para los operadores, la gran ventaja es el control. Puedes alinear la elección del modelo con la intención (razonamiento vs. velocidad), codificar pasos de revisión en aprobaciones y gestionar los tiempos en el Calendario. La nueva área de Tareas se integra en este ritmo para que los equipos coordinen responsabilidades sin salir del Agente. El trabajo restante es la gobernanza: definir qué trabajos califican para cada modelo, ajustar los límites de costo y hacer rutinarios los controles post-publicación. Si se hace bien, esta actualización convierte experimentos dispersos de chat en operaciones de contenido duraderas a nivel de equipo.
Qué Cambió: Un Agente, Cuatro Modelos de Vanguardia
MorningAI ahora muestra GPT-6 Sol, GPT-6 Luna, Claude Opus 5.5 y Grok 4.7 directamente en el compositor de Agentes, con modelos de generaciones anteriores disponibles en una lista separada. Los usuarios eligen por tarea sin reconfigurar espacios de trabajo, y MorningAI recuerda la elección hasta que la cambies. Esto reduce el tiempo de configuración y evita reinicios accidentales de contexto.
En la práctica, los equipos pueden asignar Sol u Opus para planificación y análisis complejos, usar Luna para borradores rápidos y recurrir a Grok cuando la latencia o estilos alternativos de razonamiento son útiles. Centralizar la selección también facilita estandarizar políticas de modelos y comparar resultados entre familias sin forzar herramientas separadas o hilos de chat paralelos.
Por Qué Importa: Ajusta el Modelo a la Tarea, No al Revés
La actualización se alinea con cómo trabajan los equipos de alto rendimiento: asignan razonamiento profundo a modelos premium y tareas cotidianas a modelos más rápidos y económicos. Incluir esta decisión dentro del compositor de Agentes significa menos directrices improvisadas y ejecución más consistente. También eleva el nivel de evaluación—comparando salidas A/B entre modelos con el mismo encargo para establecer referencias según el tipo de tarea.
Espera mejoras medibles en tiempos de ciclo y control de costos si institucionalizas valores predeterminados. Por ejemplo, asigna Luna para borradores iniciales de menos de 600 palabras, Sol/Opus para investigaciones en varios pasos y contenido con políticas complejas, y Grok para ideación exploratoria. Con el tiempo, compara calidad y diferencias de edición para perfeccionar el manual de enrutamiento y retirar valores predeterminados con bajo rendimiento.
CMS de Principio a Fin: Borrador, Revisión, Programación y Publicación en Sanity
Los Agentes ahora pueden llevar documentos de Sanity desde la idea hasta la publicación programada con aprobaciones integradas en el flujo. En la práctica, un marketero puede solicitar un borrador, iterar tono y estructura, generar o cambiar imágenes y programar una publicación—sin salir de la conversación. El mismo editor se abre para cualquier tipo de documento definido en tu proyecto Sanity, extendiéndose más allá de blogs a historias de clientes o tipos de contenido personalizados.
La gobernanza marca la diferencia. Usa pasos de aprobación para hacer cumplir controles de marca, legales y de accesibilidad; mantiene la auditabilidad capturando cambios, marcas de tiempo y el modelo utilizado. La vista de Calendario permite a los equipos visualizar publicaciones en cola junto con otros trabajos programados, reduciendo colisiones y aclarando qué se publica esta semana versus la siguiente.
Guía de Implementación: Configuraciones, Roles y Despliegue
Comienza con una matriz de enrutamiento: define qué tipos de contenido usan qué modelo predeterminado y por qué. Establece límites de costo por espacio de trabajo y aplica una aprobación en dos pasos para publicaciones sensibles a SEO o regulaciones. En Sanity, confirma campos obligatorios para título, descripción, texto alternativo y validaciones específicas de esquema para que los agentes no puedan programar contenido incompleto.
Operacionaliza la medición. Rastrea el tiempo desde borrador hasta aprobación, cantidad de ediciones por modelo y desviaciones entre programación y publicación. Usa Tareas para asignar responsables de borrador, revisión SEO y aprobación final. Realiza un piloto de dos semanas con tres tipos de publicaciones (anuncio, tutorial, historia), compara resultados entre modelos y luego codifica valores predeterminados y excepciones en los manuales del equipo.
Riesgos y Controles: Marca, Deriva y Disciplina de Costos
La libertad multi-modelo puede fragmentar la voz y aumentar costos si no se controla. Mitígalo con plantillas de tono, linters de estilo y una edición humana obligatoria para activos de primer nivel. Monitorea actualizaciones de modelos que cambien el comportamiento; programa evaluaciones trimestrales para asegurar que la matriz de enrutamiento sigue vigente y que los modelos anteriores no hayan degradado silenciosamente los resultados.
Controla el alcance en CMS: restringe permisos de publicación, mantiene paridad de entornos (staging vs. producción) y habilita patrones de reversión. Para costos, establece presupuestos por modelo y alertas ante picos. Finalmente, establece un plan de respaldo: si falla la programación o generación de imágenes, las tareas deben asignarse automáticamente a un responsable humano con contexto adjunto.