

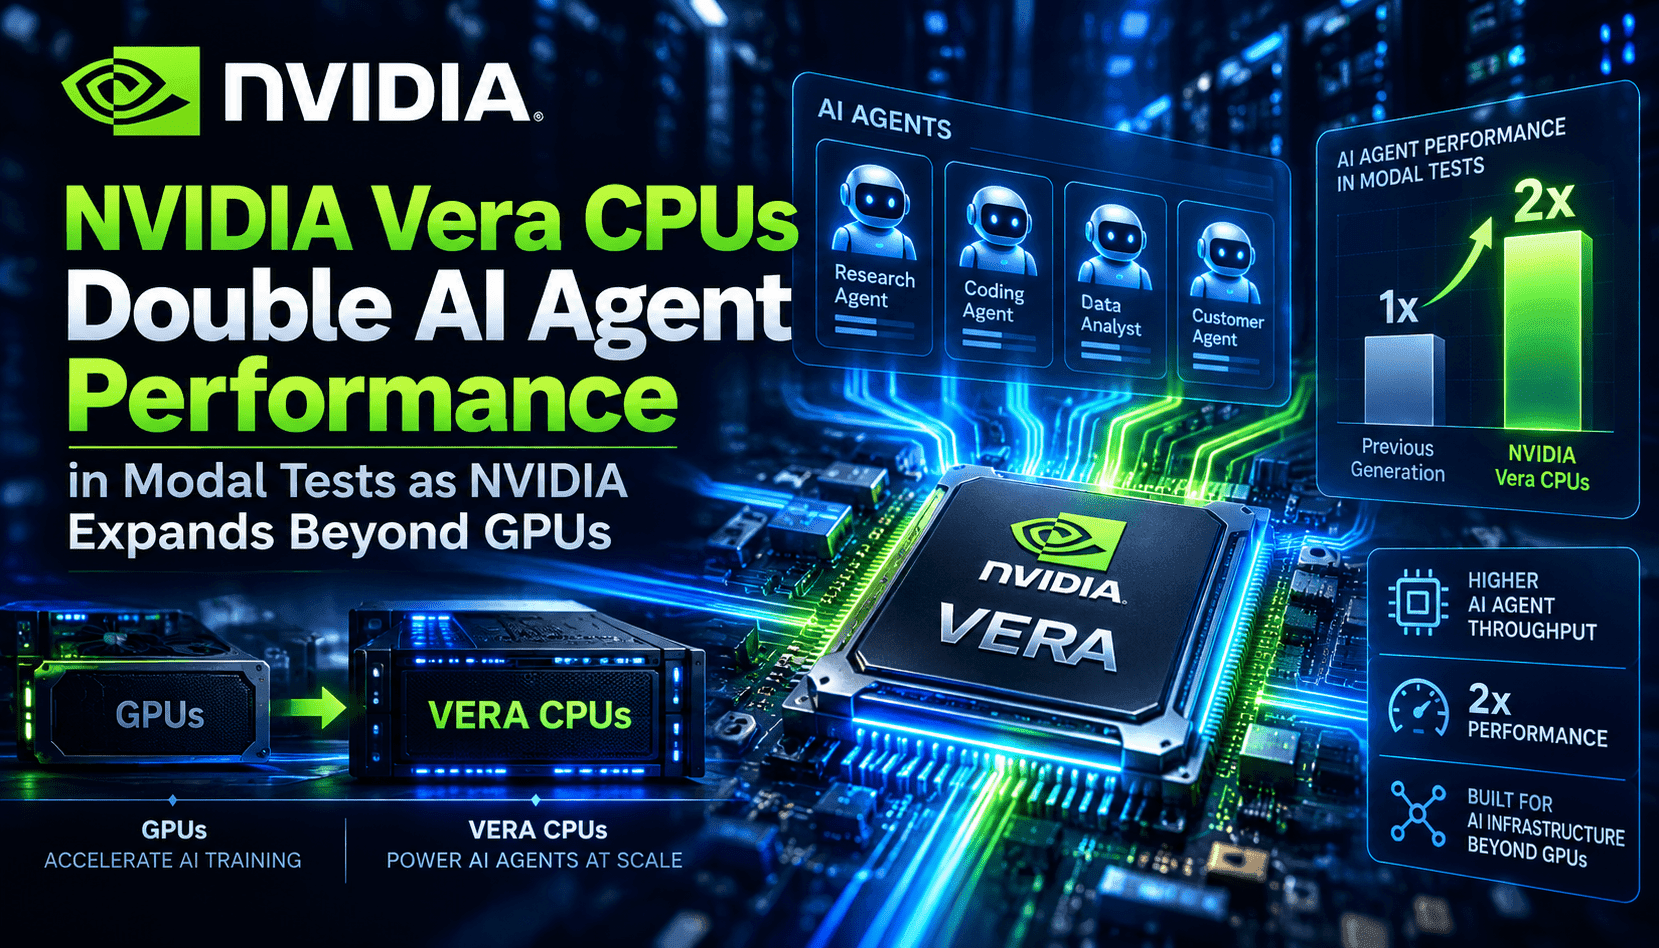
Según se informa, las primeras pruebas de infraestructura de Modal con el procesador Vera de NVIDIA muestran un rendimiento de las tareas aproximadamente dos veces mayor que el de sistemas comparables de Intel y AMD al ejecutar agentes de IA de larga duración. Estos agentes dedican muchos ciclos a orquestar herramientas, gestionar ventanas de contexto, serializar y deserializar datos, y procesar lógica condicional entre llamadas a la GPU. En este tipo de carga mixta, la microarquitectura de la CPU, el rendimiento de la memoria y la latencia de entrada/salida del sistema importan más que el rendimiento bruto de la GPU en operaciones de coma flotante de precisión simple. El resultado de Modal no es una prueba de referencia universal, pero indica que trasladar parte del trabajo crítico para el rendimiento a un diseño moderno de CPU puede mejorar notablemente el rendimiento integral de los agentes.
Las CPU vuelven a cobrar protagonismo en las cargas de trabajo de agentes porque estos sistemas no se limitan a ejecutar multiplicaciones de matrices densas: gestionan bucles de eventos, coordinan razonamientos de varios pasos, realizan recuperación y enriquecimiento de datos, e implementan integraciones con herramientas. Estas tareas generan muchas operaciones pequeñas y sensibles a la latencia, además de patrones de acceso a memoria impredecibles, por lo que importan el rendimiento de un solo hilo, el comportamiento de la caché y el ancho de banda de memoria. Una CPU que reduzca la latencia de las llamadas al sistema, acelere la serialización y mantenga un alto rendimiento con muchos hilos ligeros simultáneos reducirá mucho más el tiempo total de ejecución de los agentes que añadir capacidad de cálculo a la GPU. Este cambio redefine dónde se obtienen las mayores mejoras al optimizar el rendimiento y equilibrar los costos.
La estrategia dual de NVIDIA —Grace para cargas de trabajo centradas en la memoria y Vera para tareas de CPU— busca integrar una plataforma coherente en la que las GPU sigan encargándose de la inferencia intensiva, mientras que las CPU y las redes de memoria asumen la orquestación y el movimiento de datos. Para los proveedores de nube y de infraestructura local, esto puede facilitar el equilibrio de los sistemas: menos cuellos de botella en la CPU que alimenta las GPU, mayor coherencia de memoria para las ventanas de contexto y menos sobrecarga en los flujos de agentes distribuidos en varios nodos. Sin embargo, hay aspectos prácticos que considerar: el hardware y las pilas de software iniciales necesitan madurar, los compiladores y los entornos de ejecución deben ajustarse, y el costo total de propiedad depende de la combinación real de cargas de trabajo, no de cifras de rendimiento llamativas.