

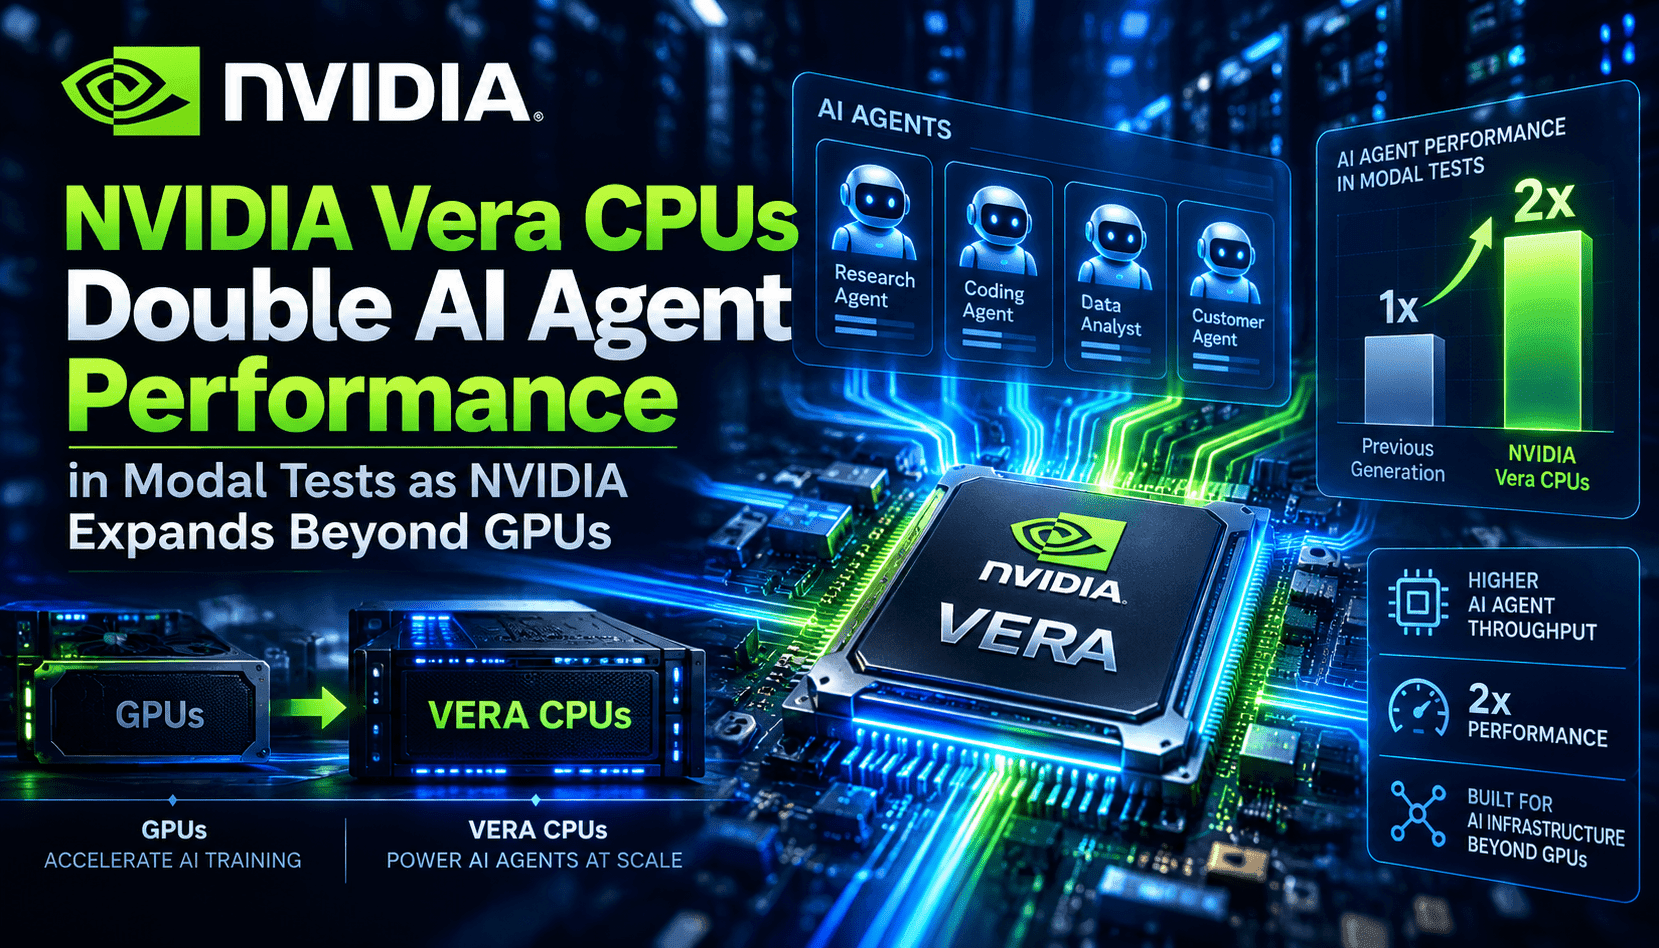
Lors des premiers tests d’infrastructure de Modal, le processeur Vera de NVIDIA aurait offert des performances d’exécution des tâches environ deux fois supérieures à celles de systèmes Intel et AMD comparables, pour des agents IA de longue durée. Ces agents consacrent une grande partie de leurs cycles à orchestrer des outils, gérer des fenêtres de contexte, sérialiser et désérialiser des données, et traiter la logique conditionnelle entre les appels au GPU. Dans ce type de charge mixte, la microarchitecture du processeur, le débit mémoire et la latence des entrées-sorties système comptent davantage que les performances brutes du GPU en FP. Le résultat de Modal ne constitue pas un benchmark universel, mais il indique que réaffecter certaines tâches critiques à une architecture de processeur moderne peut améliorer sensiblement le débit de bout en bout des agents.
Les processeurs reprennent de l’importance dans les charges de travail des agents, car ces systèmes ne se contentent pas d’effectuer des multiplications matricielles intensives : ils gèrent des boucles d’événements, orchestrent des raisonnements en plusieurs étapes, assurent la récupération et l’enrichissement des données, et mettent en œuvre les intégrations d’outils. Ces tâches génèrent de nombreuses opérations brèves et sensibles à la latence, ainsi que des accès mémoire imprévisibles, pour lesquels les performances monothread, le comportement du cache et la bande passante mémoire sont déterminants. Un processeur qui réduit la latence des appels système, accélère la sérialisation et maintient un débit élevé avec de nombreux threads légers simultanés peut réduire davantage le temps d’exécution total des agents que l’ajout de puissance de calcul au GPU. Cette évolution change la façon dont les optimisations de performances et les arbitrages de coûts permettent d’obtenir les gains les plus importants.
La stratégie à deux volets de NVIDIA — Grace pour les charges de travail centrées sur la mémoire et Vera pour les tâches du processeur — vise à créer une plateforme cohérente où les GPU restent les moteurs d’inférence lourde, tandis que les processeurs et les interconnexions mémoire prennent en charge l’orchestration et la circulation des données. Pour les fournisseurs de services cloud et les exploitants sur site, cela pourrait faciliter l’équilibrage des systèmes : moins de goulots d’étranglement côté processeur qui limitent l’alimentation des GPU, une cohérence mémoire renforcée pour les fenêtres de contexte et une surcharge réduite dans les pipelines d’agents répartis sur plusieurs nœuds. Il reste toutefois des réserves concrètes : les premières puces et les piles logicielles doivent gagner en maturité, les compilateurs et les environnements d’exécution doivent être optimisés, et le coût total de possession dépend de la composition réelle des charges de travail, pas des chiffres de débit mis en avant.