

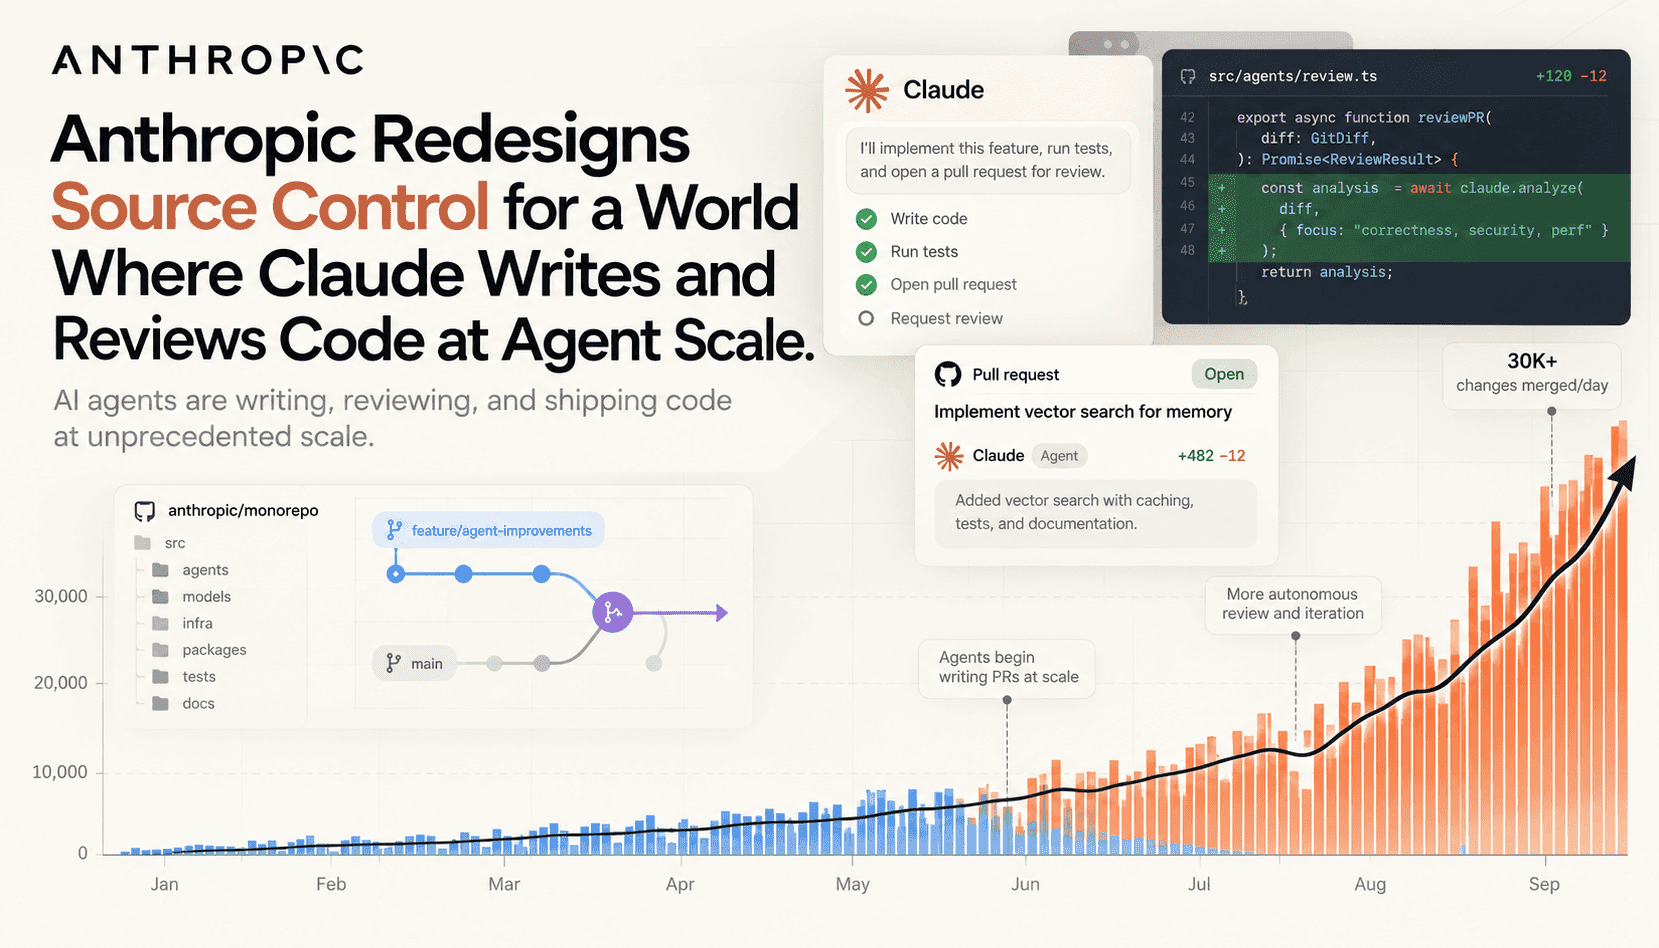
AnthropicがGitから独自システムのScionへ移行したのは、運用上の転換点に対応するための構造的な判断でした。Claudeをはじめとする自律型エージェントが1日に数万件の変更を作成・マージするようになり、人間の規模を前提に設計されたツールの根本的な想定が崩れ始めたのです。大半のクライアントが、リポジトリ全体ではなく必要な一部だけを求めるオンラインエージェントになると、完全なクローン、packfileによるデータ交換、ローカル参照といった分散型の前提は、かえって足かせになります。Scionはこの問題を、高スループットのサーバー主導型メタデータ処理と、必要なファイルだけを取得する仕組みとして捉え直しました。この発想の転換は、パイプラインの設計や状態の監視、変更の監査方法にも影響します。
Scionの中核では、Gitのグラフ全体を扱う処理を、サーバー側の変更セットと、そこから生成されるインデックスに置き換えています。すべてのクライアントに不変のpackfileを送る代わりに、コンテンツアドレス方式のBlob、対象を絞ったツリー要求、blame・祖先関係・差分を取得するサーバーAPIを提供します。作業コピーは必須ではありません。CIや研究用ジョブはサーバーにメタデータを問い合わせるだけでも、実際に読み込むパスだけを展開して使うこともできます。これによりネットワーク、CPU、ストレージの使用量を大幅に抑えられ、コミットの作成も低コストかつロック不要になります。マージ件数が桁違いに増える環境では、これは欠かせない特性です。
運用面では、CI、コードレビュー、IAM、可観測性など、ツール全体の見直しが必要になります。プルやビルドは、ミラーからリポジトリを一括クローンする方式ではなく、階層化されたサーバーに対するキャッシュ主体の読み取り処理へと変わります。blameインデックス、パス履歴、スキップリストなどの派生データは、段階的に計算して保存する必要があります。また、先回りして計算するか、要求時に計算するかの選択は、レイテンシ、ストレージ、運用コストに直結します。チームはジョブの起動手順やローカル開発の使い勝手、キャパシティ計画を見直し、オブジェクトキャッシュ、再開可能なフェッチ、リージョンごとの分離を重視する必要があります。
エンジニアリングリーダーにとって、実践上の課題は差し迫っています。エージェントが生成した変更を大規模にどう信頼するのか、ポリシーをどう計測・適用するのか、単一の調整箇所がボトルネックになるのをどう防ぐのか。Anthropicの経験から、サーバー側でのポリシー適用、プログラムによるレビュー機能、敵対的な検証パイプライン、参照の慎重な運用を組み合わせれば、これらの課題は解決できることがわかります。ローカルの自律性が下がり、中央側の計算負荷が増え、派生データの保守が新たに必要になるという技術的なトレードオフはあります。しかし、その代わりに速度、再現性、エージェント規模で運用する能力が大きく向上します。