

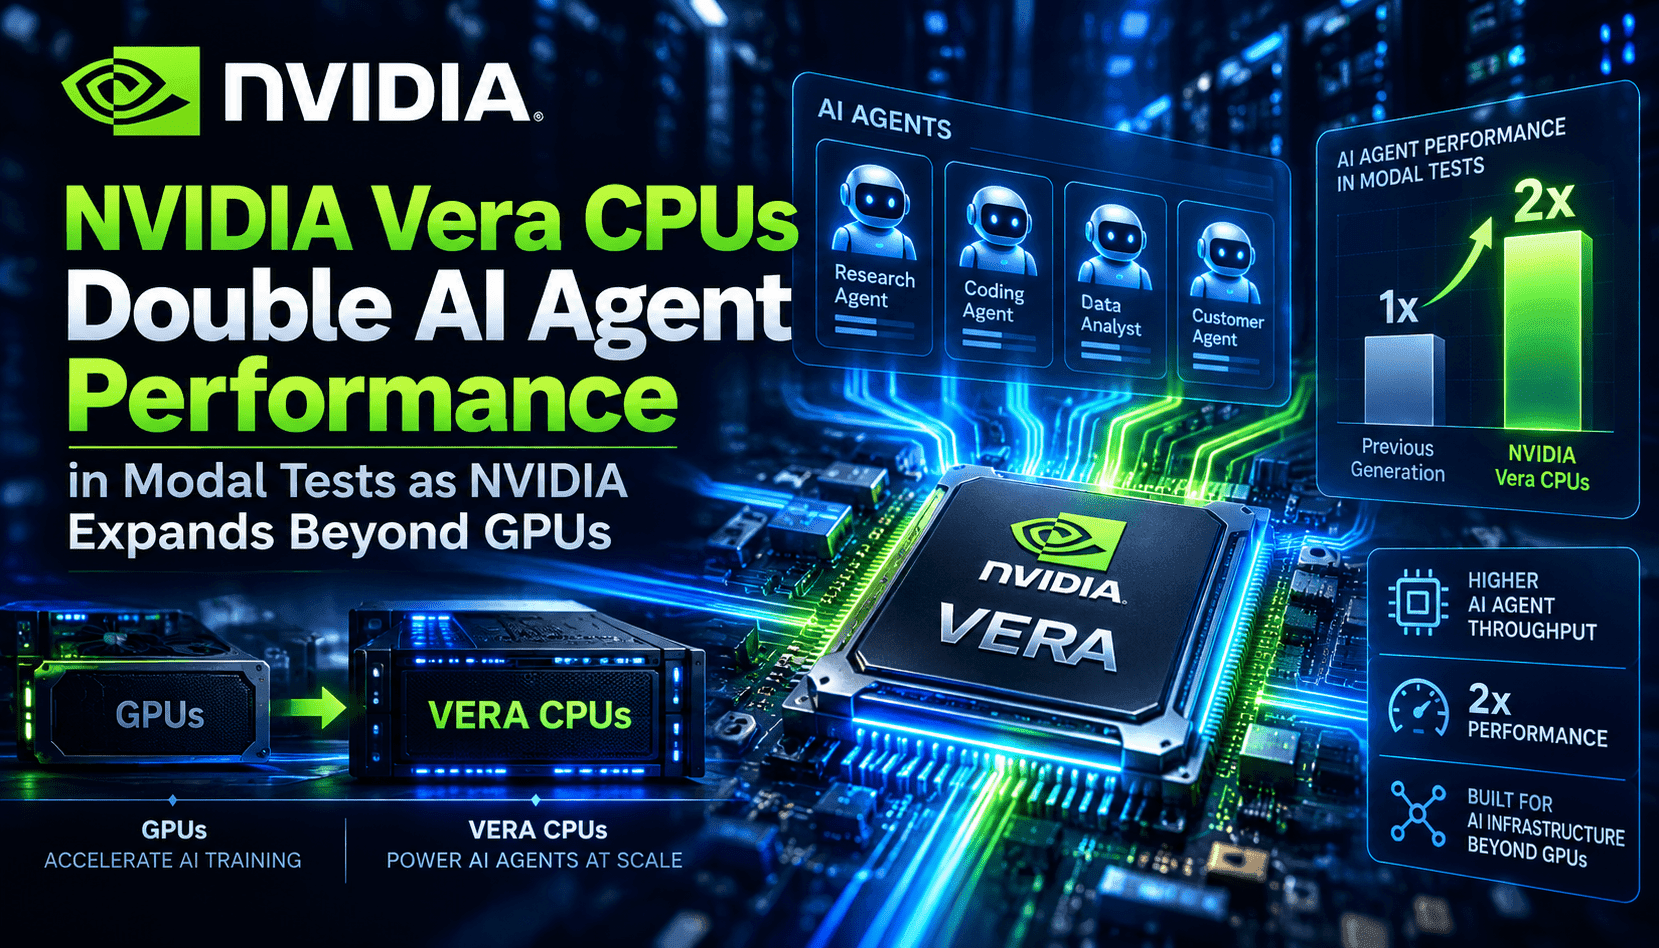
NVIDIAのVeraプロセッサを使ったModalの初期インフラテストでは、長時間稼働するAIエージェントを動かした場合、同等クラスのIntelおよびAMD搭載システムと比べて、タスク処理性能がおよそ2倍になったと報告されています。こうしたエージェントは、ツールのオーケストレーション、コンテキストウィンドウの管理、データのシリアライズとデシリアライズ、GPU呼び出し間の条件分岐などに多くの処理時間を費やします。このような複合的なワークロードでは、GPUの生のFP性能よりも、CPUのマイクロアーキテクチャ、メモリ帯域幅、システムI/Oのレイテンシが重要になります。Modalの結果は普遍的なベンチマークではありませんが、性能を左右する処理の一部を最新のCPU設計に戻すことで、エージェントのエンドツーエンドの処理量を大きく伸ばせる可能性を示しています。
エージェントのワークロードでCPUが再び重要になっているのは、こうしたシステムが大量の行列演算だけを実行するわけではないからです。イベントループの処理、複数段階にわたる推論のオーケストレーション、検索と情報補完、ツール連携なども担います。これらの処理では、レイテンシに敏感な小規模処理が頻繁に発生し、メモリアクセスも予測しにくいため、単一スレッド性能やキャッシュの挙動、メモリ帯域幅がものをいいます。システムコールのレイテンシを抑え、シリアライズを高速化し、多数の軽量スレッドを高スループットで処理できるCPUなら、GPUの演算性能を追加するよりもエージェントの実行時間を大幅に短縮できる可能性があります。この変化により、最適化やコスト配分によって最大の効果が得られる箇所も変わってきます。
NVIDIAの二本柱の戦略—メモリ中心のワークロードを担うGraceと、CPU処理を担うVera—は、GPUが高負荷な推論を担う一方で、CPUとメモリファブリックがオーケストレーションやデータ処理を支える、一貫性のあるプラットフォームの構築を目指しています。クラウド事業者やオンプレミス環境の提供者にとっては、GPUにデータを供給するCPUのボトルネックの緩和、コンテキストウィンドウにおけるメモリ整合性の向上、複数ノードにまたがるエージェント処理のオーバーヘッド削減など、システム全体のバランスを取りやすくなる可能性があります。ただし、初期のシリコンやソフトウェアスタックには成熟が必要で、コンパイラやランタイムの最適化も欠かせません。また、総保有コストは見出しになるスループットの数値ではなく、実際のワークロード構成によって決まります。