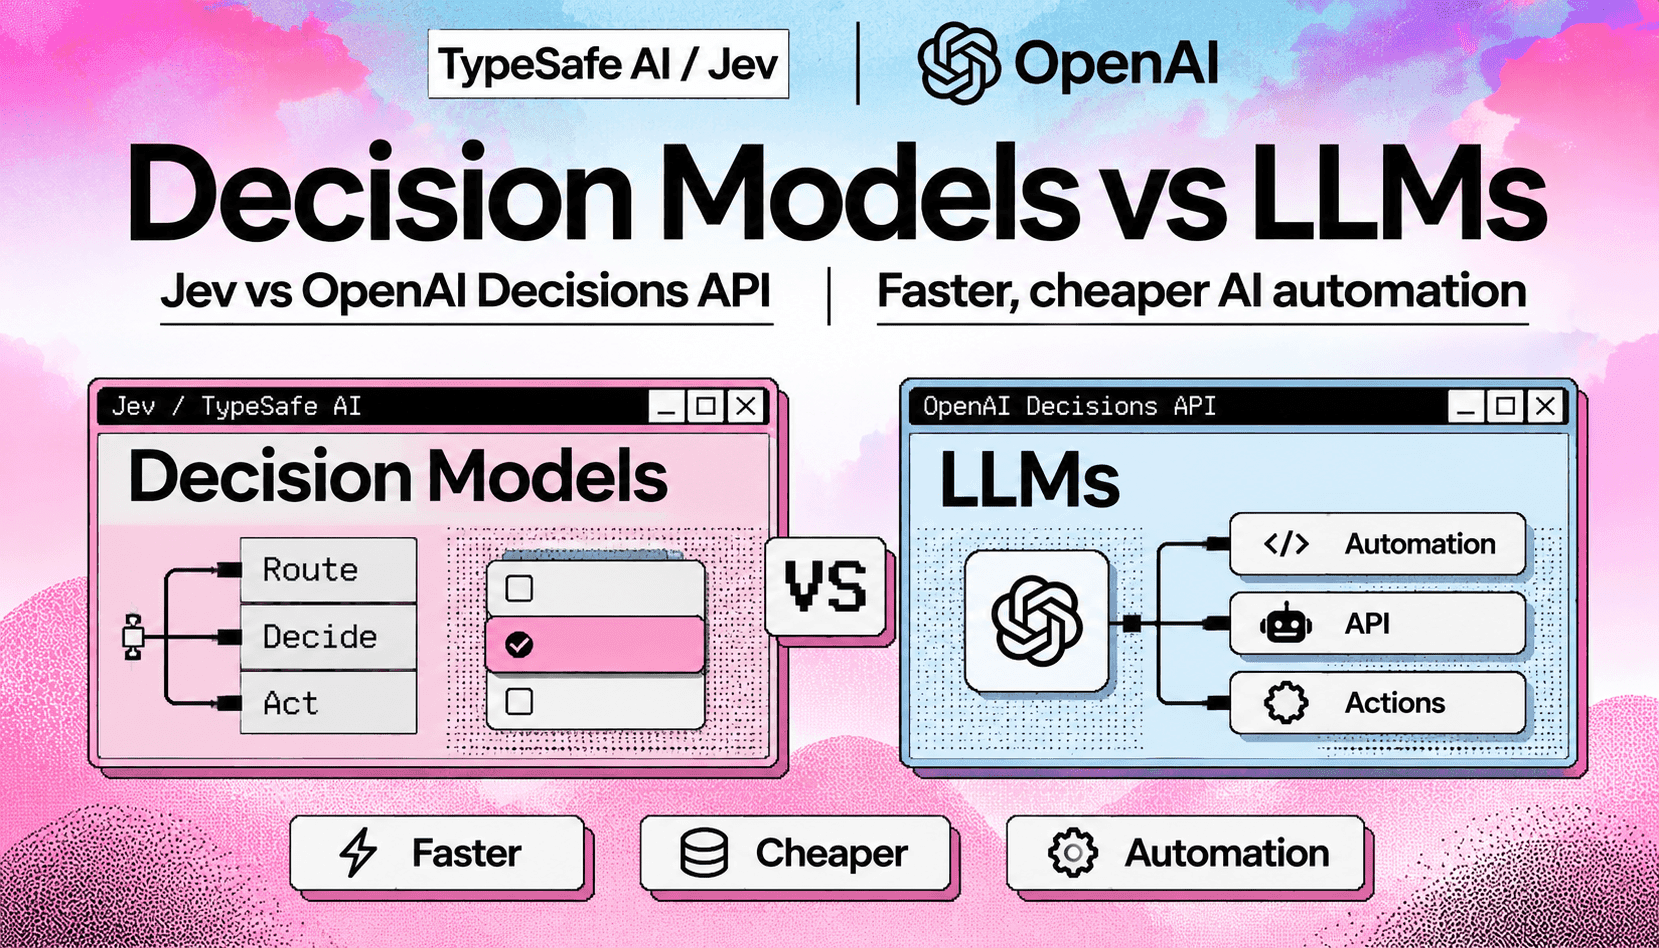
자동화 파이프라인을 구축하는 기업은 단순하지만 끊임없이 반복되는 문제에 직면합니다. 생성형 LLM은 유연하지만 모든 라우팅, 점수 산정, 이진 판단에 사용하면 비용이 많이 들고 처리 속도도 느립니다. Jev와 OpenAI Decisions API 같은 제품으로 대표되는 새로운 소형 의사결정 모델은 바로 이런 용도를 겨냥합니다. 결정론적 분류를 위해 학습되고, 보정된 신뢰도 값을 제공하며, 완전한 추론형 LLM보다 지연 시간과 컴퓨팅 비용을 낮추도록 설계됐습니다. 이러한 변화의 목표는 LLM을 대체하는 것이 아니라, 작업에 맞는 모델을 선택해 비용과 성능을 예측 가능하게 만드는 것입니다.
의사결정 모델은 입력이 비교적 제한된 결과 집합으로 이어지는 구조화된 분류, 라우팅, 정책 적용에 특히 효과적입니다. 실제로는 빠른 의도 분류, 사기 여부 판별, 간단한 자격 확인, 또는 후속 에이전트에 전달할 다양한 특성 기반 점수 산정 등에 활용할 수 있습니다. 마이크로서비스로 엣지나 규칙 엔진 내부에 배포해 대규모 추론 모델을 호출하기 전 초기 필터로 사용할 수도 있습니다. 출력이 간결하고 예측 가능하므로 생성형 모델에 모든 작업을 맡기는 것보다 엄격한 지연 시간 SLA를 설정하고 모니터링을 단순화할 수 있습니다.
이 글에서는 대표적인 의사결정 모델(예를 들어 Jev)과 OpenAI Decisions API를 대규모 생성형 LLM과 비교해 지연 시간, 의사결정당 비용, 신뢰도 점수, 설명 가능성을 살펴봅니다. 이어서 의사결정 계층과 LLM을 결합해 비용이 큰 호출을 줄이고 신뢰성을 높이며, 꼭 필요한 경우에만 추론 기능을 활용하는 실용적인 아키텍처를 제안합니다. 마지막으로 라우팅이나 점수 산정 모델을 선택할 시점, 추론 경로를 유지해야 할 시점, 그리고 오라우팅을 탐지하고 완화하도록 하이브리드 스택을 계측하는 방법을 안내합니다.