

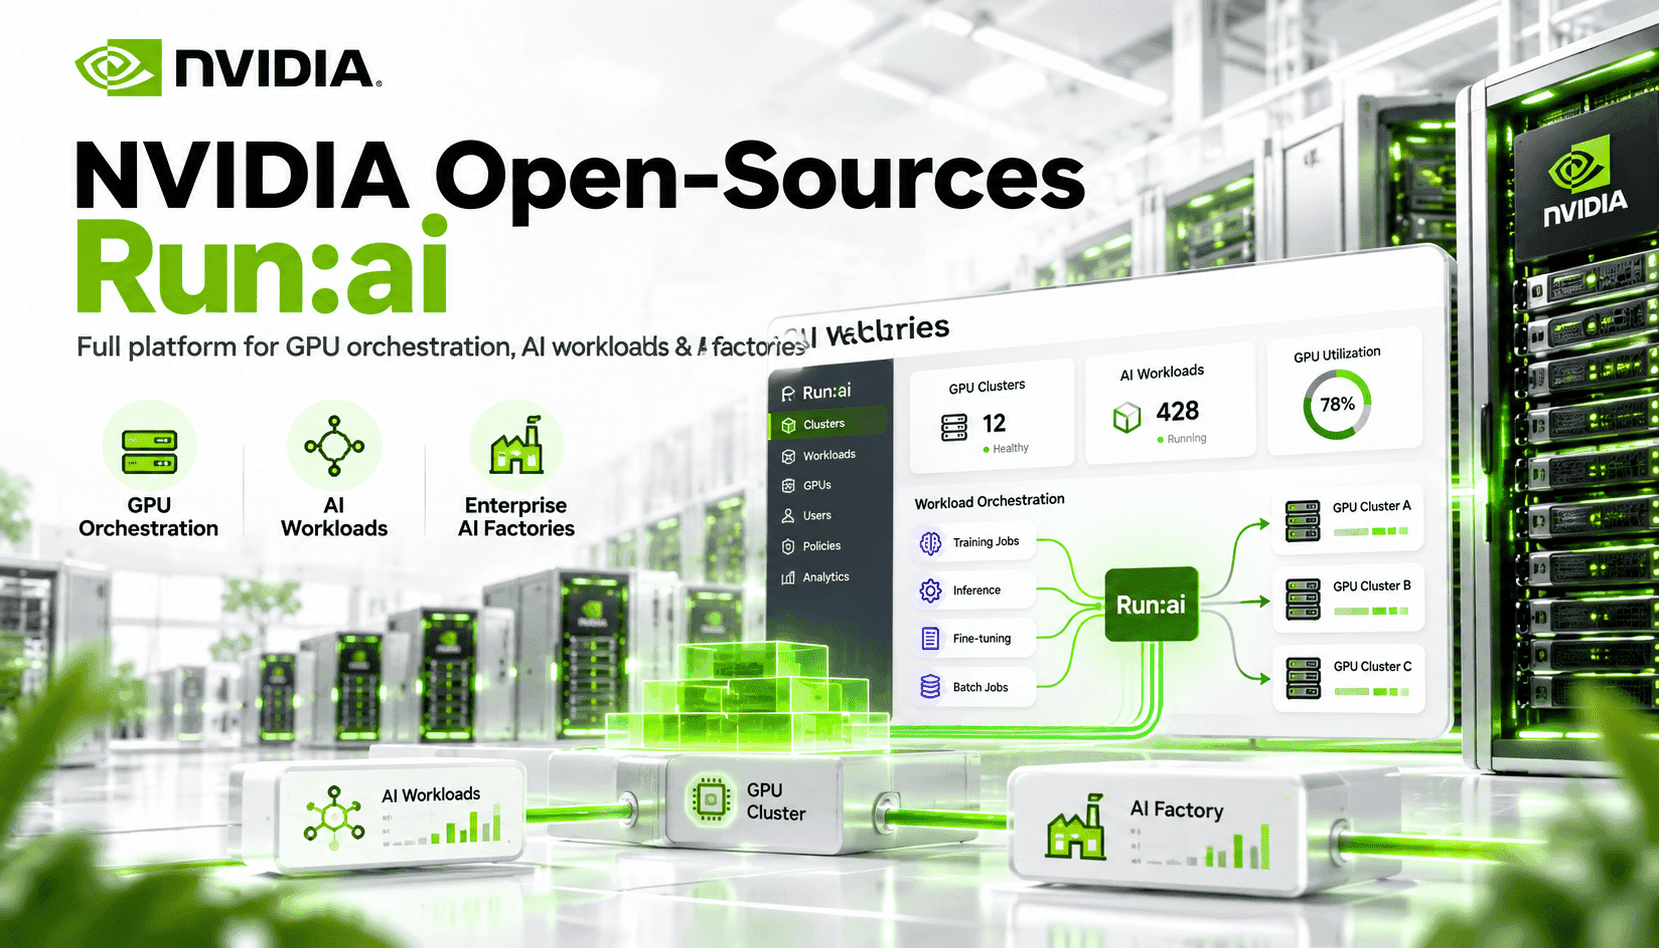
A decisão da NVIDIA de abrir o código de toda a plataforma Run:ai marca um ponto de virada prático para as empresas que estão construindo uma infraestrutura privada de IA. Em vez de adaptar uma camada fechada de agendamento e compartilhamento, as organizações agora podem inspecionar e modificar o KAI Scheduler, o GPU Fractioning Operator, o KAI Resource Management e o Workload Map. Essa visibilidade faz diferença: as equipes de plataforma passam a contar com uma base nativa do Kubernetes, testada em produção, que já incorpora agendamento em grupo, consciência de topologia, cotas de compartilhamento justo e particionamento de memória nativo do CUDA. Na prática, isso significa menos soluções improvisadas, integração mais rápida com as ferramentas de cluster existentes e um contrato comum para cargas de trabalho de IA com vários componentes.
Na operação, o Run:ai responde a três desafios persistentes das empresas. Primeiro, a subutilização de GPUs: ao permitir frações rígidas de GPU e compartilhamento orientado pelo agendador, as equipes podem executar várias cargas de trabalho menores ao mesmo tempo sem exceder a memória disponível. Segundo, a governança entre equipes: o KAI Resource Management introduz um modelo de cotas que leva em conta a estrutura organizacional, permitindo definir garantias explícitas e aplicar regras de compartilhamento justo para pesquisa, plataforma e produção. Terceiro, a diversidade de cargas de trabalho: o Workload Map padroniza diferentes CRDs e trabalhos com vários pods para que as ferramentas e os processos de SRE os tratem de maneira consistente. Em conjunto, esses recursos reduzem o trabalho manual de agendamento e permitem planejar a capacidade com mais previsibilidade.
Do ponto de vista da pilha tecnológica, o Run:ai se encaixa naturalmente em fábricas de IA que priorizam o Kubernetes. O KAI Scheduler é um agendador desenvolvido para esse fim e contribuído para a sandbox da CNCF; ele pode ser implantado junto com outros agendadores e integra posicionamento com consciência de topologia, semântica de agendamento em grupo e sinais de compartilhamento de GPU. O GPU Fractioning Operator conecta o particionamento nativo do CUDA 13.4 ao Kubernetes, expondo a alocação de memória por pod e suas métricas. O Workload Map elimina a necessidade de repetir configurações de CRDs em painéis, escalonadores automáticos e ferramentas de custos. Para as empresas que já usam Kubernetes, isso significa menos controladores personalizados e um caminho de migração mais claro de scripts improvisados para uma orquestração declarativa.
As opções de adoção variam conforme a necessidade. Equipes menores podem implantar apenas os componentes de que precisam — por exemplo, adicionar o GPU Fractioning Operator para reduzir custos em notebooks e tarefas de inferência, mantendo o agendador atual. Já as equipes de plataforma que buscam um controle unificado podem adotar juntos o KAI Scheduler e o KAI Resource Management e avaliar se vale a pena contribuir com melhorias específicas do ambiente para o projeto upstream. Parceiros do ecossistema e fornecedores de serviços gerenciados oferecerão pilhas pré-integradas e validadas para equipes que precisam chegar à produção mais rápido ou contar com suporte empresarial. Em todos os casos, o código aberto reduz o atrito de integração e amplia as possibilidades de colaboração em correções e inovações.