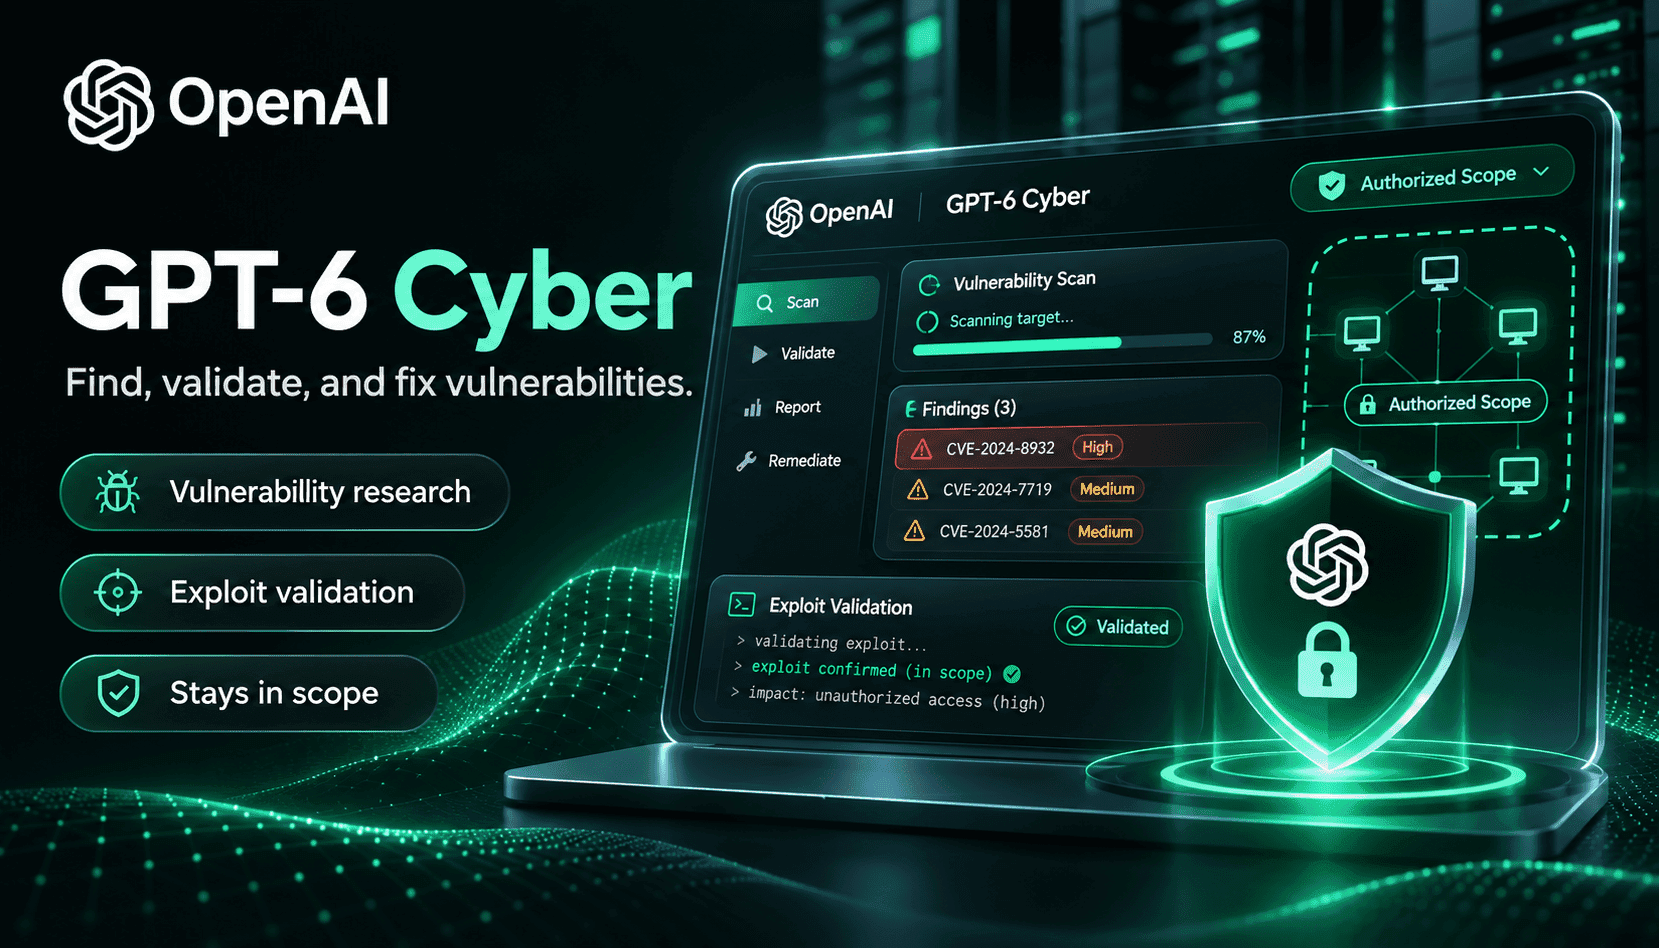
OpenAI 的 GPT-6 Cyber象徵著一次明確的轉向:從通用型程式碼助理,邁向專為防禦者打造、能力強大的資安專用代理模型。GPT-6 Cyber 並非一般的程式設計模型更新,而是針對衡量漏洞利用開發、漏洞發掘,以及(尤其重要的)遵守研究人員所訂定交戰規則的基準進行訓練與評估。OpenAI 表示,與 GPT-5.6 Cyber 相比,該模型在 ExploitGym 和全新的遠端漏洞利用基準測試中大幅進步,並聲稱在遵守作業範圍方面有突破性的提升。對於執行授權紅隊演練與漏洞研究的團隊,這款模型有望帶來更高品質、可重現的發現;對於負責保護關鍵基礎設施的防禦者,則提供受控的存取管道與額外防護措施。
實際上,GPT-6 Cyber 的設計目標是可靠地完成三項環環相扣的工作:從原始碼與二進位檔案中找出可能的漏洞;在受控測試環境中重現並驗證漏洞是否可被利用;以及提出候選修補方案與驗證測試。OpenAI 公布的結果顯示,該模型在內部研究活動中重現了數千個問題,並開發出數百個可運作的漏洞利用概念驗證(PoC)。結合漏洞發掘與可重現的驗證,將改變資安團隊的作業方式:團隊能依據更有力的證據進行分類處理、提升處理量,並在交接給工程團隊時附上可驗證修正效果的實測案例,加快修補速度。
然而,能力愈強,政策上的取捨也愈多。OpenAI 將 GPT-6 Cyber 與 Daybreak 存取架構搭配使用:Daybreak Blue 為經審核、需要較少拒絕限制的防禦者提供服務;Daybreak Red 則支援更深入的漏洞利用工作流程,並設有嚴格的網路允許清單與監控機制。OpenAI 也加入資安專用的濫用偵測器、用於敏感記錄檔的私密安全處理,以及沙箱使用建議。任何考慮採用 GPT-6 Cyber 的組織,都必須同等重視技術能力與實際作業要求:在進行高風險實驗前,應先建立存取治理、網路隔離、人工審核關卡及事件處理程序。
對資安主管而言,GPT-6 Cyber 既是機會,也是一項需要規劃的專案:它能加速漏洞發掘並產生品質更高的修補候選方案,但團隊也必須重新設計工作流程,將可重現性、風險控管與負責任的揭露納入其中。本文將解析 GPT-6 Cyber 的運作方式、Daybreak Red 模式的重要性、團隊應如何調整漏洞生命週期,以及安全有效運用模型所不可或缺的防護措施。