

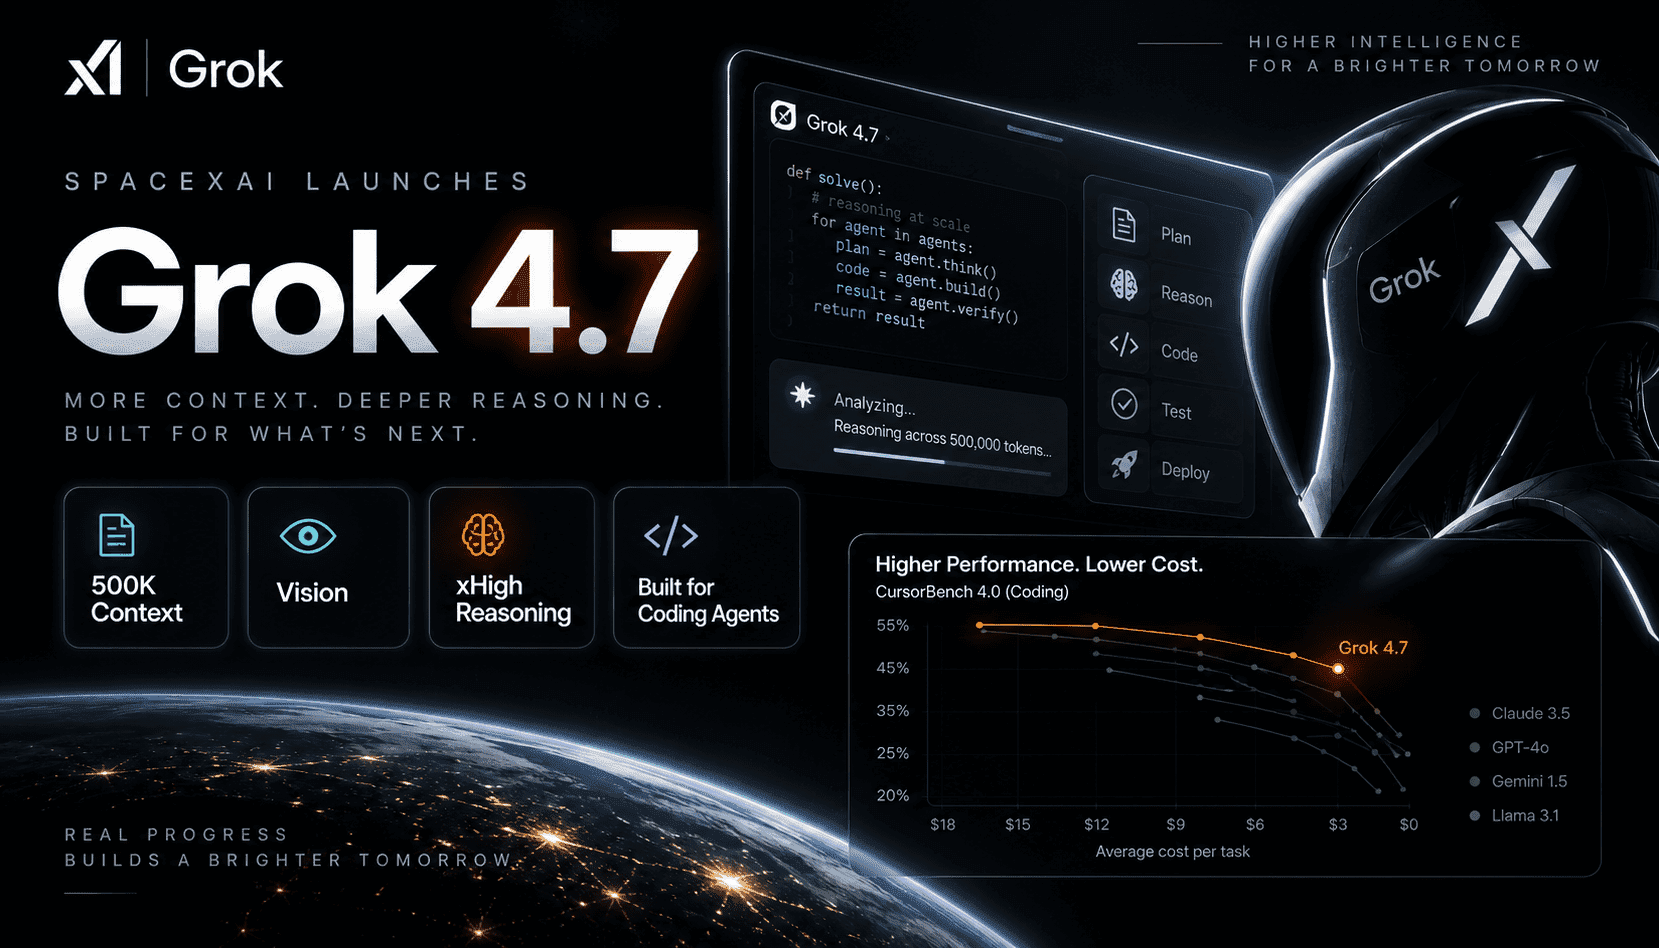
SpaceXAI 的 Grok 4.7 專為持續編碼與知識工作打造。50 萬字元的上下文視窗透過允許整個程式庫、多檔案差異或大量規格文件駐留記憶,降低檢索頻率。模型的本地視覺能力增強了除錯截圖、圖表審查與 UI 狀態說明的實用性。最重要的是,4.7 強調超高推理與自我驗證,實現更長且更可靠的多步驟執行,減少工具間的交接。以與 4.6 相同的價格階層提供,並有快速版本可選,直接瞄準開發者環境、編碼代理與多小時專業任務,解決先前上下文與驗證限制帶來的摩擦。
初步訊號顯示在長時間執行的程式任務中具備強勁的價格效能,CursorBench 4.0 上的改進以及多小時辦公與終端工作中的耐力提升。DeepSWE 與 EEBench 的成績暗示技術領域中更強的推理準確度與錯誤恢復能力,而模型的 harness-aware 訓練則旨在減少代理工作流程中的對話漂移。更長的上下文與更安全的預設組合應簡化架構:減少分塊技巧、更精簡的檢索器與更小的提示框架。對於處理大型規格或合規文件的團隊,4.7 擴展的工作記憶可將多次流程轉換為單次計劃,搭配上下文內的草稿板與結構化自我檢查。
安全性顯著提升。新的防護堆疊報告出更強的越獄抵抗力與更佳的雙重用途處理,且不會過度阻擋合法的安全工作。這對企業採用至關重要,因為代理系統經常與終端、程式碼執行及敏感資料交互。運營上,4.7 可透過 API、編碼 harness 與路由器使用,輸入每百萬字元 2 美元,輸出每百萬字元 6 美元,並提供速度與價格均為兩倍的快速選項。團隊應在真實工作負載上進行正面對決的試點,衡量任務完成品質、工具調用可靠性與每完成任務的總成本,而非單純延遲或單次基準分數。