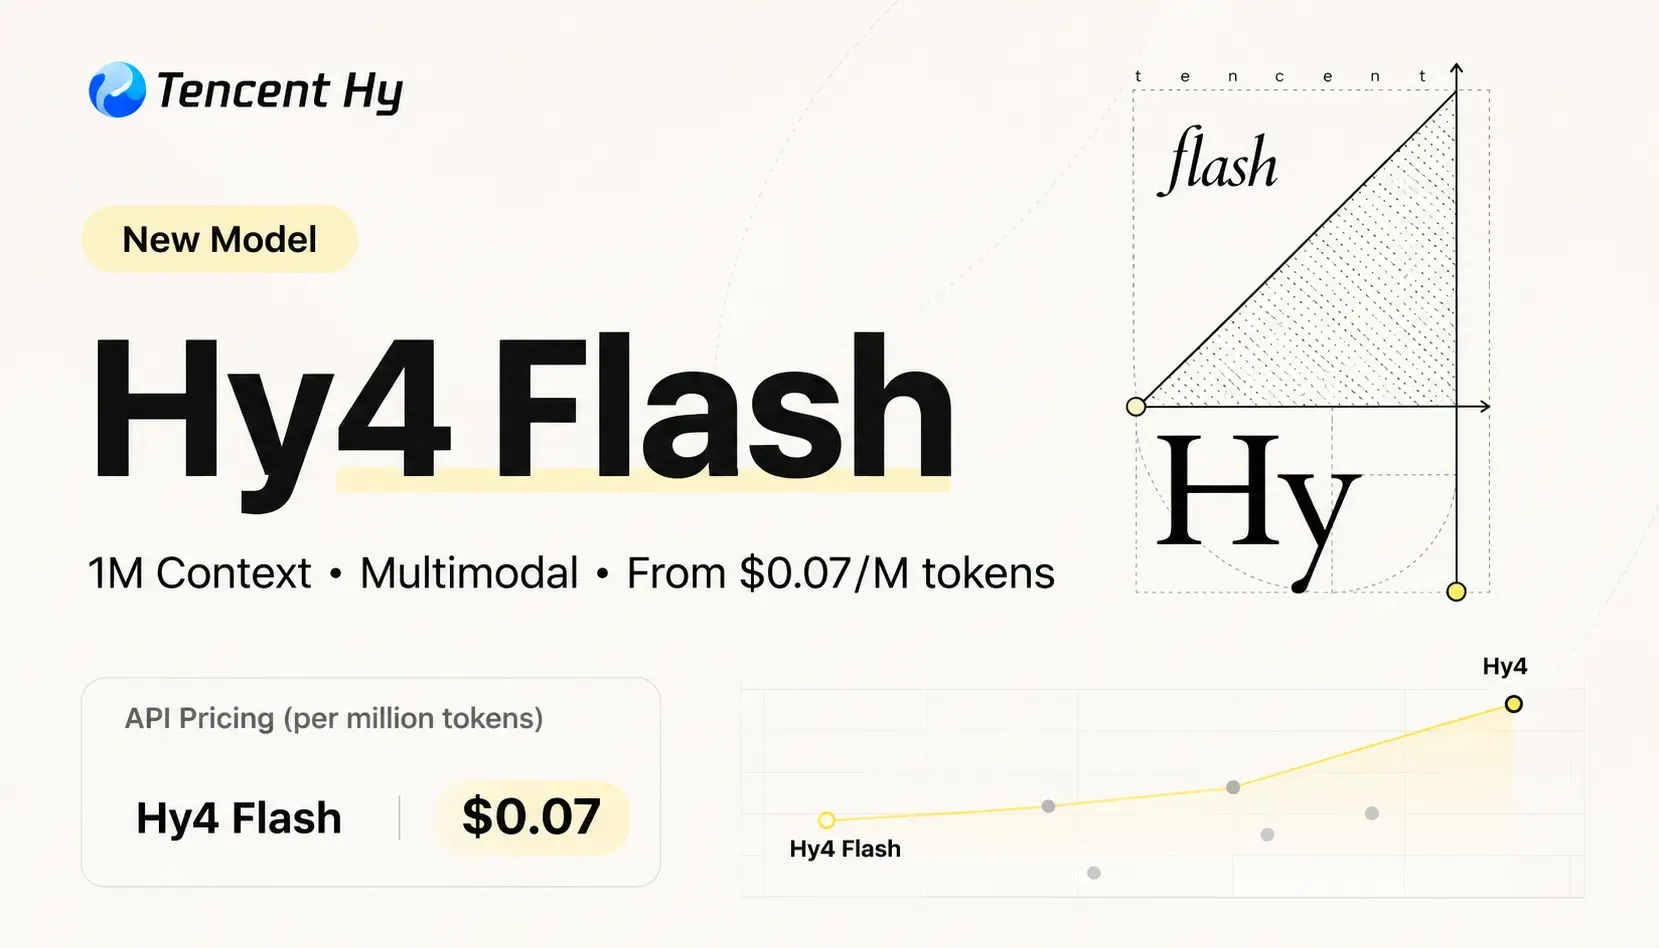
Tencent Hy4 flash的定位,是挑戰性價比,而非單純追求能力領先。模型總參數量達 224B,但推論時僅啟用 12B 參數,透過這種設計降低執行成本,同時保留龐大的離線容量。Tencent 強調其多模態輸入能力與 1,000,000 token 上下文視窗,並表示透過一系列推論最佳化,解碼速度可達每秒 150 個 token 以上。對正在評估模型選擇的團隊而言,Hy4 flash 提供務實的折衷方案:以遠低於部分前沿模型的單項任務成本,取得充足的上下文記憶與視覺理解能力。
Hy4 flash 採用了 Hy 系列逐步引入的多項架構技術:Engram 參數化可精簡儲存長期知識,LatentMoE 條件式容量可將運算集中在需要之處,混合式注意力則能有效擴展上下文。Tencent 也表示,模型大幅縮減了 KV cache 的占用量,這項工程取捨能降低推論時的記憶體需求與快取 I/O 成本。據稱,後訓練強化學習讓典型任務的平均輸出 token 長度減半,直接減少輸出 token 費用,也讓許多工作流程更快完成。
宣稱可支援 100 萬 token 上下文視窗,以及每秒超過 150 個 token 的解碼速度,是對企業部署最具實際意義的特色。Tencent 將這些成果歸功於多種技術的結合,包括 megakernel 最佳化、4 位元量化、DFly 執行策略,以及精簡的 KV cache。實際應用上,長上下文搭配快速解碼,可一次處理完整文件、簡報,或跨多個檔案的對話串,免去成本高昂的分塊處理、狀態串接或代理協調。如果模型在真實環境中也能穩健處理上下文,這些優勢便能降低工程複雜度與實際工作流程的延遲。
在成本方面,Tencent 列出的 API 參考價格約為每百萬輸入 token 0.070 美元、每百萬輸出 token 0.281 美元,快取輸入費率則極低。該公司聲稱,與較大型的 Hy4 版本及其他前沿模型相比,Hy4 flash 在其內部 WorkIndex 基準上的單項任務成本低得多。這樣的定位值得參考:對重視處理量、帳單可預測性與文件工作流程的組織而言,Hy4 flash 有望大幅降低營運支出。不過,買家應將 Tencent 的內部基準和盲測使用者結果視為參考,而非經過獨立驗證的定論;仍須以具代表性的第三方任務驗證成本與品質表現。