

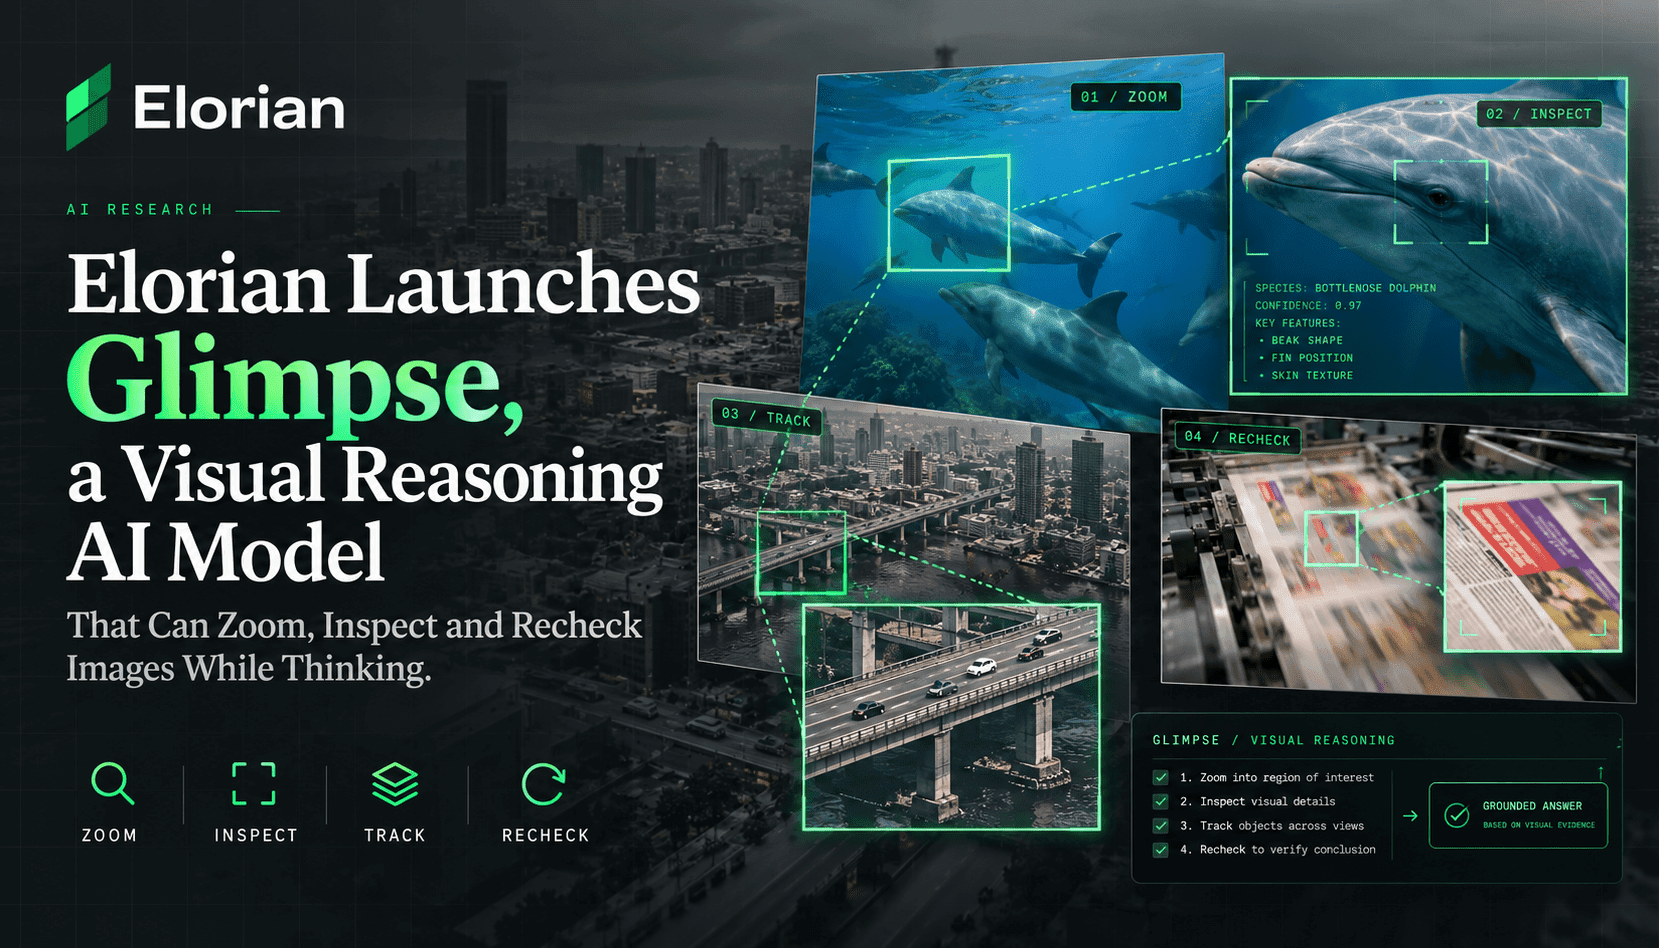
Elorian 的 Glimpse 标志着多模态系统处理视觉输入方式的一次有意转变。Glimpse 不会将图像或视频压缩成一串潜在 token,再基于这个冻结的摘要进行推理,而是保留一个可操作的“视觉草稿空间”,供模型在多步思考过程中反复查看。具体来说,模型可以裁剪某个区域、请求更密集的视频帧采样、追踪物体像素随时间的变化,或运行简短代码生成中间视觉结果。这样一来,模型对脆弱的单次感知流程依赖更少,也更能应对含糊或动态场景。
从系统设计角度看,关键的工程权衡在于计算和 token 预算与基于证据的准确性之间如何取舍。Glimpse 有意投入更多推理资源,重新检查证据,避免单次处理的方法凭记忆猜测。Elorian 称,这种密集复核在需要保持身份一致性、进行时序推理和精确计数的任务中表现更好;在特定基准测试上,其成绩可媲美甚至超过规模大得多的前沿模型。对团队而言,这意味着当视觉保真度、可追溯性和逐步验证比原始吞吐量更重要时,Glimpse 尤具吸引力。
采用 Glimpse 需要在产品和研究层面作出取舍:你能获得一个基于视觉证据进行推理的模型,但也要面对更复杂的编排工作——管理采样帧、草稿产物,并承担每次会话可能更高的 token 成本。Elorian 公布的单 token 价格明显低于若干前沿大语言模型,但其说明也证实,模型在深入思考时会使用更多 token。简而言之,Glimpse 有望提供更完善的证据链,并减少特定任务中的感知失误;但团队仍需衡量端到端延迟、单次决策成本和集成复杂度,判断迁移是否值得。
对采购者和开发者来说,实际结论很简单:应把 Glimpse 用在“重新检查视觉证据”是优势而非负担的工作流程中。它适用于机器人验证、实验室图表解读、制造质检,以及内容密集的视频字幕生成等场景,因为误报或身份信息丢失的代价很高。对于海量、低风险的标签任务,或对延迟要求极高的场景,在 token 效率进一步提升之前,传统的单次处理多模态模型可能仍是更合适的选择。