

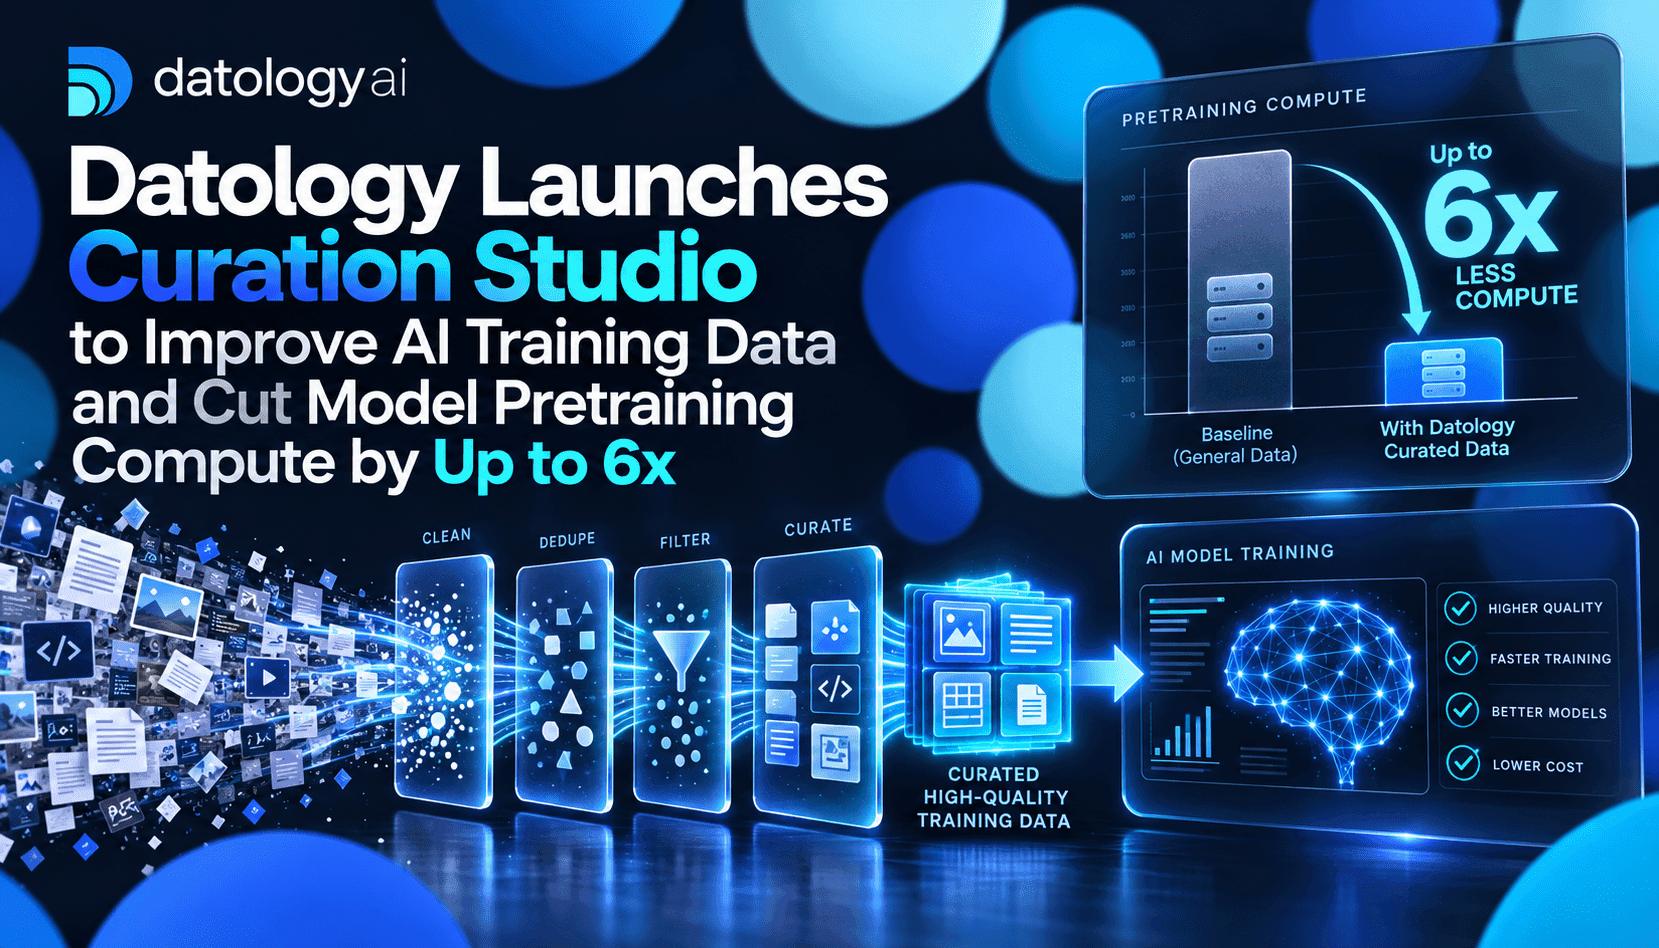
Datologys neues Curation Studio ist als operative Ebene zwischen Rohinhalten und Modelltraining konzipiert. Statt einfach immer größere Tokenmengen einzulesen, setzt das Produkt eine vierstufige Pipeline ein – Bereinigen, Kalibrieren, Erzeugen, Zusammenstellen –, um die wertvollsten Signale für die gewünschten Aufgaben herauszufiltern. Das ist relevant, weil Datologys Experimente zeigen, dass sich die effektive Leistung eines Modells durch die Kuratierung der Trainingsdaten deutlich effizienter steigern lässt als durch eine blinde Erhöhung der Pretraining-Rechenleistung. Für Engineering- und Produktteams verschiebt sich damit der Fokus – und die Budgetverteilung: weg von reinen GPU-Stunden, hin zu Data-Lifecycle-Engineering und Strategien zur synthetischen Datenerweiterung.
Das technische Grundprinzip ist vertraut, die Umsetzung erfolgt jedoch in großem Maßstab: gründliche Bereinigung und heuristische Filterung, Bewertung und Neugewichtung einzelner Dokumente, fundierte synthetische Generierung auf Basis hochwertiger Quellbeispiele sowie eine konfigurierbare Engine, die Teilmengen für verschiedene Trainingsphasen zusammenstellt. Datology zufolge zeigten Experimente, dass kleinere Modelle, die mit kuratierten Datensätzen und weniger Tokens trainiert wurden, größere Baselines erreichen oder übertreffen konnten, obwohl diese mit deutlich mehr Rechenleistung trainiert worden waren. Für Praktiker ist die unmittelbare Konsequenz klar: Pretraining-FLOPs lassen sich durch intelligentere Kuratierungsabläufe und kleinere, im Betrieb günstigere Modelle einsparen.
Die Kuratierung auf Frontier-Niveau im Unternehmensmaßstab umzusetzen, stellt erhebliche technische Anforderungen. Datology berichtet von Pipelines im Petabyte-Maßstab, eigens entwickelten Operator-Graphen und umfangreichem Caching von Zwischenergebnissen, um Hunderte Terabyte bis hin zu Petabytes zu verarbeiten, ohne Kosten oder Laufzeit ausufern zu lassen. Genau das unterscheidet Laborforschung von einem Produkt, das Teams in der VPC eines Kunden betreiben können. Für Unternehmen, die eigene Modelle entwickeln möchten, ist dieses Produktmodell entscheidend: Sie behalten die Kontrolle über ihre Daten, können deren Herkunft lückenlos nachvollziehen und müssen keine vertraulichen Rohdaten an externe Dienste übermitteln – und profitieren dennoch von fortschrittlichen Kuratierungstechniken.
Der geschäftliche Nutzen bemisst sich vor allem an zwei Kennzahlen: Modellleistung pro eingesetzter Pretraining-Rechenleistung und Inferenzkosten pro Aufgabe. Datologys Beispiele, in denen ein kuratiertes 12B-Modell, das mit weniger Tokens vortrainiert wurde, eine größere 30B-Baseline mit deutlich höherem Rechenaufwand übertraf, veranschaulichen, wie Kuratierung sowohl die Größe effektiver Produktionsmodelle als auch deren Trainingsbudget senken kann. Für Entscheidungsträger ist die Schlussfolgerung konkret: Investieren Sie früh in Datentools und Pipelines und konzipieren Sie Experimente so, dass sie die Leistung im Verhältnis zur Rechenleistung messen – nicht nur anhand der Tokenzahl.