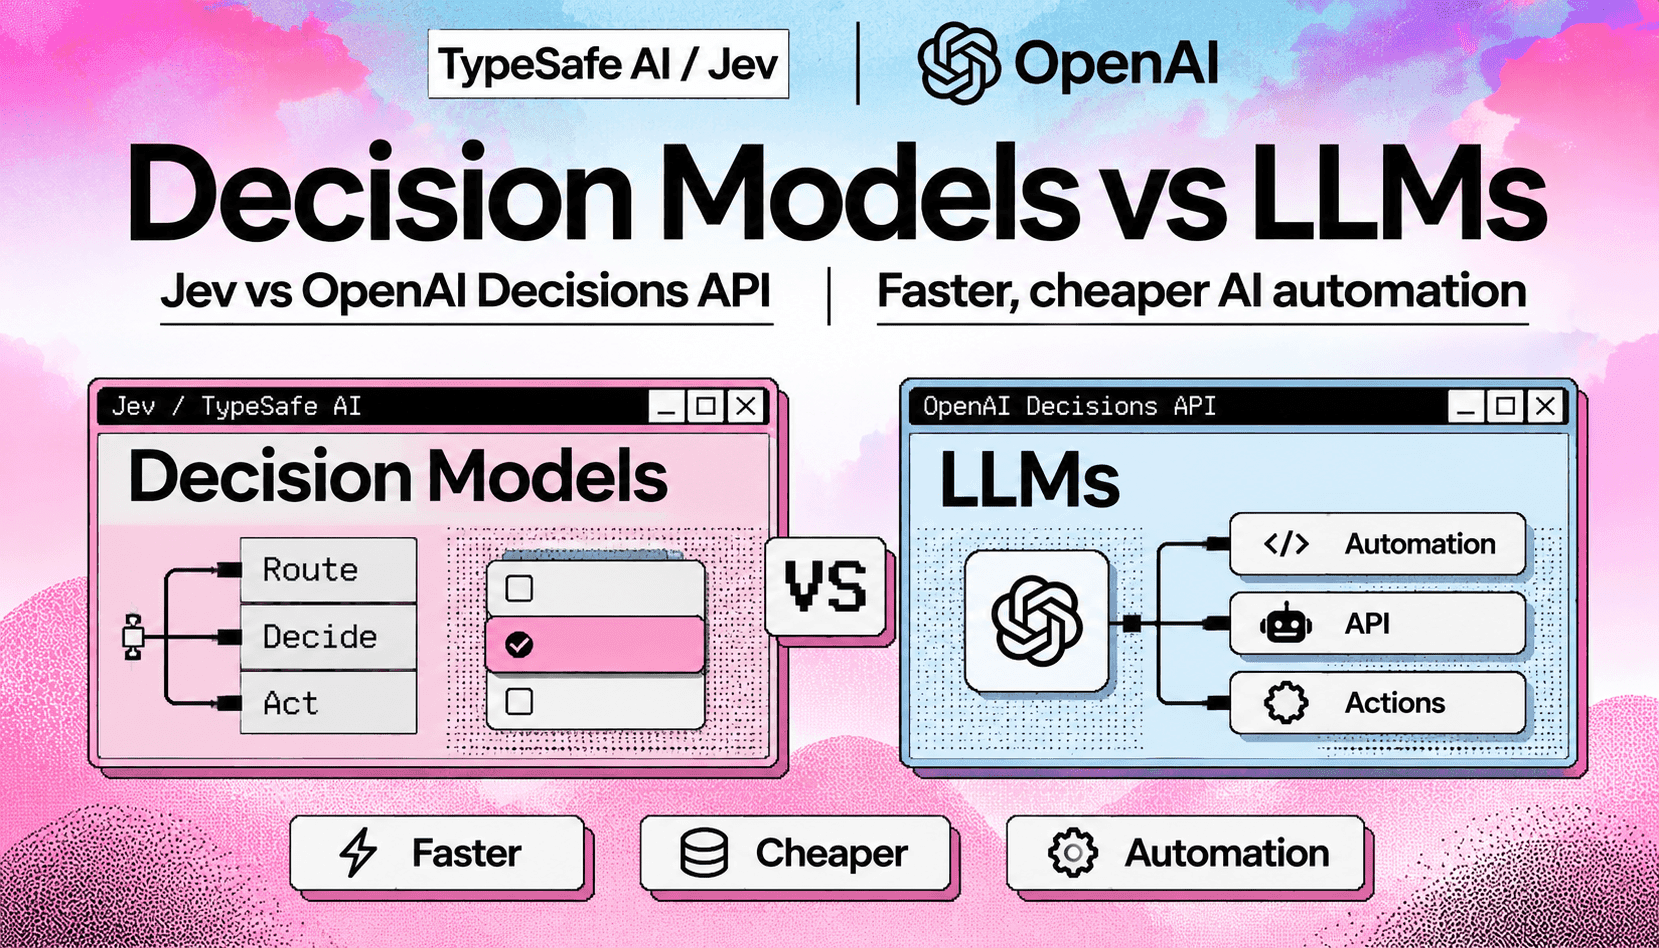
Entscheidungsmodelle wie Jev und die OpenAI Decisions API etablieren sich als schlanke Alternativen zu generativen LLMs für die Geschäftsautomatisierung mit hohem Durchsatz. Dieser Artikel vergleicht Klassifizierung, Latenz, Kosten, Konfidenzbewertung und Erklärbarkeit und zeigt praxisnahe Architekturen dafür, wann ein Entscheidungsmodell eingesetzt, wann ein LLM aufgerufen und wie beides kombiniert werden sollte.
Unternehmen, die Automatisierungspipelines aufbauen, stehen vor einem einfachen, aber hartnäckigen Problem: Generative LLMs sind flexibel, werden jedoch teuer und langsam, wenn sie für jede Weiterleitung, Bewertung oder binäre Entscheidung eingesetzt werden. Eine neue Klasse kompakter Entscheidungsmodelle – vertreten durch Produkte wie Jev und die OpenAI Decisions API – zielt genau auf diese Anwendungsfälle. Sie werden für deterministische Klassifizierungen trainiert, liefern kalibrierte Konfidenzwerte und sind auf geringere Latenz und niedrigere Rechenkosten als ein vollwertiges Reasoning-LLM ausgelegt. Dabei geht es nicht darum, LLMs zu ersetzen, sondern die Modellfähigkeiten passend zur jeweiligen Aufgabe einzusetzen, um vorhersehbare Kosten und eine verlässliche Leistung zu erzielen.
Entscheidungsmodelle eignen sich besonders für strukturierte Klassifizierungen, Weiterleitungen und die Durchsetzung von Richtlinien, wenn Eingaben einer relativ kleinen Anzahl möglicher Ergebnisse zugeordnet werden. In der Praxis umfasst das eine schnelle Klassifizierung von Absichten, die Unterscheidung zwischen Betrug und legitimen Vorgängen, einfache Anspruchsprüfungen oder umfangreiche Bewertungen, die nachgelagerte Agenten nutzen. Sie lassen sich als Microservices am Netzwerkrand oder in einer Regel-Engine bereitstellen und als erste Filterstufe vor dem Aufruf eines größeren Reasoning-Modells verwenden. Dank ihrer kompakten und vorhersehbaren Ausgaben ermöglichen sie engere Latenz-SLAs und eine einfachere Überwachung, als wenn sämtliche Aufgaben einem generativen Modell überlassen werden.
Dieser Artikel vergleicht repräsentative Entscheidungsmodelle (wie Jev) und die OpenAI Decisions API mit größeren generativen LLMs anhand messbarer Kriterien wie Latenz, Kosten pro Entscheidung, Konfidenzbewertung und Erklärbarkeit. Anschließend werden praxisnahe Architekturen skizziert, in denen Entscheidungsebenen mit LLMs kombiniert werden, um teure Aufrufe zu reduzieren, die Zuverlässigkeit zu verbessern und Reasoning-Fähigkeiten nur dort einzusetzen, wo sie gebraucht werden. Abschließend folgen Empfehlungen für den Betrieb: Wann sind Weiterleitungs- oder Bewertungsmodelle sinnvoll, wann sollte ein Reasoning-Pfad erhalten bleiben und wie lässt sich ein hybrider Stack instrumentieren, um Fehlleitungen zu erkennen und zu beheben?
Wann ein Entscheidungsmodell eingesetzt und wann ein Reasoning-LLM aufgerufen werden sollte
Beim Entwurf eines hybriden Stacks gilt eine einfache Regel: Deterministische, häufige und risikoarme Abläufe sollten einem Entscheidungsmodell überlassen werden. LLMs bleiben Aufgaben vorbehalten, die Synthese, ausführliches Schlussfolgern oder Kreativität erfordern. Entscheidungsmodelle eignen sich beispielsweise für die Klassifizierung von Absichten, die Filterung von Spam und Betrug oder Anspruchsprüfungen. Mehrdeutige Fälle oder Fälle mit niedriger Konfidenz werden für eine eingehendere Analyse an ein LLM weitergeleitet. Legen Sie einen Konfidenzschwellenwert und eine schnelle Fallback-Pipeline fest, damit das Entscheidungsmodell zugleich Kostenfilter und Sicherheitsnetz für das LLM ist: So werden teure Aufrufe begrenzt, ohne bei wirklich komplexen Fällen auf Reasoning-Fähigkeiten zu verzichten.
Ergänzen Sie im Betrieb Kennzahlen zur Verteilung der Weiterleitungen, zum Anteil der Eingaben, die an das LLM eskaliert werden, und zu den Fehlerraten beider Pfade. Setzen Sie in der frühen Produktionsphase vorsichtige Schwellenwerte und passen Sie diese an, sobald ausreichend gekennzeichnete Ergebnisse vorliegen. Dieses schrittweise Vorgehen senkt das Geschäftsrisiko und bietet eine messbare Stellschraube, um Kosten, Latenz und Genauigkeit gegeneinander abzuwägen.
Modelle kombinieren, um Kosten und Latenz von Agenten-Workflows zu senken
Hybride Agentenarchitekturen kombinieren eine schnelle Entscheidungsebene mit einem Reasoning-LLM, um teure Aufrufe in mehrstufigen Workflows auf ein Minimum zu reduzieren. Ein Agent kann beispielsweise ein Entscheidungsmodell verwenden, um eine Nutzeranfrage an ein spezialisiertes Tool weiterzuleiten. Ein LLM wird nur dann aufgerufen, wenn das Entscheidungsmodell eine niedrige Konfidenz ausgibt oder ein mehrstufiger Schlussfolgerungsschritt erforderlich ist. So sinkt die Zahl der tokenintensiven LLM-Aufrufe innerhalb von Agentenabläufen und die kumulierte Latenz wird reduziert. Außerdem wird die automatische Skalierung einfacher: Entscheidungsmodelle bewältigen Lastspitzen direkt, während eine deutlich kleinere LLM-Flotte Ausnahmefälle bearbeitet.
Hinweise für die praktische Umsetzung: Bevorzugen Sie binäre Ausgaben oder wenige Klassen für das Entscheidungsmodell, messen Sie die Ende-zu-Ende-Latenz an jedem Schritt und halten Sie einen schlanken Eskalationspfad bereit, der bei risikoreichen Ergebnissen auch eine menschliche Prüfung vorsieht. Besonders bei Systemen mit Fan-out – also der Weiterleitung zahlreicher Teilanfragen – summieren sich die Einsparungen, da jeder vermiedene LLM-Aufruf den gesamten Workflow entlastet.