Tencent Hy4 flash ist als preisbewusste Alternative konzipiert, nicht als uneingeschränkter Spitzenreiter bei den Fähigkeiten. Das Modell vereint insgesamt 224 Milliarden Parameter, von denen bei der Inferenz lediglich 12 Milliarden aktiv sind. So sollen die Laufzeitkosten sinken, ohne auf umfangreiche Kapazitäten im Hintergrund zu verzichten. Tencent hebt multimodale Eingaben und ein Kontextfenster von 1.000.000 Tokens hervor und gibt an, dank verschiedener Inferenzoptimierungen mehr als 150 Tokens pro Sekunde dekodieren zu können. Für Teams, die Modelle vergleichen, verspricht Hy4 flash einen pragmatischen Mittelweg: viel Kontext und visuelles Verständnis zu einem Bruchteil der Kosten pro Aufgabe, die bei manchen Frontier-Alternativen anfallen.
Unter der Haube nutzt Hy4 flash Architekturmerkmale, die über die Hy-Modellreihe hinweg eingeführt wurden: Engram-Parametrisierung zur kompakten Speicherung langfristigen Wissens, die bedingte Kapazität von LatentMoE, um Rechenleistung gezielt einzusetzen, sowie hybride Attention für eine effiziente Skalierung des Kontextfensters. Tencent berichtet außerdem von einem deutlich kleineren KV-Cache – ein bewusster technischer Kompromiss, der Speicherbedarf und Cache-I/O-Kosten bei der Inferenz senkt. Dem Reinforcement Learning nach dem Training wird zugeschrieben, die durchschnittliche Länge der ausgegebenen Tokens bei typischen Aufgaben halbiert zu haben. Das senkt unmittelbar die Kosten für Ausgabetokens und beschleunigt viele Arbeitsabläufe.
Das angegebene Kontextfenster von 1 Mio. Tokens und die Dekodierungsgeschwindigkeit von über 150 Tokens pro Sekunde sind für den Unternehmenseinsatz besonders relevant. Tencent führt diese Werte auf das Zusammenspiel mehrerer Verfahren zurück: Megakernel-Optimierung, 4-Bit-Quantisierung, DFly-Ausführungsstrategien und einen kompakten KV-Cache. In der Praxis ermöglichen ein langer Kontext und schnelles Dekodieren, ganze Dokumente, Foliensätze oder Unterhaltungen mit mehreren Dateien in einem Durchgang zu verarbeiten – ohne aufwendiges Aufteilen in Abschnitte, Zusammenführen von Zuständen oder Orchestrieren von Agenten. Wenn das Modell den Kontext auch unter realen Bedingungen zuverlässig verarbeitet, können diese Vorteile die technische Komplexität und Latenz in Kunden-Workflows verringern.
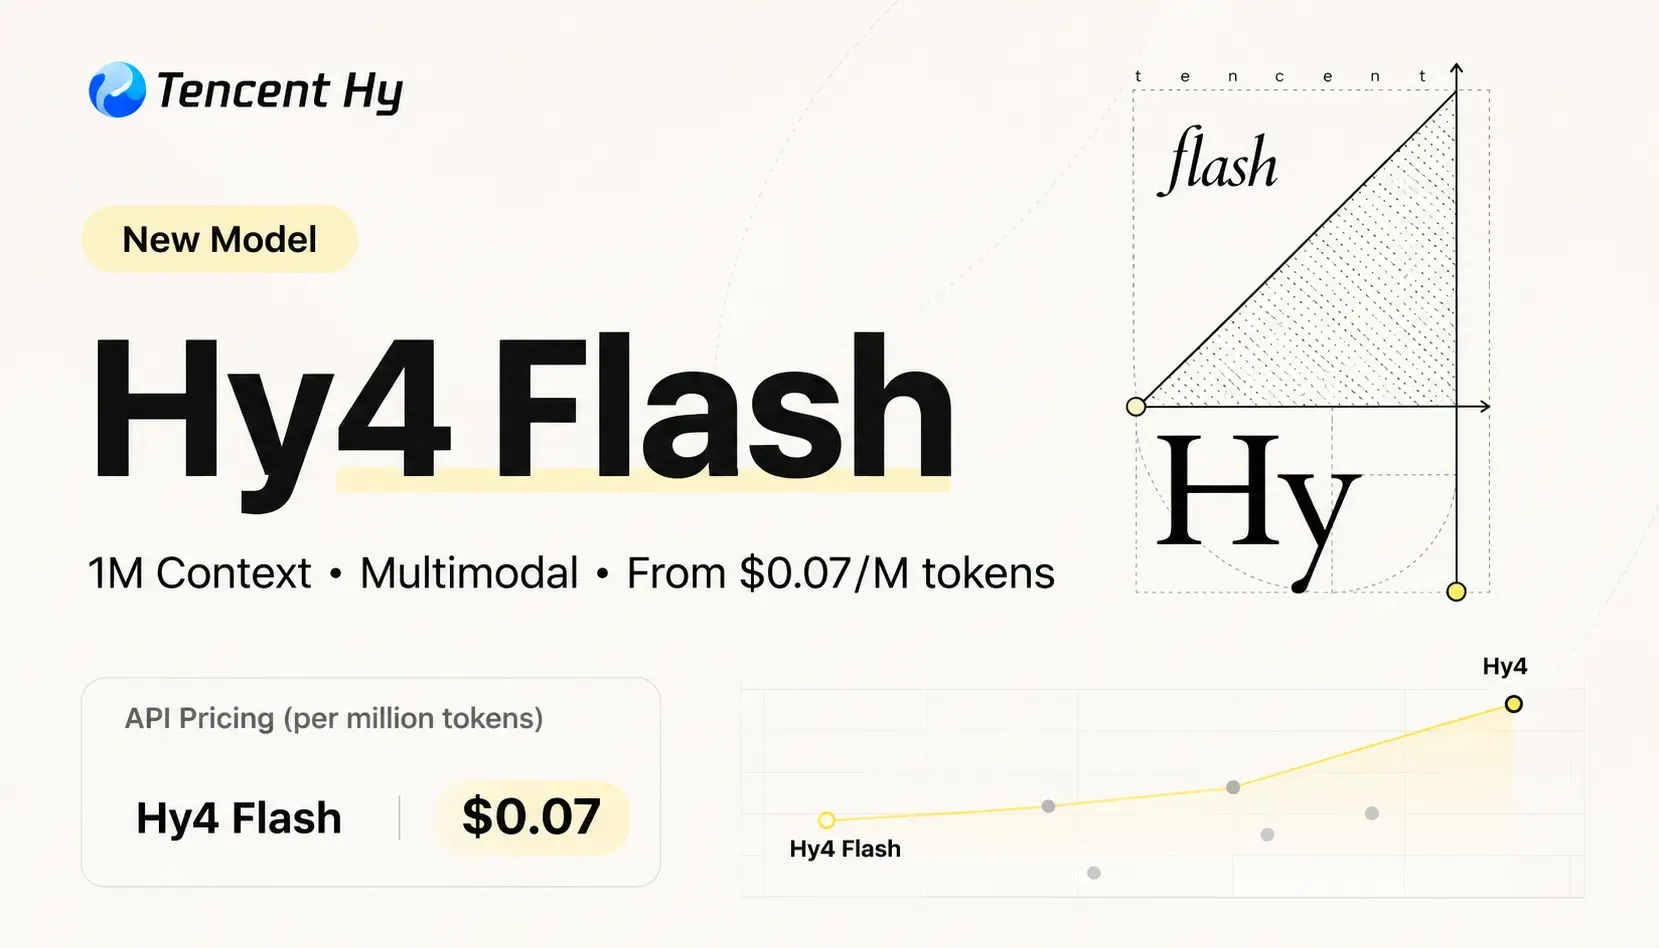
Tencent nennt ungefähre API-Preise von 0,070 US-Dollar pro Million Eingabetokens und 0,281 US-Dollar pro Million Ausgabetokens sowie einen besonders niedrigen Tarif für gecachte Eingaben. Nach Angaben des Unternehmens verursacht Hy4 flash beim internen WorkIndex deutlich geringere Kosten pro Aufgabe als größere Hy4-Varianten und andere Frontier-Modelle. Diese Perspektive ist hilfreich: Für Unternehmen, denen Durchsatz, planbare Kosten und dokumentenbasierte Arbeitsabläufe wichtig sind, könnte Hy4 flash die Betriebsausgaben spürbar senken. Die internen Benchmarks und Ergebnisse mit verblindeten Nutzern von Tencent sollten jedoch als Anhaltspunkte und nicht als unabhängig bestätigte Belege gelten. Kosten und Qualität müssen anhand repräsentativer Aufgaben von Drittanbietern überprüft werden.