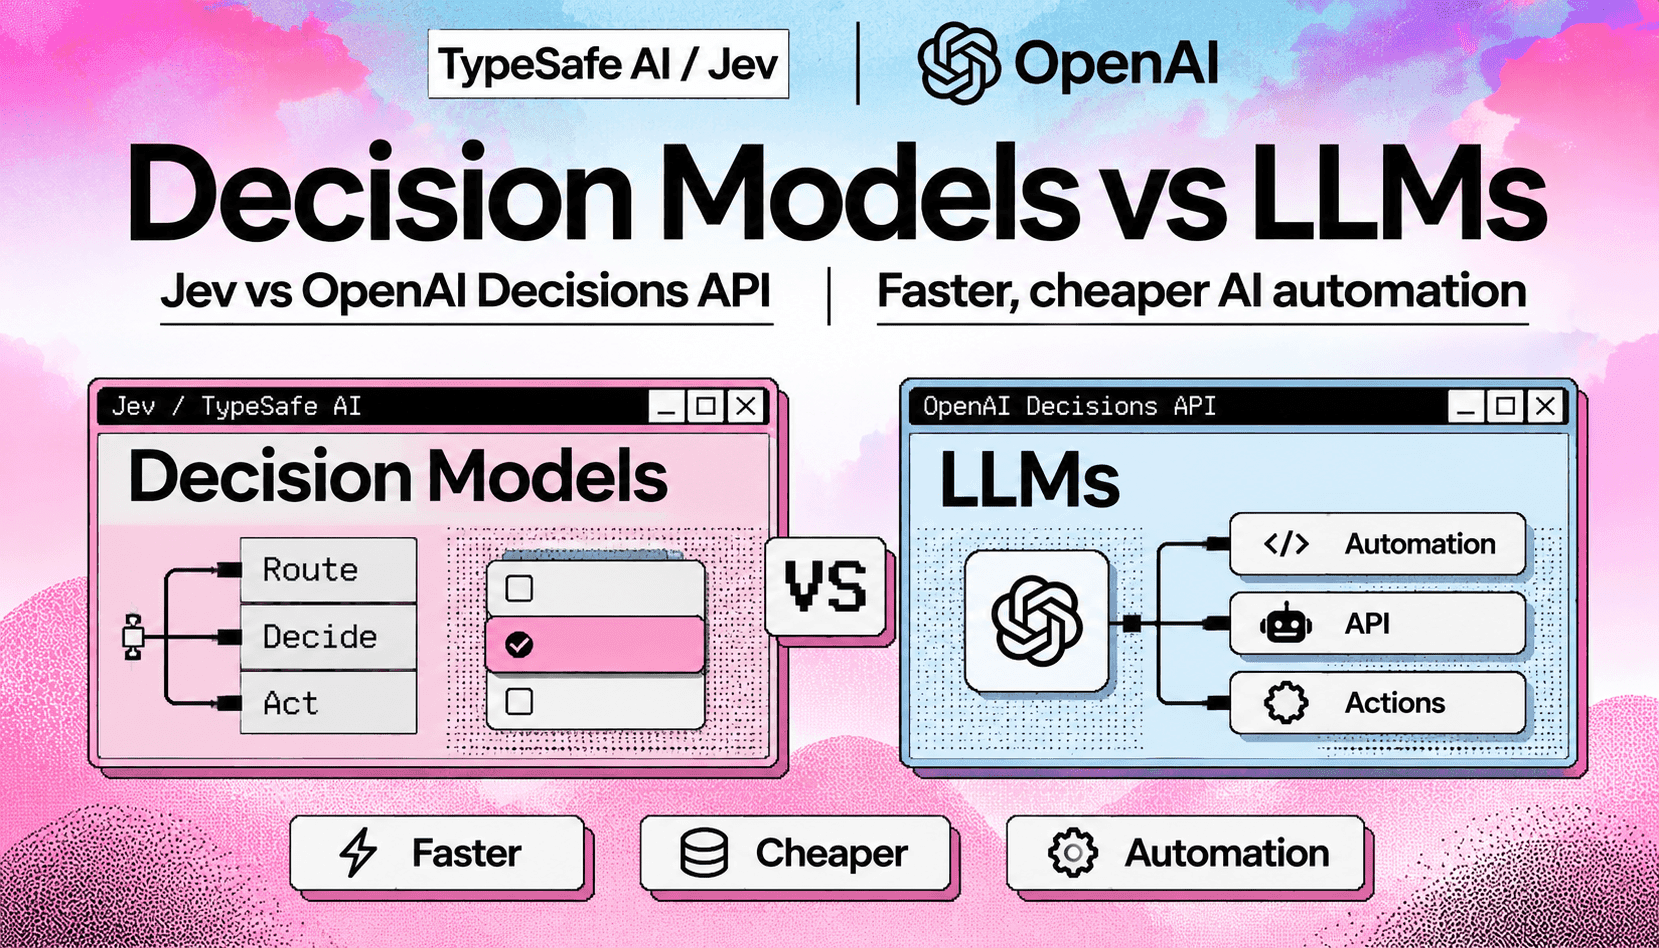
Las empresas que crean flujos de automatización se enfrentan a un problema sencillo y persistente: los LLM generativos son flexibles, pero resultan costosos y lentos cuando se usan para cada decisión de enrutamiento, puntuación o clasificación binaria. Una nueva clase de modelos de decisión compactos —representada por productos como Jev y Decisions API de OpenAI— está diseñada precisamente para estos casos de uso. Se entrenan para realizar clasificaciones deterministas, ofrecen resultados de confianza calibrados y están optimizados para funcionar con menor latencia y menos costo computacional que un LLM de razonamiento completo. Este cambio no busca reemplazar los LLM, sino adaptar la capacidad del modelo a cada tarea para lograr costos y rendimiento predecibles.
Los modelos de decisión destacan en tareas de clasificación estructurada, enrutamiento y aplicación de políticas, donde las entradas corresponden a un conjunto relativamente pequeño de resultados. En la práctica, esto incluye clasificar intenciones rápidamente, determinar si una operación es fraudulenta, realizar comprobaciones sencillas de elegibilidad o generar puntuaciones con múltiples características para los agentes posteriores. Pueden implementarse como microservicios en el borde o dentro de un motor de reglas, y utilizarse como filtro inicial antes de invocar un modelo de razonamiento más grande. Como sus resultados son compactos y predecibles, permiten establecer acuerdos de nivel de servicio (SLA) de latencia más estrictos y simplifican la supervisión, en lugar de delegarlo todo a un modelo generativo.
Este artículo compara aspectos medibles —latencia, costo por decisión, puntuación de confianza y explicabilidad— de modelos de decisión representativos, como Jev, y Decisions API de OpenAI frente a LLM generativos de mayor tamaño. Después, presenta arquitecturas prácticas que combinan capas de decisión con LLM para reducir las llamadas costosas, mejorar la fiabilidad y reservar la capacidad de razonamiento para los casos que realmente la necesitan. Para terminar, ofrece recomendaciones operativas: cuándo elegir modelos de enrutamiento o puntuación, cuándo mantener una ruta de razonamiento y cómo instrumentar la arquitectura híbrida para detectar y mitigar errores de enrutamiento.