Hy4 flash de Tencent está concebido para competir en precio y rendimiento, no para liderar en capacidades a toda costa. El modelo combina 224.000 millones de parámetros totales con solo 12.000 millones activos durante la inferencia, un diseño que busca reducir los costes de ejecución sin renunciar a una gran capacidad latente. Tencent destaca las entradas multimodales y una ventana de contexto de 1.000.000 de tokens, y afirma que alcanza velocidades de decodificación superiores a 150 tokens por segundo gracias a diversas optimizaciones de inferencia. Para los equipos que evalúan qué modelo elegir, Hy4 flash promete un punto medio práctico: una memoria contextual amplia y comprensión visual a una fracción del coste por tarea de algunas alternativas de frontera.
Por dentro, Hy4 flash incorpora características arquitectónicas introducidas en la familia Hy: la parametrización Engram, que almacena conocimientos a largo plazo de forma compacta; la capacidad condicional LatentMoE, que concentra el cómputo donde hace falta; y la atención híbrida, que permite ampliar el contexto de forma eficiente. Tencent también informa de una reducción considerable de la huella de la caché KV, una decisión de ingeniería deliberada que disminuye el uso de memoria y el coste de acceso a la caché durante la inferencia. Según la empresa, el aprendizaje por refuerzo posterior al entrenamiento redujo a la mitad la longitud media de los tokens de salida en tareas habituales, lo que disminuye directamente la facturación por tokens de salida y agiliza muchos flujos de trabajo.
La ventana de contexto anunciada de 1 millón de tokens y la velocidad de decodificación superior a 150 tokens por segundo son las características más relevantes en la práctica para implementaciones empresariales. Tencent atribuye estos resultados a la combinación de varias técnicas: optimización de megakernels, cuantización de 4 bits, estrategias de ejecución DFly y una caché KV compacta. En la práctica, un contexto extenso combinado con una decodificación rápida permite procesar en una sola pasada documentos completos, presentaciones o conversaciones con varios archivos, sin recurrir a fragmentaciones costosas, a reconstruir estados ni a orquestar agentes. Si el manejo del contexto del modelo demuestra ser robusto en condiciones reales, estas ventajas pueden reducir la complejidad de ingeniería y la latencia en los flujos de trabajo de los clientes.
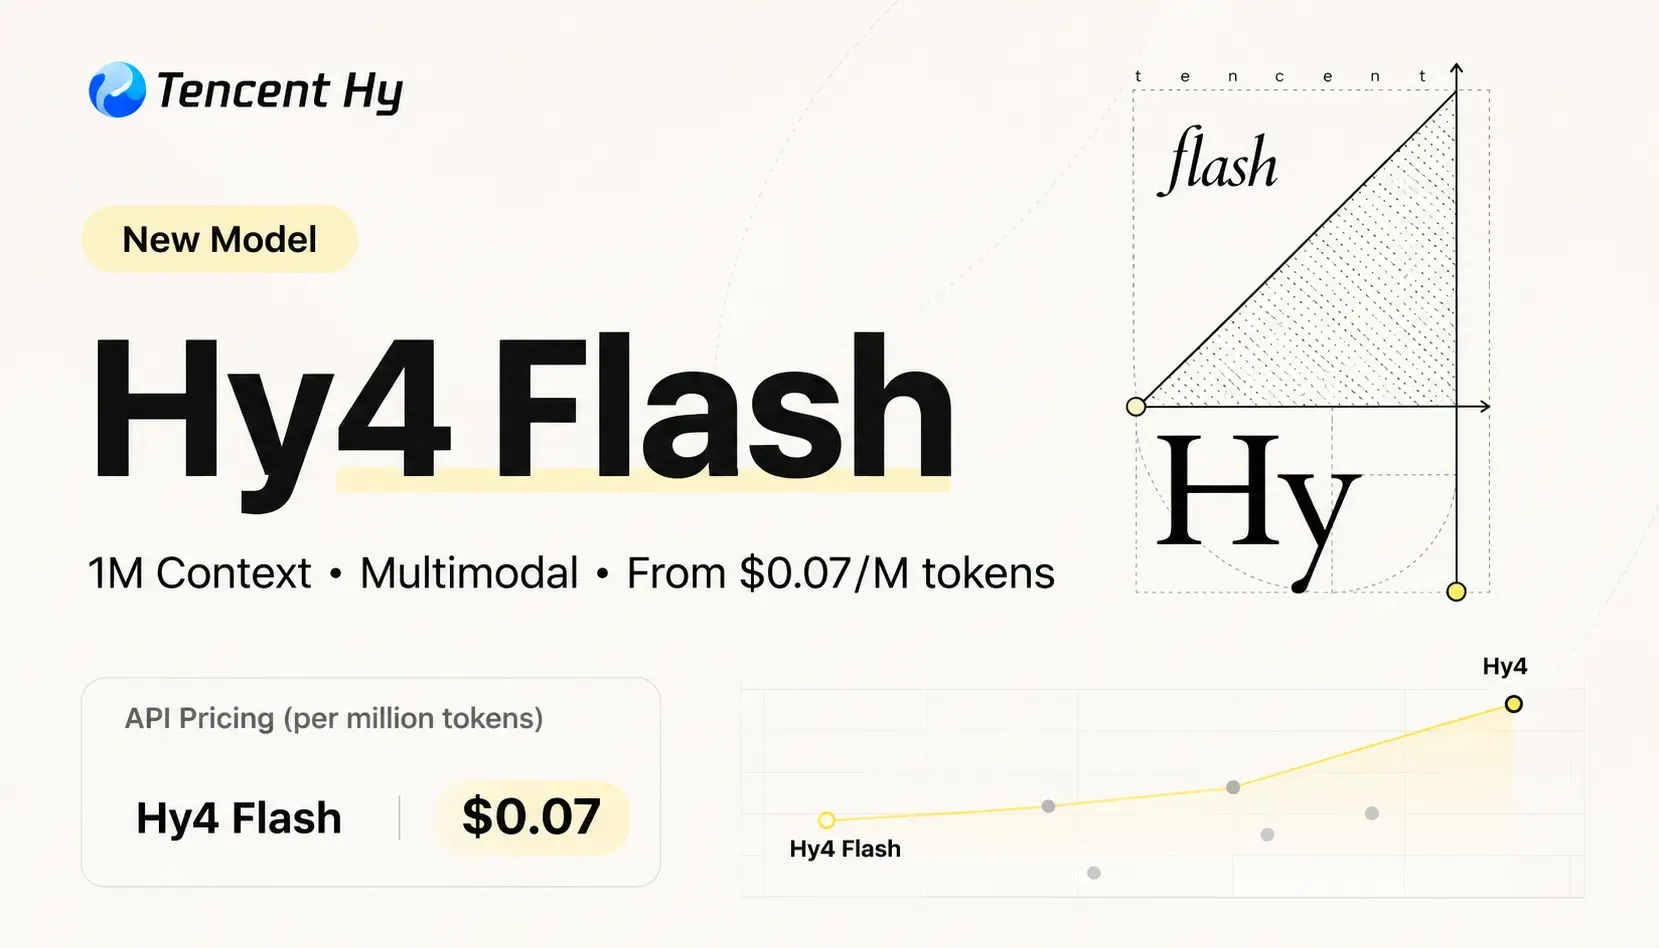
En cuanto a costes, Tencent publica precios aproximados de 0,070 dólares por millón de tokens de entrada y 0,281 dólares por millón de tokens de salida, además de una tarifa muy baja para las entradas almacenadas en caché. La empresa afirma que Hy4 flash reduce considerablemente el coste por tarea en su evaluación interna WorkIndex frente a variantes más grandes de Hy4 y otros modelos de frontera. Es una perspectiva útil: para las organizaciones que priorizan el rendimiento, la previsibilidad de los costes y los flujos de trabajo con documentos, Hy4 flash podría reducir de forma sustancial el gasto operativo. Sin embargo, conviene tomar los benchmarks internos de Tencent y los resultados de evaluaciones a ciegas como referencias informativas, no como pruebas verificadas de forma independiente. La calidad y el coste comparativos deben validarse con tareas representativas y de terceros.