

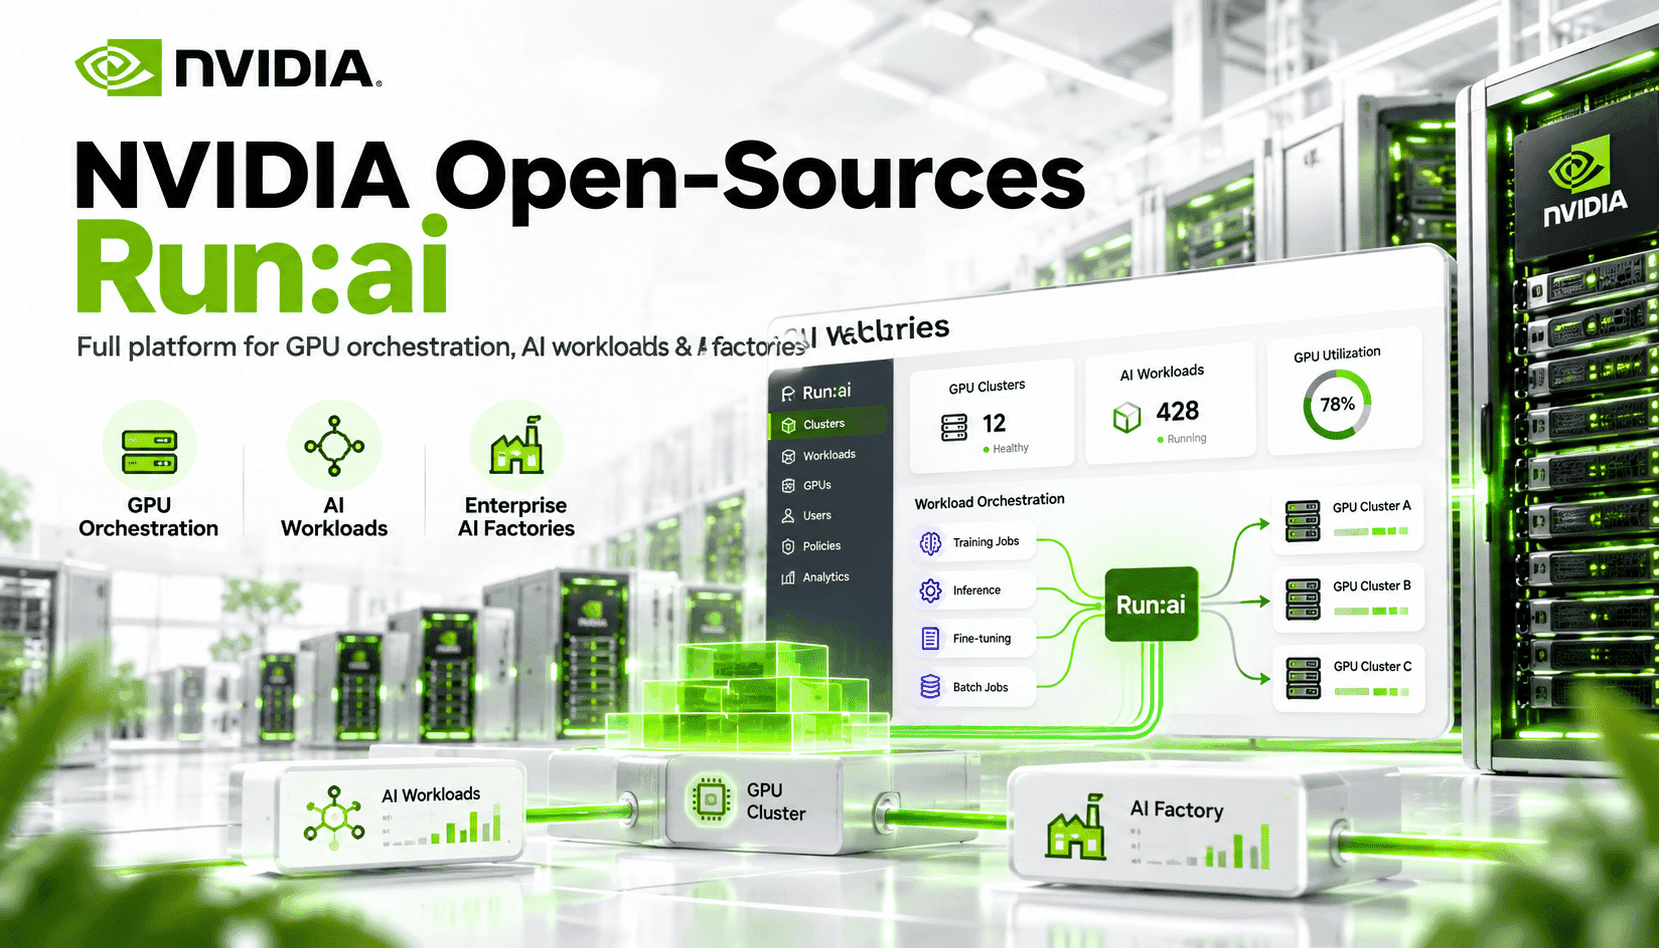
La publicación como código abierto de la plataforma Run:ai completa por parte de NVIDIA marca un punto de inflexión práctico para las empresas que están construyendo infraestructura privada de IA. En lugar de adaptar un planificador cerrado y una capa para compartir recursos, ahora las organizaciones pueden inspeccionar y modificar KAI Scheduler, GPU Fractioning Operator, KAI Resource Management y Workload Map. Esa visibilidad es importante: los equipos de plataforma obtienen una base nativa de Kubernetes, probada en producción, que ya incorpora programación de grupos de trabajos, reconocimiento de la topología, cuotas de reparto equitativo y particionado de memoria nativo de CUDA. El resultado es inmediato: menos soluciones improvisadas, una integración más rápida con las herramientas de clúster existentes y un contrato común para cargas de trabajo de IA con varios componentes.
En la práctica operativa, Run:ai aborda tres problemas persistentes de las empresas. Primero, la infrautilización de las GPU: al permitir fracciones de GPU asignadas de forma estricta y el uso compartido gestionado por el planificador, los equipos pueden ejecutar muchas cargas de trabajo pequeñas a la vez sin sobreasignar memoria. Segundo, la gobernanza entre equipos: KAI Resource Management incorpora un modelo de cuotas que tiene en cuenta la estructura organizativa, de modo que los equipos de investigación, plataforma y producción obtengan garantías explícitas y una aplicación equitativa de los recursos. Tercero, la diversidad de cargas de trabajo: Workload Map estandariza distintos CRD y trabajos con varios pods para que las herramientas y los procesos de SRE los gestionen de manera coherente. En conjunto, estas funciones reducen el trabajo manual de programación y permiten planificar la capacidad de forma más predecible.
Desde la perspectiva de la pila tecnológica, Run:ai encaja de forma natural en las fábricas de IA basadas en Kubernetes. KAI Scheduler es un planificador especializado, aportado al sandbox de la CNCF, que puede desplegarse junto con otros planificadores e integrar ubicación consciente de la topología, semántica de grupos de trabajos y señales para compartir GPU. GPU Fractioning Operator conecta el particionado nativo de CUDA 13.4 con Kubernetes y expone la asignación de memoria por pod y sus métricas. Workload Map evita repetir la configuración de CRD en paneles, escaladores automáticos y herramientas de costes. Para las empresas que ya usan Kubernetes, esto supone menos controladores a medida y una ruta de migración más clara de los scripts improvisados a la orquestación declarativa.
Las opciones de adopción varían según las necesidades. Los equipos pequeños pueden desplegar solo los componentes que necesitan; por ejemplo, incorporar GPU Fractioning Operator para abaratar las ejecuciones de notebooks e inferencia, y conservar el planificador existente. Los equipos de plataforma que busquen un control unificado adoptarán KAI Scheduler y KAI Resource Management en conjunto y quizá aporten al proyecto mejoras específicas de su entorno. Los socios del ecosistema y los proveedores de servicios gestionados ofrecerán pilas preintegradas y validadas para quienes necesiten acelerar la puesta en producción o contar con soporte empresarial. En todos los casos, el código abierto reduce las dificultades de integración y amplía las posibilidades de contribuir con correcciones e innovaciones.