

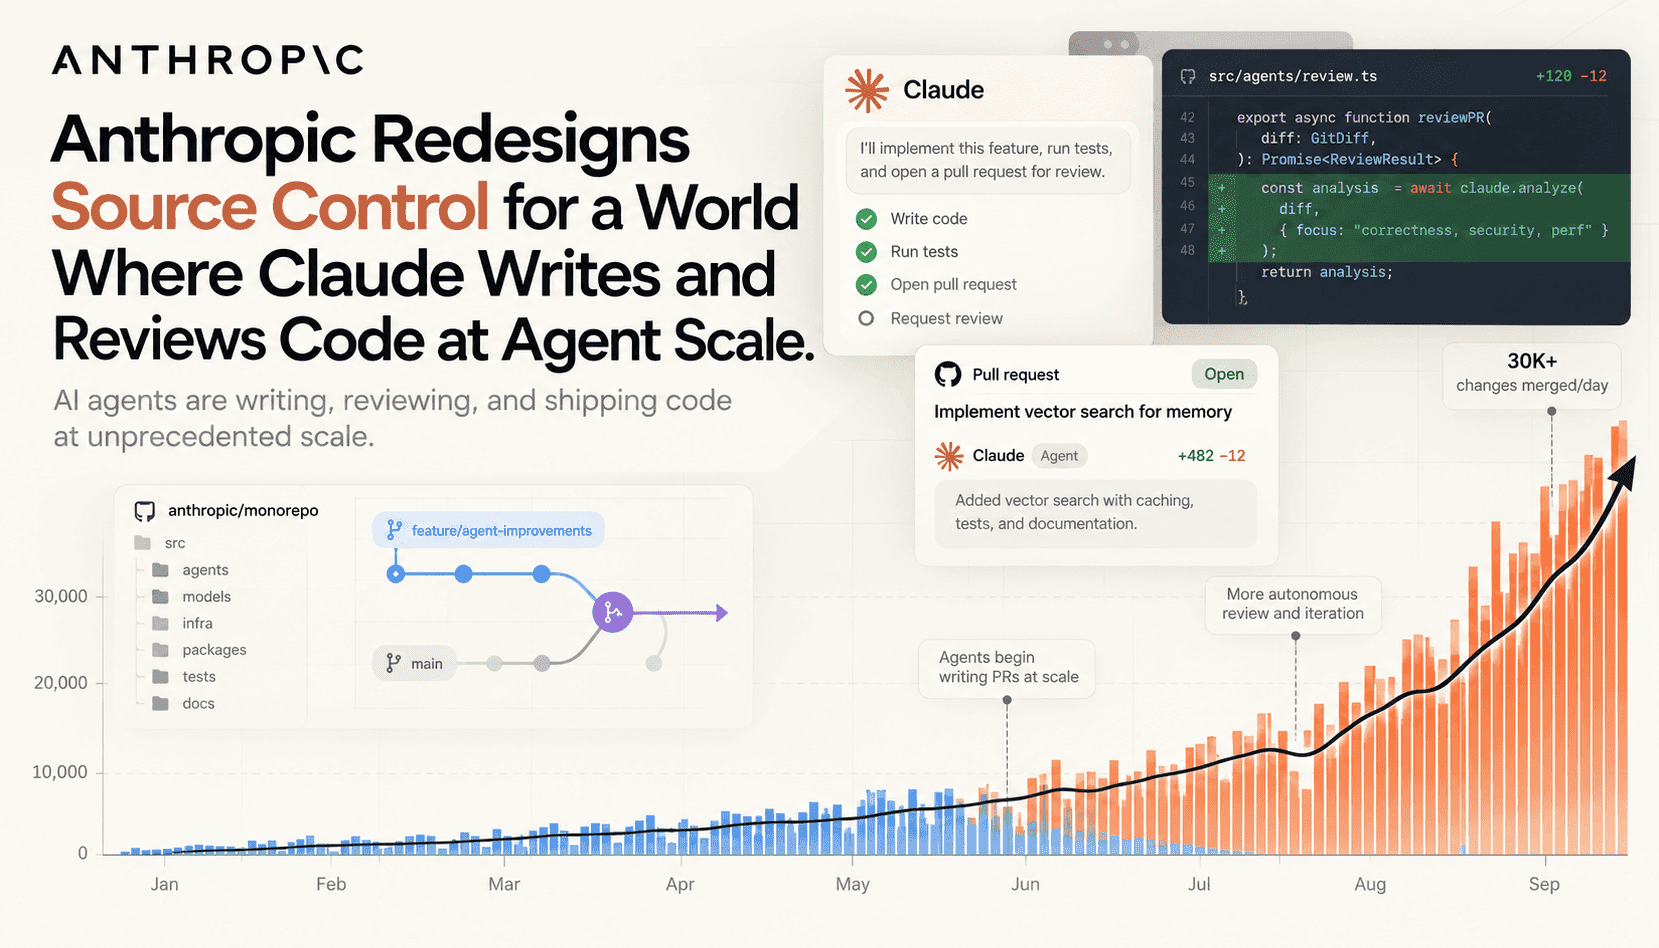
La migration d’Anthropic de Git vers un système maison, Scion, répond à un tournant opérationnel majeur : des agents autonomes, notamment Claude, ont commencé à produire et à fusionner des dizaines de milliers de modifications par jour, mettant à mal les hypothèses intégrées à des outils conçus pour des flux de travail à échelle humaine. L’entreprise a constaté que les principes de décentralisation — clones complets, échanges fondés sur des fichiers pack et références locales — devenaient un handicap lorsque la plupart des clients étaient des agents en ligne n’ayant besoin que de certaines parties d’un dépôt. Scion reformule le problème : il mise sur des métadonnées à haut débit gérées par le serveur et sur la livraison parcimonieuse des fichiers. Cette nouvelle approche a des conséquences sur la conception des pipelines, le suivi de l’état du système et l’audit des modifications.
Au cœur de Scion, les opérations sur le graphe complet de Git sont remplacées par des ensembles de modifications côté serveur et des index dérivés calculés à partir de ces ensembles. Au lieu de distribuer des fichiers pack immuables à chaque client, Scion fournit des objets binaires adressés par leur contenu, des requêtes ciblées sur l’arborescence et des API serveur pour l’annotation des lignes, l’ascendance et les différences. La copie de travail est facultative : les tâches de CI et de recherche peuvent interroger les métadonnées du serveur ou ne matérialiser que les chemins qu’elles consultent. Cette évolution réduit considérablement l’utilisation du réseau, du processeur et du stockage, tout en rendant la création de commits peu coûteuse et sans verrouillage — une nécessité lorsque le nombre de fusions quotidiennes est multiplié par dix.
Sur le plan opérationnel, ce changement impose de repenser l’ensemble des outils : la CI, la revue de code, la gestion des identités et des accès (IAM) et l’observabilité doivent désormais partir du principe que le système de contrôle de version est centré sur le serveur. Les récupérations et les compilations s’appuient sur des caches et des serveurs à plusieurs niveaux plutôt que sur des clones volumineux provenant de miroirs. Les données dérivées — index d’annotation, historiques de chemins, listes de sauts — doivent être calculées et stockées de manière incrémentale. Le choix entre calcul anticipé et à la demande a un effet direct sur la latence, le stockage et les coûts d’exploitation. Les équipes devront revoir l’initialisation des tâches, l’expérience de développement en local et la planification des capacités, en privilégiant les caches d’objets, les récupérations reprenables et l’isolation régionale.
Pour les responsables de l’ingénierie, les questions pratiques se posent dès maintenant : comment faire confiance aux modifications générées par des agents à grande échelle, instrumenter et faire respecter les politiques, et éviter de créer un point de coordination unique ? L’expérience d’Anthropic montre qu’on peut y répondre en combinant application des politiques côté serveur, interfaces de revue programmatiques, pipelines de validation adversariale et usage prudent des références. Les compromis techniques — moins d’autonomie locale, davantage de calcul centralisé et une nouvelle charge de maintenance des données dérivées — sont compensés par des gains considérables en rapidité et en reproductibilité, ainsi que par la capacité à opérer à l’échelle des agents.