

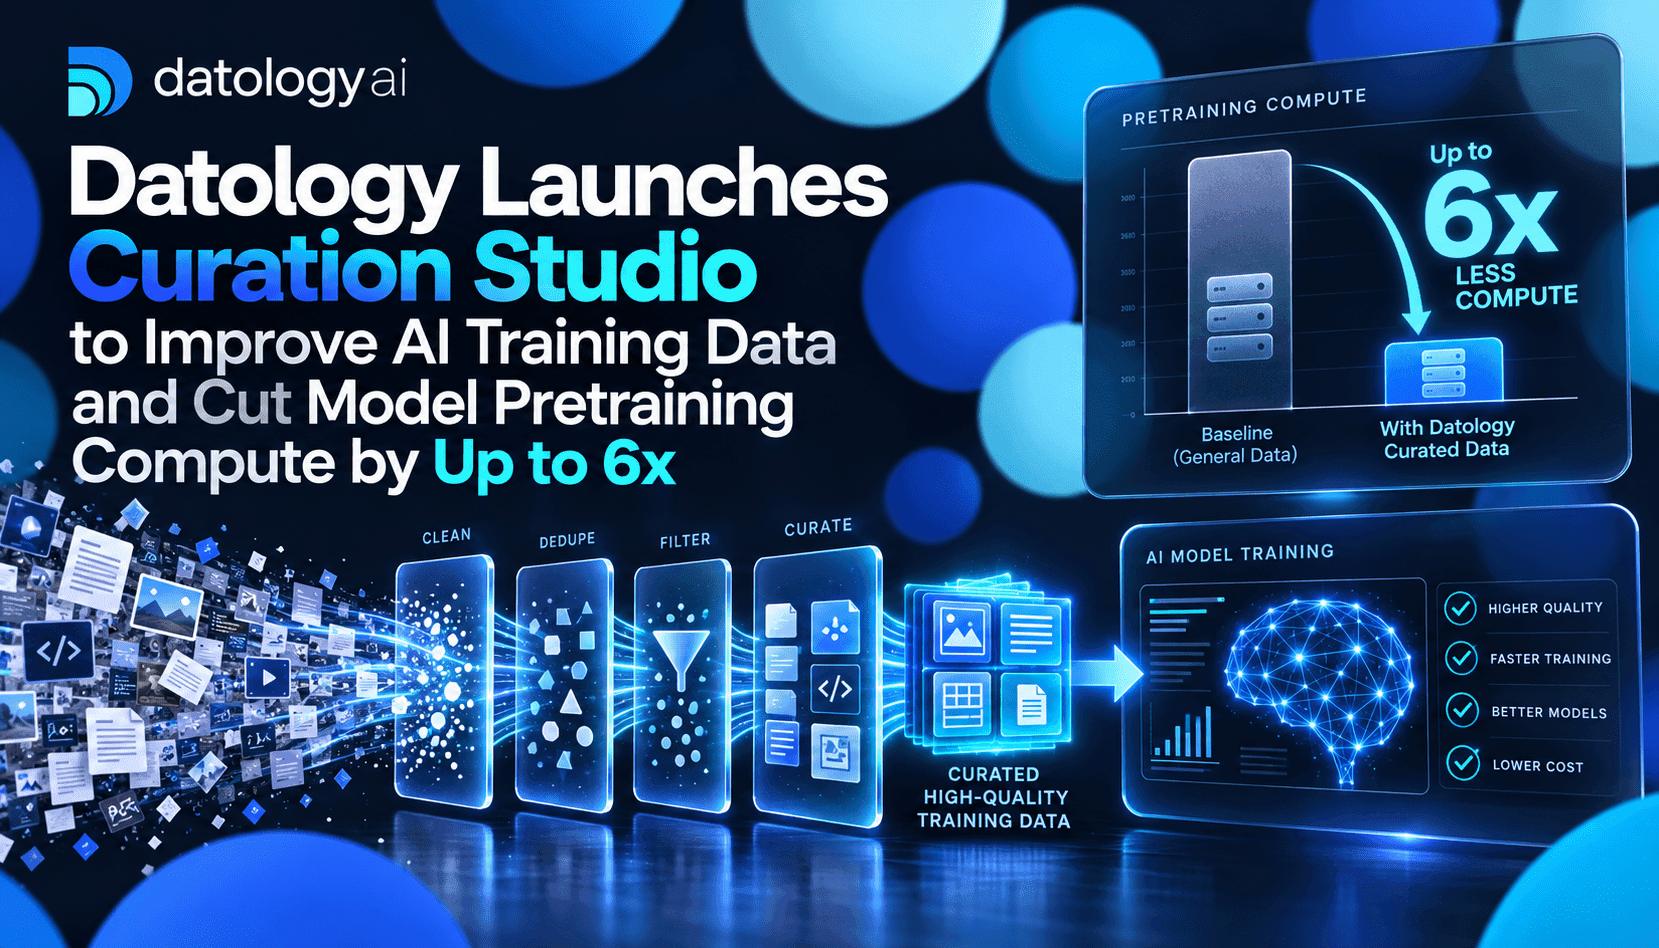
Le nouveau Curation Studio de Datology se présente comme une couche opérationnelle entre les contenus bruts et l’entraînement des modèles. Au lieu de se contenter d’ingérer toujours plus de jetons, le produit applique un processus en quatre étapes — nettoyer, calibrer, créer, composer — pour faire ressortir les signaux les plus utiles aux tâches qui vous intéressent. Cette approche est importante, car les expériences de Datology montrent qu’il est possible d’améliorer bien plus efficacement les performances réelles d’un modèle en sélectionnant soigneusement les données d’entraînement qu’en augmentant aveuglément le calcul de préentraînement. Pour les équipes d’ingénierie et produit, cela déplace les priorités et les budgets : des heures de calcul GPU brutes vers l’ingénierie du cycle de vie des données et les stratégies d’augmentation synthétique.
Le socle technique est familier dans ses principes, mais son exécution est à grande échelle : décontamination rigoureuse et nettoyage heuristique, notation et repondération de chaque document, génération de données synthétiques ancrée dans des exemples sources de grande qualité, et moteur de composition configurable qui assemble différents sous-ensembles pour chaque étape de l’entraînement. Datology affirme avoir mené des expériences où des jeux de données sélectionnés ont permis à de petits modèles, entraînés sur moins de jetons, d’égaler ou de dépasser des modèles de référence plus grands, entraînés avec beaucoup plus de calcul. Pour les professionnels, la conséquence est immédiate et concrète : il est possible de remplacer une partie des FLOP de préentraînement par des processus de curation plus intelligents et par des modèles de déploiement plus petits, moins coûteux à l’inférence.
La mise en œuvre d’une curation de pointe à l’échelle d’une entreprise exige un travail d’ingénierie considérable. Datology fait état de pipelines à l’échelle du pétaoctet, de graphes d’opérateurs personnalisés et d’une mise en cache intermédiaire étendue pour traiter des centaines de téraoctets, voire des pétaoctets, sans faire exploser les coûts ni les durées d’exécution. C’est ce qui distingue la recherche en laboratoire d’un produit que les équipes peuvent exploiter dans le VPC d’un client. Pour les entreprises qui envisagent de développer leurs propres modèles, ce modèle de produit est important : elles gardent la maîtrise de leurs données, en préservent la provenance et évitent de transmettre leur propriété intellectuelle brute à des services externes, tout en profitant de techniques de curation avancées.
L’intérêt commercial repose sur deux résultats mesurables : les performances du modèle par unité de calcul de préentraînement et le coût d’inférence par tâche. Les exemples de Datology — notamment un modèle de 12 milliards de paramètres, entraîné au préalable sur moins de jetons avec des données sélectionnées, qui surpasse un modèle de référence de 30 milliards ayant consommé beaucoup plus de calcul — illustrent comment la curation peut réduire à la fois la taille des modèles de production efficaces et leur budget d’entraînement. Pour les décideurs, la conclusion est claire : investissez tôt dans les outils et les pipelines de données, et concevez des expériences qui comparent les résultats à des références normalisées en fonction du calcul, plutôt qu’au seul nombre de jetons.