

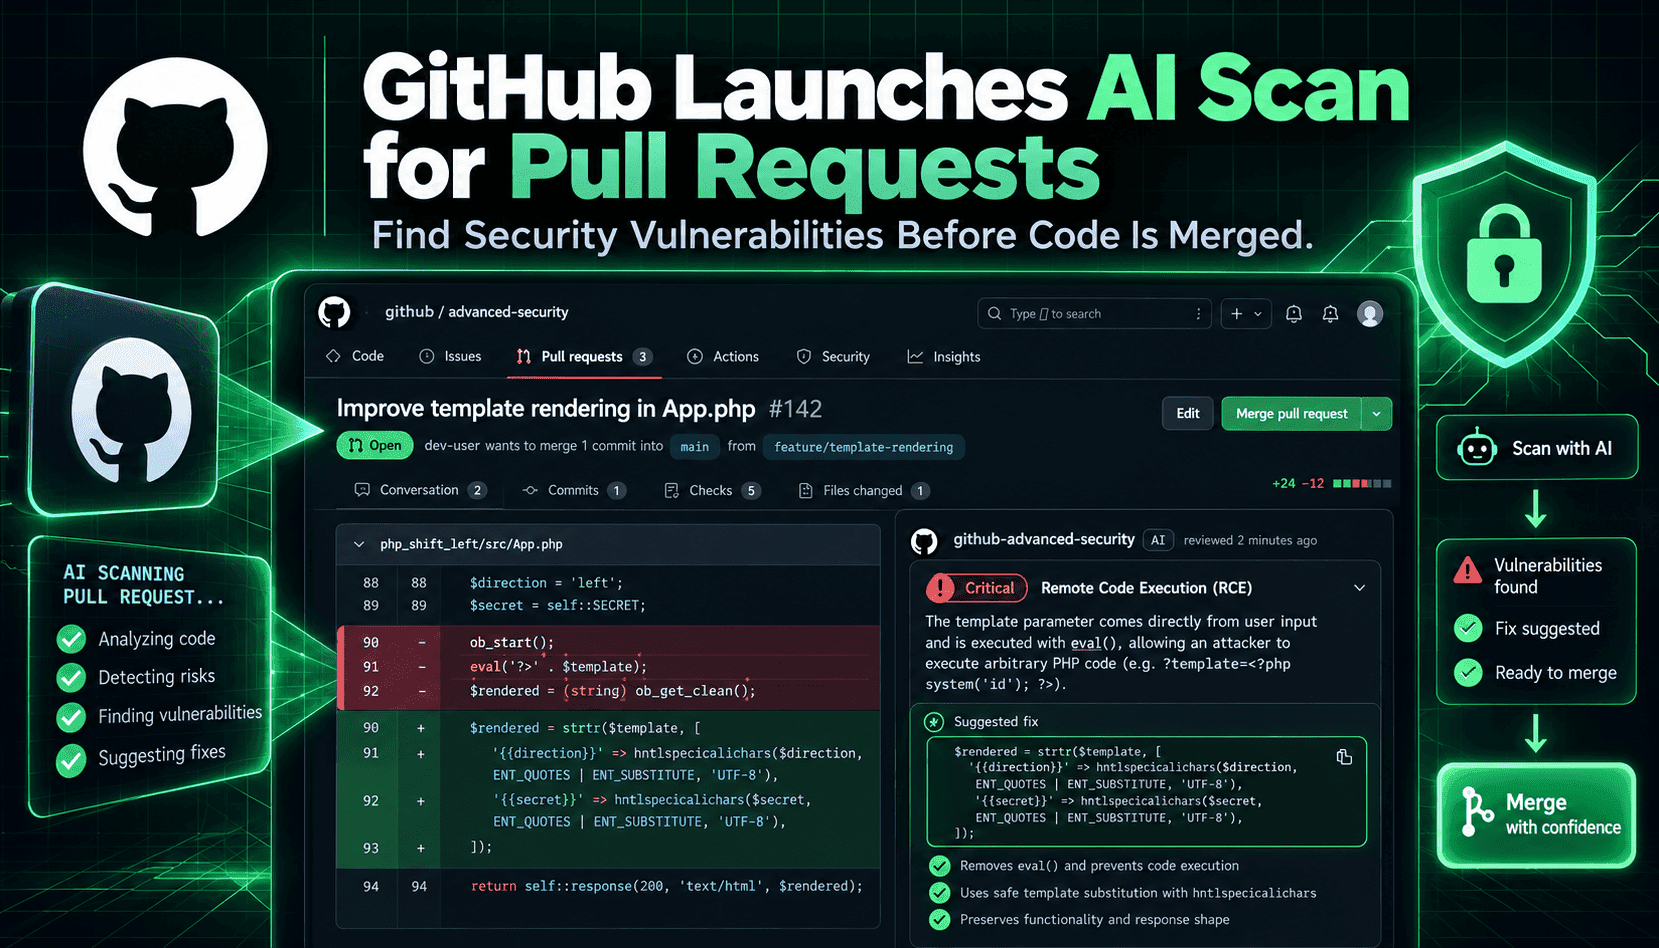
L’annonce de GitHub confirmant la disponibilité générale d’AI Scan pour les pull requests marque une évolution notable dans l’intégration de la sécurité du code aux activités quotidiennes de développement. Au lieu de remplacer la correspondance déterministe de motifs de CodeQL, AI Scan applique des modèles conçus à cet effet au contexte précis d’une pull request : les lignes modifiées, le code environnant et la structure du dépôt. Cette analyse contextuelle lui permet de signaler des problèmes et même de suggérer des corrections automatiques dans des langages et des fichiers que CodeQL ne couvre pas encore, comme PHP, Shell, Terraform HCL, les fichiers Docker, JSP et Blazor. Pour les équipes qui livrent rapidement, cette combinaison promet de détecter plus tôt les contrôles de validation manquants, les paramètres par défaut non sécurisés ou les erreurs de configuration au déploiement que les seules règles statiques peuvent laisser passer.
Sur le plan opérationnel, AI Scan s’exécute lorsque l’analyse du code et le paramètre AI Scan du dépôt sont activés. Ses résultats apparaissent aux côtés de ceux de CodeQL dans les onglets Conversation et Fichiers modifiés, clairement signalés par une icône « AI ». Point important : ses alertes sont consultatives. Elles ne font pas échouer le contrôle d’analyse du code et ne peuvent pas bloquer les fusions via les règles de protection. Ce choix montre que GitHub veut accélérer les retours sans imposer de barrières strictes, tout en laissant aux développeurs le dernier mot. Pour les organisations, cela soulève plusieurs questions de conception : comment intégrer les alertes de l’IA au triage, quand exiger une validation humaine et comment concilier les corrections automatiques générées par l’IA avec les politiques de sécurité et les processus CI/CD en place.
D’un point de vue technique, l’analyse assistée par l’IA diffère de l’analyse statique traditionnelle de trois façons concrètes. Premièrement, les modèles peuvent synthétiser le contexte de plusieurs fichiers et déduire l’intention à partir des motifs de code et des commentaires, au lieu de s’appuyer uniquement sur des règles syntaxiques. Deuxièmement, ils peuvent proposer des mesures correctives pratiques — des corrections automatiques — adaptées au code, mais fondées sur des prédictions probabilistes. Troisièmement, ils couvrent des langages et des formats de configuration qui ne disposent pas de bibliothèques de requêtes matures. Ces atouts s’accompagnent aussi de modes de défaillance particuliers : corrections inventées, cas limites ignorés ou affirmations trop générales. Il est donc essentiel de vérifier les résultats et de mettre en place des processus reproductibles avec intervention humaine avant de considérer les alertes de l’IA comme faisant autorité.
Dans la pratique, les équipes devraient considérer AI Scan comme un nouveau signal au sein d’une stratégie de sécurité à plusieurs niveaux. Servez-vous-en pour détecter plus tôt les problèmes probables, enrichir les échanges autour des PR avec des explications et accélérer le triage des alertes peu risquées et bruyantes grâce à des règles de rejet automatisées. Pour les alertes à haut risque — authentification, autorisation, cryptographie, chemins d’injection — exigez une confirmation humaine et des vérifications croisées avec CodeQL, les outils SAST et les tests de pull request. Le suivi est également important : consignez l’utilisation des crédits IA, conservez des pistes d’audit des corrections automatiques et suivez les faux positifs afin d’ajuster le comportement du modèle ou de limiter son périmètre à l’aide des paramètres du dépôt.