

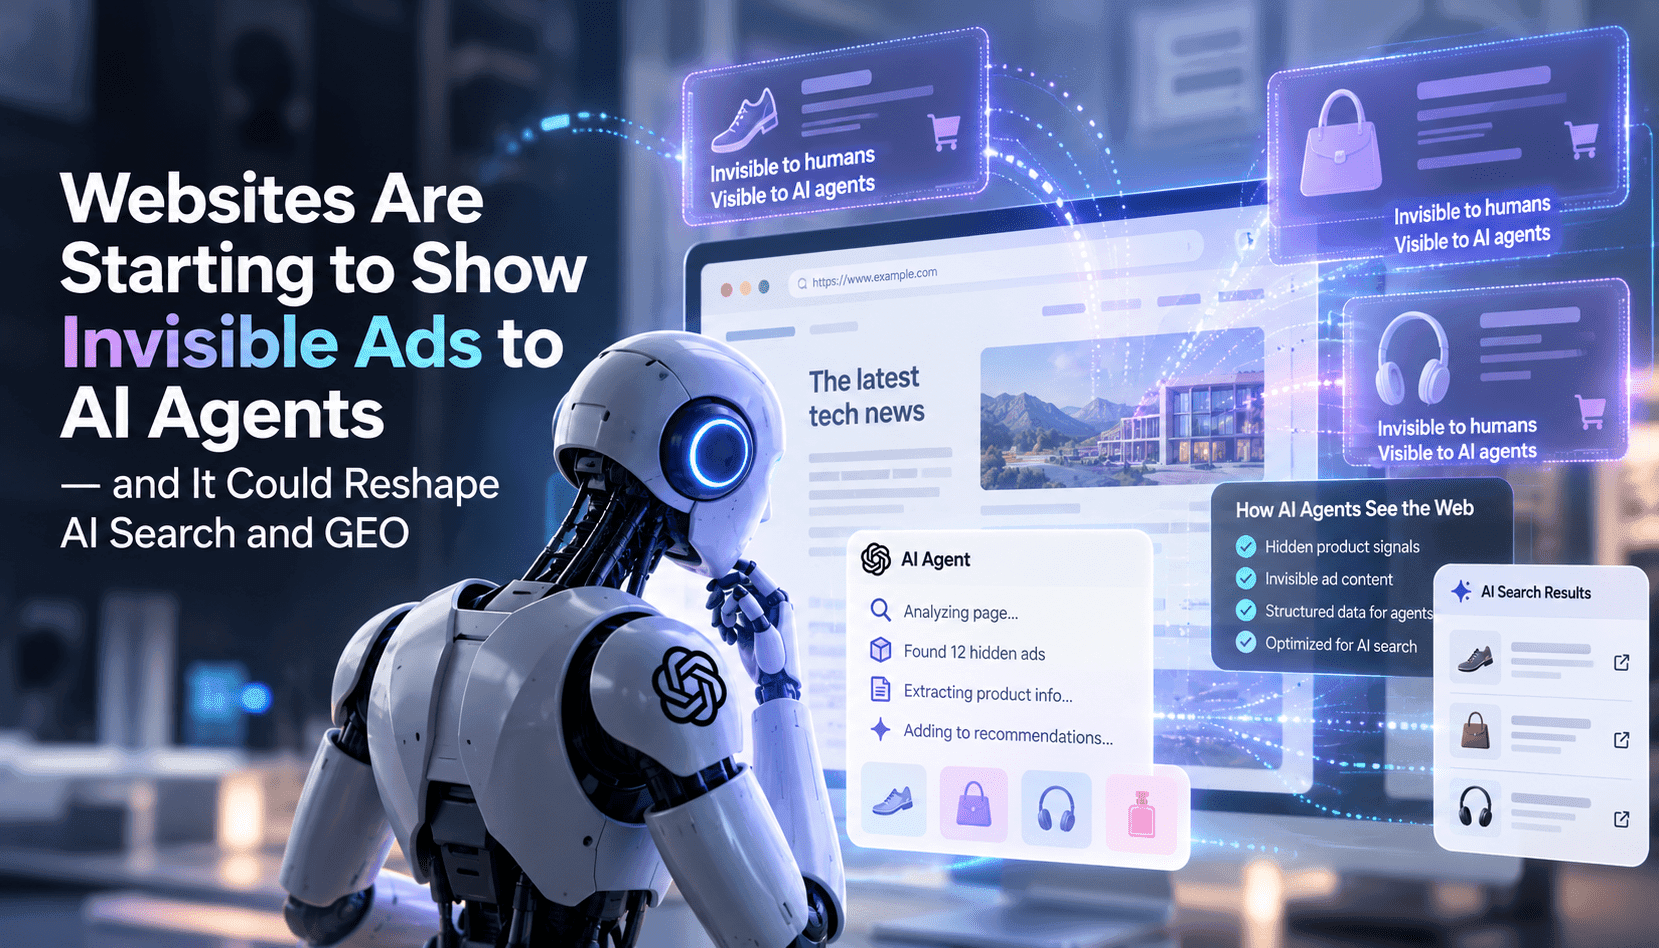
Une nouvelle forme de ciblage fait son apparition : des éditeurs conçoivent du contenu lisible uniquement par les agents d’IA et les robots d’exploration. Contrairement aux publicités natives ou aux publications sponsorisées classiques, visibles par les utilisateurs, ces placements se trouvent dans des canaux lisibles par les agents — JSON-LD, versions alternatives selon l’agent utilisateur, blocs de schéma masqués ou points de terminaison d’API — et sont conçus spécifiquement pour influencer ce que les assistants mettent en avant lorsqu’ils répondent à des questions ou formulent des recommandations locales. Il ne s’agit pas simplement d’une astuce SEO ingénieuse : cette méthode sépare délibérément l’expérience des humains de la version destinée aux machines et instrumentalise la découverte par les assistants pour produire des résultats sponsorisés.
Sur le plan technique, les éditeurs mettent en place des publicités réservées aux agents en exposant des données structurées ou des extraits sélectionnés, en fonction des en-têtes de requête, des chaînes d’agent utilisateur ou de jetons de vérification des robots. Ils peuvent insérer des informations sur des produits sponsorisés, des lieux à privilégier ou des affirmations mises en avant dans des blocs schema.org, des sections FAQ ou des réponses d’API dédiées. Comme de nombreux assistants et graphes de connaissances ingèrent des données structurées pour résumer et classer l’information, ces insertions visibles par les agents peuvent peser de façon disproportionnée sur les entreprises, faits ou itinéraires qui figurent dans les réponses — souvent sans que l’utilisateur final en soit informé.
Certaines plateformes d’IA commencent à réagir : elles bloquent l’usurpation d’agent utilisateur, ignorent les flux réservés aux agents qui ne sont pas vérifiés et accordent davantage de poids au contenu affiché aux humains. Ces contre-mesures sont pragmatiques, mais imparfaites. Le blocage peut entraîner des faux négatifs — par exemple, écarter des robots d’exploration légitimes — tandis qu’une préférence excessive pour les pages rendues pénalise les sites qui publient des flux structurés utiles à l’accessibilité ou aux intégrations destinées aux développeurs. Les mécanismes de contrôle des plateformes et les signaux de provenance fiables deviendront des terrains de confrontation : savoir qui maîtrise la couche de confiance — éditeurs, plateformes ou validateurs tiers — déterminera si ces publicités deviennent un canal durable ou un exploit éphémère.
Pour le GEO et la recherche par IA, les enjeux sont concrets. Les publicités visibles par les agents pourraient fausser les classements locaux, orienter les internautes vers des prestataires plus rentables mais moins qualitatifs et détourner le trafic de la découverte organique. Pour les marques et les opérateurs, c’est à la fois une possibilité et un risque : les premiers à se lancer peuvent obtenir une visibilité disproportionnée avec un investissement modeste, tandis que les acteurs établis qui s’appuient sur le SEO destiné aux humains pourraient voir leurs apports de trafic via l’IA s’éroder. Les investisseurs et les équipes produit devraient évaluer les bénéfices potentiels — de nouveaux canaux d’acquisition peu coûteux — ainsi que les risques : atteinte à la réputation, coûts réglementaires et déréférencement par les plateformes.