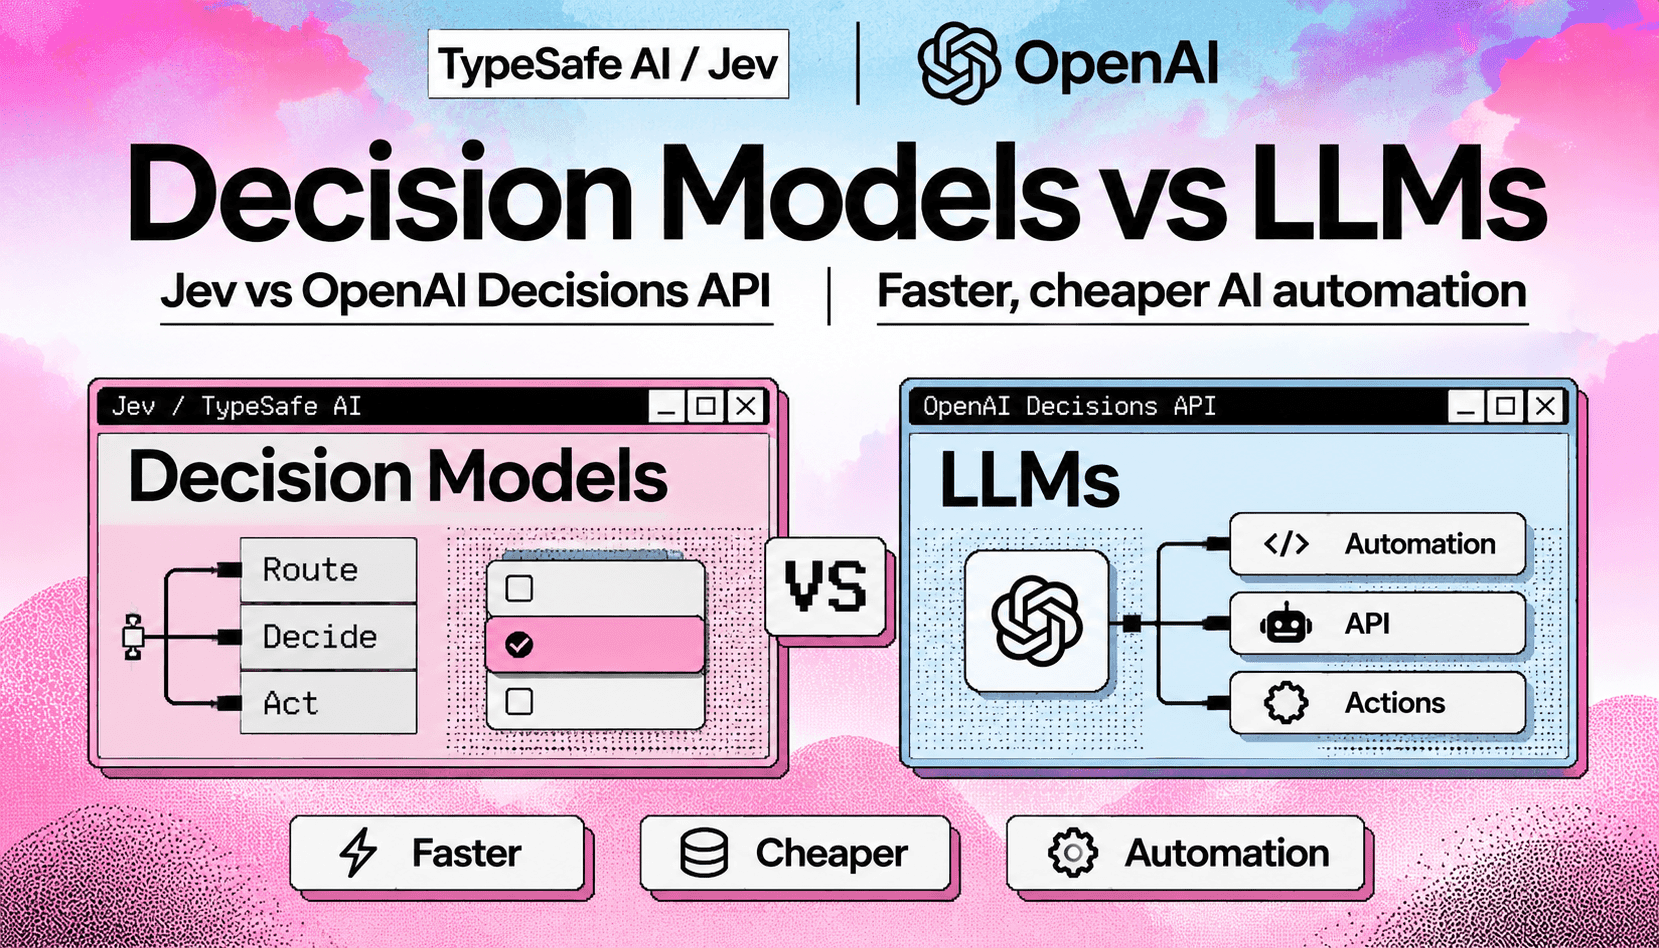
自動化パイプラインを構築する企業が直面しているのは、シンプルながら根深い課題です。生成AIのLLMは柔軟である一方、あらゆるルーティング、スコアリング、二択の判断に使うと、コストも時間もかかります。JevやOpenAI Decisions APIに代表される新しい小型の意思決定モデルは、まさにこうした用途を狙ったものです。確定的な分類を目的に学習され、確信度を適切に調整した出力を返し、汎用の推論LLMより低レイテンシ・低計算コストで動作するよう設計されています。この変化はLLMを置き換えることではなく、タスクに応じて適切なモデルを選び、予測可能なコストと性能を実現することを意味します。
意思決定モデルが力を発揮するのは、入力が比較的少数の結果に対応する、構造化された分類、ルーティング、ポリシー適用です。具体的には、ユーザーの意図をすばやく分類する、不正かどうかを振り分ける、簡単な適格性を判定する、後続のエージェントに渡す特徴量ベースのスコアを算出するといった用途があります。エッジやルールエンジン内でマイクロサービスとしてデプロイし、大規模な推論モデルを呼び出す前のフィルターとしても使えます。出力が簡潔で予測しやすいため、すべてを生成モデルに任せる場合よりも、厳格なレイテンシSLAを実現しやすく、監視も簡素化できます。
本記事では、代表的な意思決定モデル(Jevなど)やOpenAI Decisions APIと、大規模な生成LLMを、レイテンシ、判断あたりのコスト、確信度スコアリング、説明可能性といった測定可能な観点から比較します。さらに、意思決定レイヤーとLLMを組み合わせ、高コストな呼び出しを減らし、信頼性を高め、必要な場面にだけ推論能力を使う実践的なアーキテクチャを紹介します。最後に、ルーティングモデルやスコアリングモデルを選ぶ場面、推論経路を残すべき場面、誤ルーティングを検知・軽減するためのハイブリッド構成の計測方法について、運用面の指針をまとめます。