TencentのHy4 flashは、純粋な性能の頂点を目指すのではなく、価格性能比で競争力を発揮するよう設計されています。総パラメータ数は224Bですが、推論時にアクティブになるのは12Bのみ。大規模なオフライン容量を維持しつつ、実行時のコストを抑える設計です。Tencentによると、マルチモーダル入力と100万トークンのコンテキストウィンドウに対応し、複数の推論最適化を組み合わせることで、デコード速度は150 tokens/secを超えます。モデル選定を進めるチームにとって、Hy4 flashは、最先端モデルの一部と比べてタスクあたりのコストを大幅に抑えながら、広いコンテキストと画像理解を実現する現実的な選択肢となりそうです。
Hy4 flashは、Hyシリーズで導入されてきた複数のアーキテクチャ上の工夫を採用しています。長期的な知識を効率よく格納するEngramのパラメータ化、必要な箇所に計算資源を集中させるLatentMoEの条件付き容量、そしてコンテキストを効率よく拡張するハイブリッドアテンションです。TencentはKVキャッシュの大幅な削減も報告しており、これは推論時のメモリ使用量とキャッシュI/Oコストを下げるための意図的な設計上のトレードオフです。また、学習後の強化学習により、一般的なタスクで出力トークンの平均長を半減できたとしています。これは出力トークンの課金を直接抑え、多くの業務ワークフローで応答時間の短縮にもつながります。
企業での導入において、特に実務上の意義が大きいのは、100万トークンのコンテキストウィンドウと150 tokens/sec超のデコード速度です。Tencentは、メガカーネル最適化、4-bit量子化、DFlyの実行方式、コンパクトなKVキャッシュを組み合わせることで、これらを実現したと説明しています。長いコンテキストと高速なデコードを活用すれば、これまで高コストな分割処理や状態の再構成、エージェントによるオーケストレーションが必要だった文書全体、スライド資料、複数ファイルにまたがるスレッドを、一度の処理で扱える可能性があります。実環境でもコンテキスト処理の堅牢性が確保されるなら、顧客向けワークフローの開発複雑性やレイテンシを下げられるでしょう。
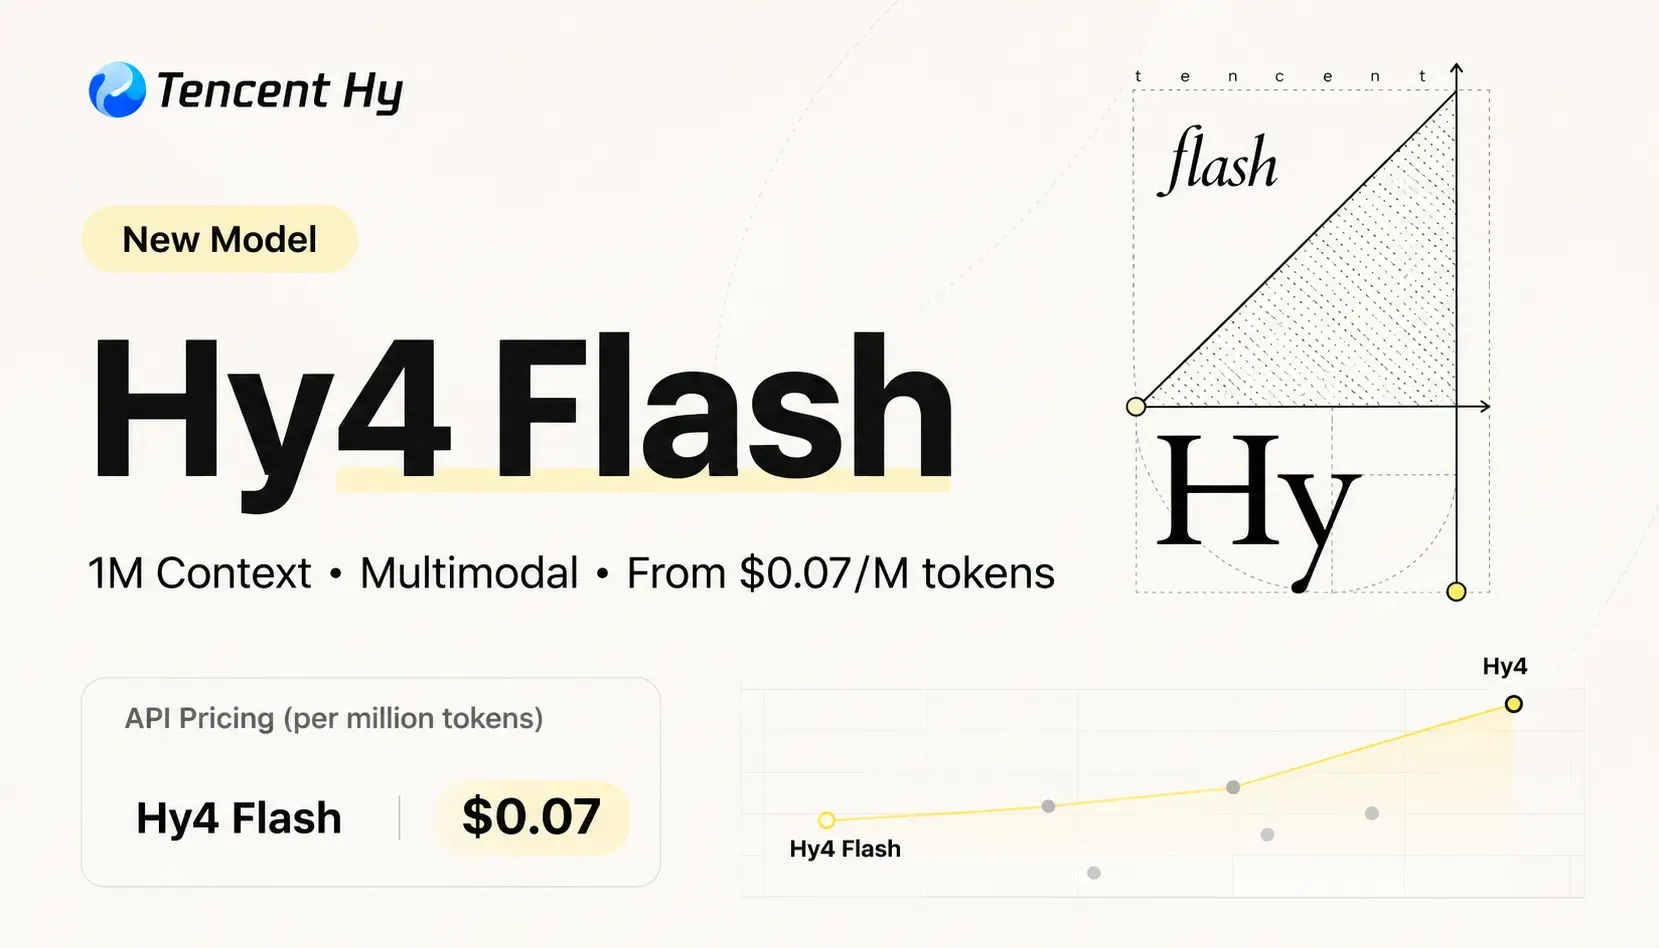
Tencentが公表しているAPI価格は、入力100万トークンあたり約$0.070、出力100万トークンあたり約$0.281で、キャッシュ済み入力にはさらに低い料金が設定されています。同社は、社内のWorkIndexベンチマークで、Hy4 flashのタスクあたりコストが上位のHy4モデルや他の最先端モデルより大幅に低いとしています。この説明は、処理量や請求額の予測しやすさ、文書ワークフローを重視する組織にとって有益です。Hy4 flashは、運用コストを大きく削減できる可能性があります。ただし、Tencent社内のベンチマークやブラインドユーザー評価は参考情報として捉え、独立した検証を経た結論とは見なさないことが重要です。コストと品質の比較は、実際の業務を代表する第三者タスクで検証する必要があります。