

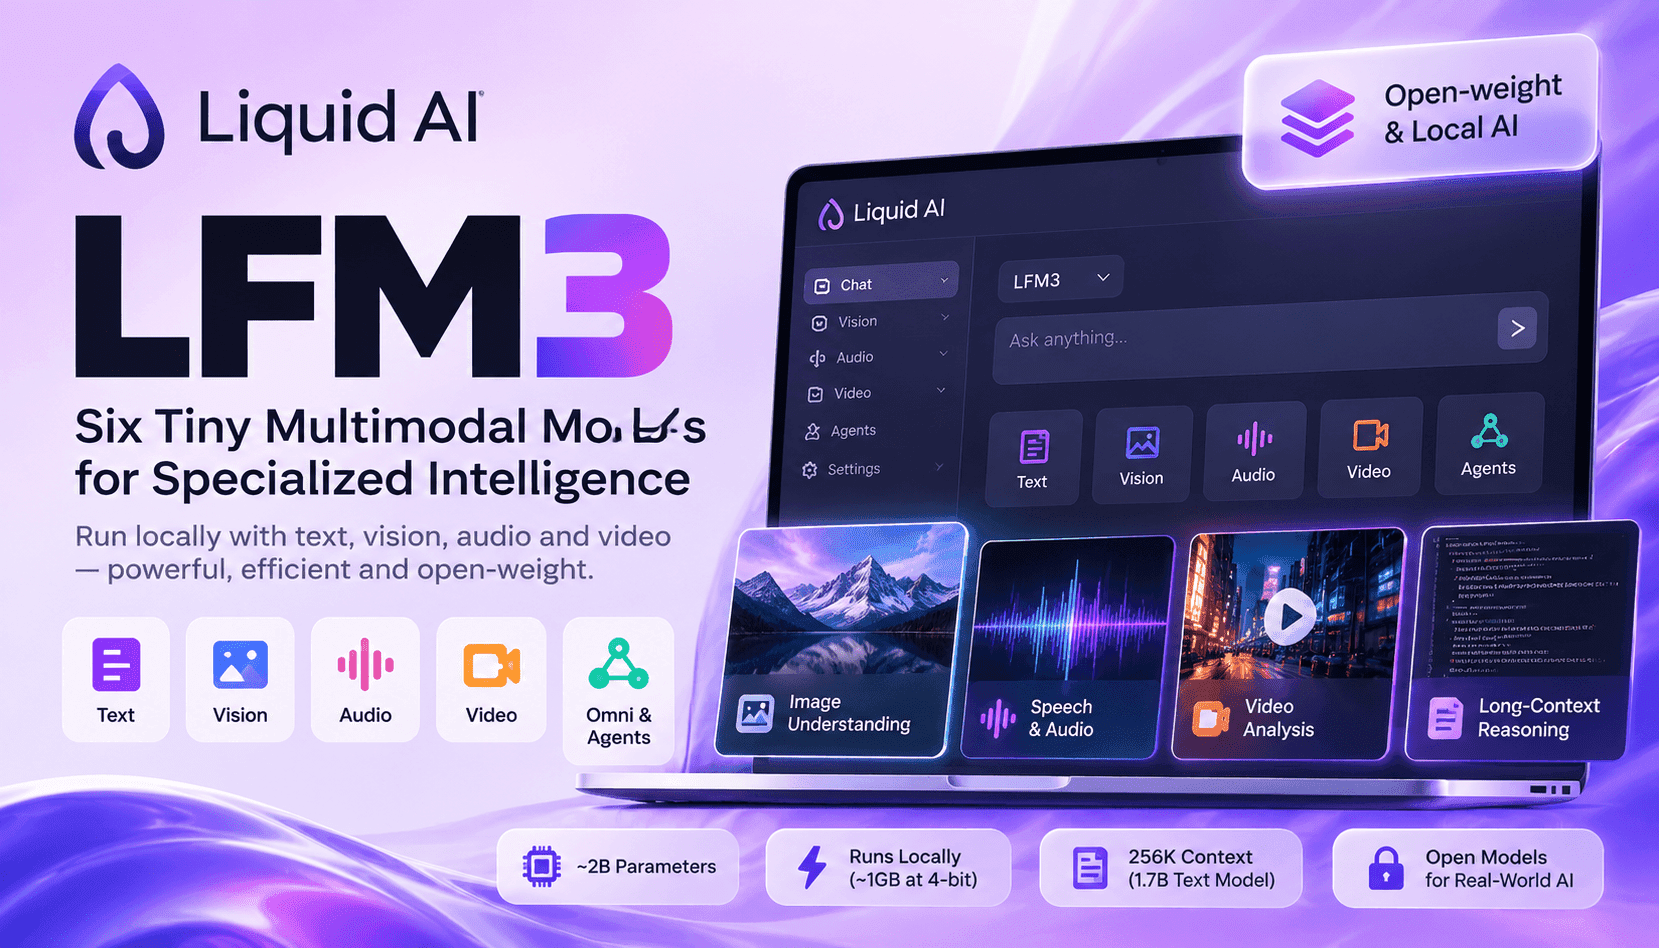
Liquid AIによるLFM3の発表は、実用性を重視した方向転換を示しています。より大規模な汎用モデルを追い求めるのではなく、単一の17億パラメータのバックボーンを基に、用途別の6モデルを開発しました。その結果、テキスト、ビジョン、オーディオ、オムニ、意思決定に対応するマルチモーダル機能を緊密に最適化し、オンデバイスでの処理性能、長文コンテキストへの対応、ローカルでのファインチューニングを優先しています。小さなRAM/フラッシュ容量、単一GPUでの学習、低遅延が求められる対話型ワークロードなど、実際の導入における制約を見据えた設計である点は、開発者にとって重要です。
技術面では、LFM3はゲート付き短畳み込み、スライディングウィンドウ・アテンション、選択的なグローバル・アテンションを組み合わせた三者ハイブリッド構造を採用しています。これにより、パラメーターあたりの能力を高めながら、長文コンテキストの処理コストを抑えています。主力のテキストモデルLFM3-1.7Bは、256Kトークンのコンテキストウィンドウに対応し、4-bit形式で量子化すれば約1GBに収まります。超長文コンテキストと小さな量子化後のサイズを両立することで、常時稼働するバックグラウンドエージェント、大規模文書の推論、そしてデータをクラウドAPIに送れない、または送信コストが高すぎるプライベート環境でのツール活用が可能になります。
Liquid AIはアーキテクチャだけでなく、新しいビジョン/オーディオエンコーダーも提供しており、計算負荷を抑えながら動画や音声の処理能力を高めています。ビジョンモデルは、動画処理時に時間的に隣接するフレームをペアにしたスライスを使い、シーケンス長を半減。オーディオモデルは、ストリーミング音声、多言語ASR/TTS、ツール呼び出しのワークフローに対応します。これらを組み合わせれば、低い初回トークン生成時間で聞く・見る・行動するハイブリッドエージェントを構築できます。これは、車載対話アシスタント、組み込みロボティクス、マルチモーダルデータを扱う企業向けプライベートエージェントにとって重要な特性です。
LFM3を評価するチームにとって、実務上の焦点は、クラウドAPIをどこで、どのように置き換えるかです。LFM3は、最高水準の精度よりもプライバシー、処理性能、予測しやすいレイテンシーを重視する用途に適しています。たとえば、機密データを扱う企業向けアシスタント、規制業界のオンプレミス自動化、AI PCや接続性の限られたエッジ機器上の組み込み認識基盤などです。本レビューでは、導入パターン、単一GPUでのファインチューニング、クラウドモデルとの性能上のトレードオフ、移行時に管理すべき運用リスクを取り上げます。