

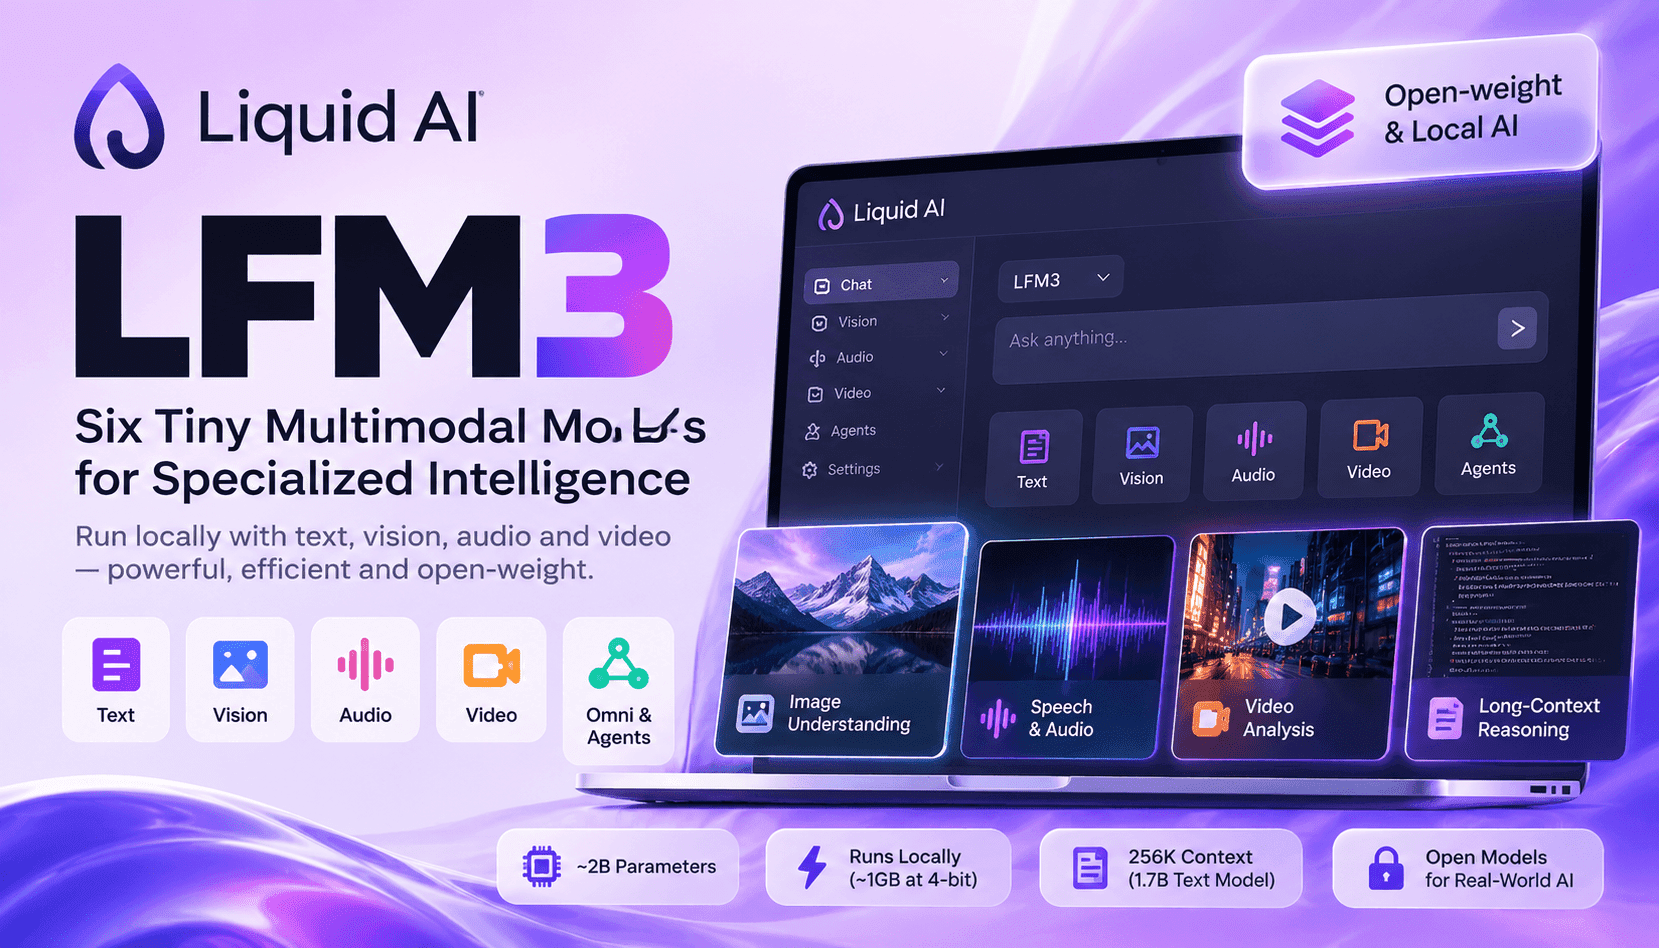
O lançamento do LFM3 da Liquid AI representa uma mudança pragmática de rumo: em vez de apostar em modelos generalistas cada vez maiores, a equipa criou uma família de seis modelos especializados, todos derivados de uma única arquitetura-base de 1,7 mil milhões de parâmetros. O resultado é uma multimodalidade cuidadosamente otimizada — com modelos de texto, visão, áudio, omni e tomada de decisão — que privilegia o desempenho no dispositivo, o processamento de contextos longos e o ajuste fino local. Isto é importante para quem trabalha na área, porque a arquitetura foi pensada para as limitações reais da implementação: orçamentos reduzidos de RAM e armazenamento flash, treino numa única GPU e cargas de trabalho interativas sensíveis à latência.
Do ponto de vista técnico, o LFM3 assenta numa arquitetura tri-híbrida que combina convoluções curtas com gating, atenção em janela deslizante e atenção global seletiva. Esta conceção oferece mais capacidade por parâmetro e mantém controláveis os custos associados a contextos longos. O modelo de texto de referência, o LFM3-1.7B, suporta uma janela de contexto de 256K tokens e pode ser quantizado para cerca de 1 GB em formatos de 4 bits. A combinação de contexto ultralongo e uma pegada quantizada reduzida permite executar agentes continuamente em segundo plano, raciocinar sobre documentos extensos e usar ferramentas em ambientes privados, onde não é aceitável enviar dados para APIs na cloud ou onde isso tem um custo proibitivo.
Para além da arquitetura em si, a Liquid AI disponibiliza novos codificadores de visão e áudio que reduzem o custo computacional e melhoram o processamento de vídeo e fala. A visão usa pares de segmentos temporais de fotogramas para reduzir para metade o comprimento da sequência durante o processamento de vídeo; o modelo de áudio suporta fala em streaming, reconhecimento e síntese de fala multilingues (ASR/TTS) e fluxos de trabalho com chamada de ferramentas. Em conjunto, estas capacidades permitem criar agentes híbridos que ouvem, observam e atuam com um tempo reduzido até ao primeiro token — uma característica essencial para assistentes conversacionais em automóveis, robótica integrada e agentes empresariais privados que trabalham com dados multimodais.
Para as equipas que estão a avaliar o LFM3, a questão prática é saber onde e como substituir APIs na cloud. O LFM3 foi concebido para cenários em que a privacidade, o débito e a latência previsível são mais importantes do que a máxima precisão possível: assistentes empresariais que processam dados sensíveis, automatização local para setores regulamentados, sistemas de perceção integrados em PCs com IA e dispositivos edge com conectividade limitada. Esta análise aborda padrões de implementação, ajuste fino numa única GPU, compromissos de desempenho face aos modelos na cloud e os riscos operacionais a gerir durante a migração.