

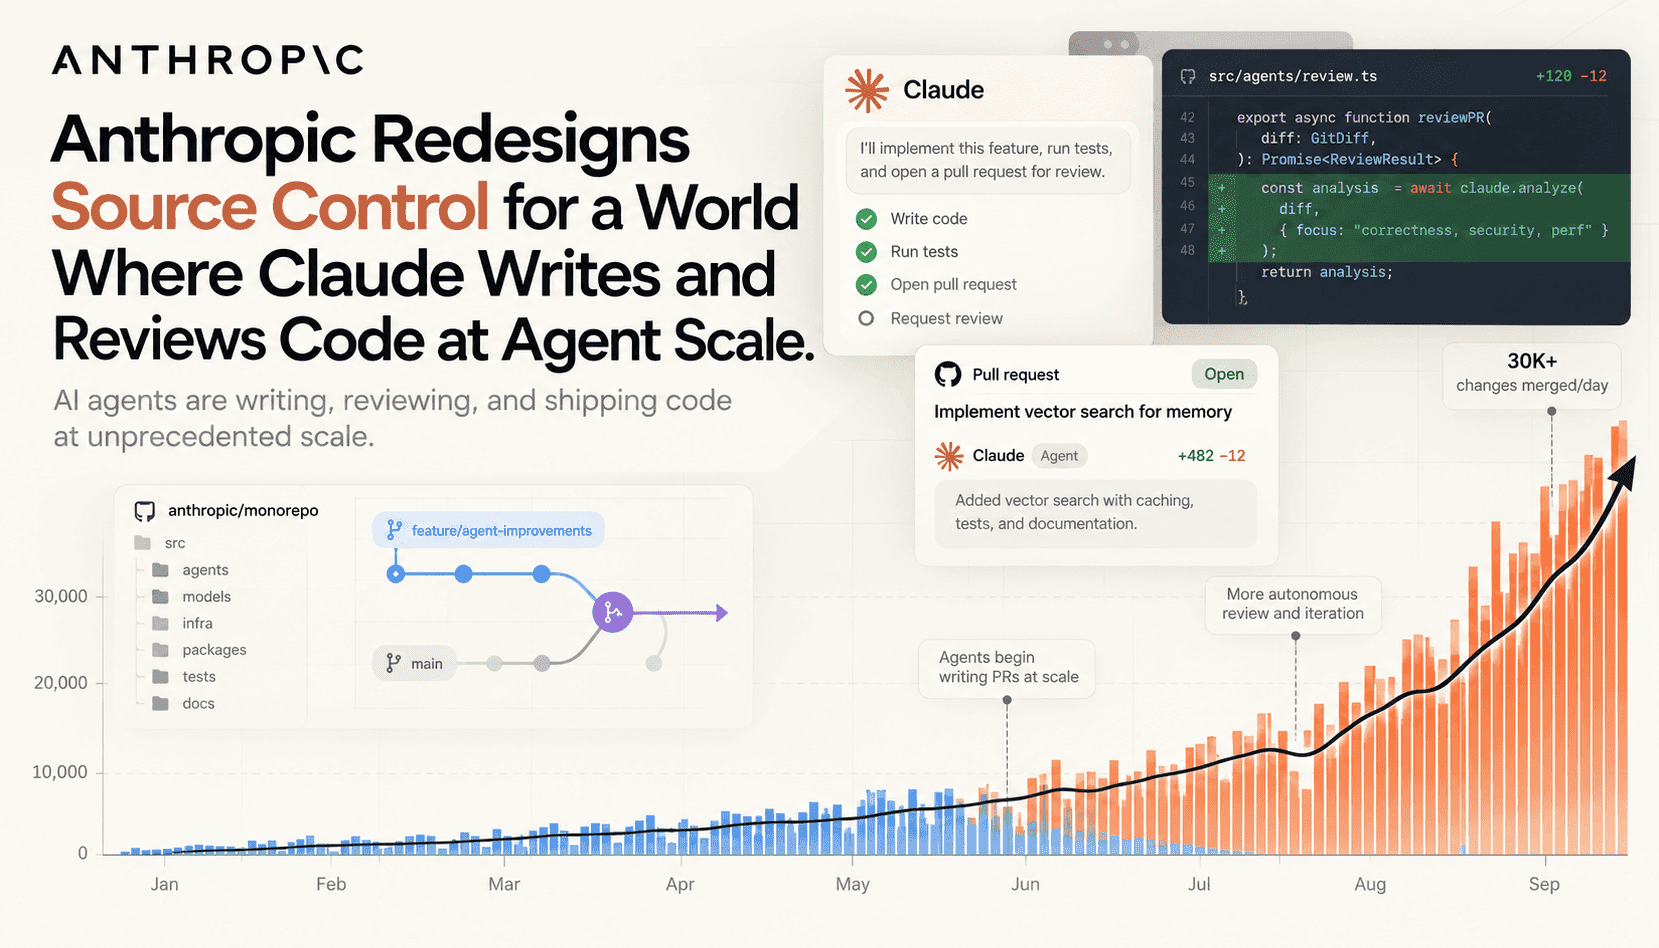
Anthropic 从 git 迁移到自研系统 Scion,是对运营拐点的一次结构性回应:以 Claude 为代表的自主智能体开始每天生成并合并数万项更改,打破了为人类工作流设计的工具所依赖的种种假设。Anthropic 发现,当大多数客户端都是只需访问代码库部分内容的在线智能体时,去中心化设计的前提(完整克隆、基于 packfile 的交换、本地 refs)反而成了负担。Scion 将问题重新定义为高吞吐量、服务器驱动的元数据处理与稀疏文件交付,这一转变也影响着团队设计流水线、监控状态和审计更改的方式。
Scion 的核心做法,是用服务器端变更集及其生成的索引,取代 git 对完整提交图的操作。Scion 不再向每个客户端分发不可变的 packfile,而是提供内容寻址的 blob、定向树请求,以及用于 blame、祖先关系和差异比较的服务器 API。工作副本不再是必需的;CI 和研究任务可以直接向服务器查询元数据,或只物化所需路径。这一变化大幅降低网络、CPU 和存储开销,也让创建提交变得廉价且无需加锁——当每日合并量增长一个数量级时,这一点至关重要。
在运营层面,这一转变要求重新审视整套工具链:CI、代码审查、IAM 和可观测性都必须以服务器中心型版本控制系统为前提。拉取和构建将变为面向分层服务器、由缓存驱动的读取模式,而不是通过镜像进行大规模克隆。派生数据(blame 索引、路径历史、跳跃列表)必须增量计算和存储;选择预计算还是按需计算,会直接影响延迟、存储和运营成本。团队需要重新设计任务启动流程、本地开发体验和容量规划,优先考虑对象缓存、可续传获取和区域隔离。
对工程领导者而言,现实问题迫在眉睫:如何大规模信任智能体生成的更改?如何监控并执行策略?又如何避免形成单一的协调瓶颈?Anthropic 的经验表明,这些问题可以通过服务器端策略执行、程序化审查界面、对抗性验证流水线以及谨慎使用 refs 来解决。技术上的权衡——本地自主性降低、集中式计算增加、派生数据维护工作增多——换来的是速度、可复现性和大规模运行智能体的能力显著提升。