

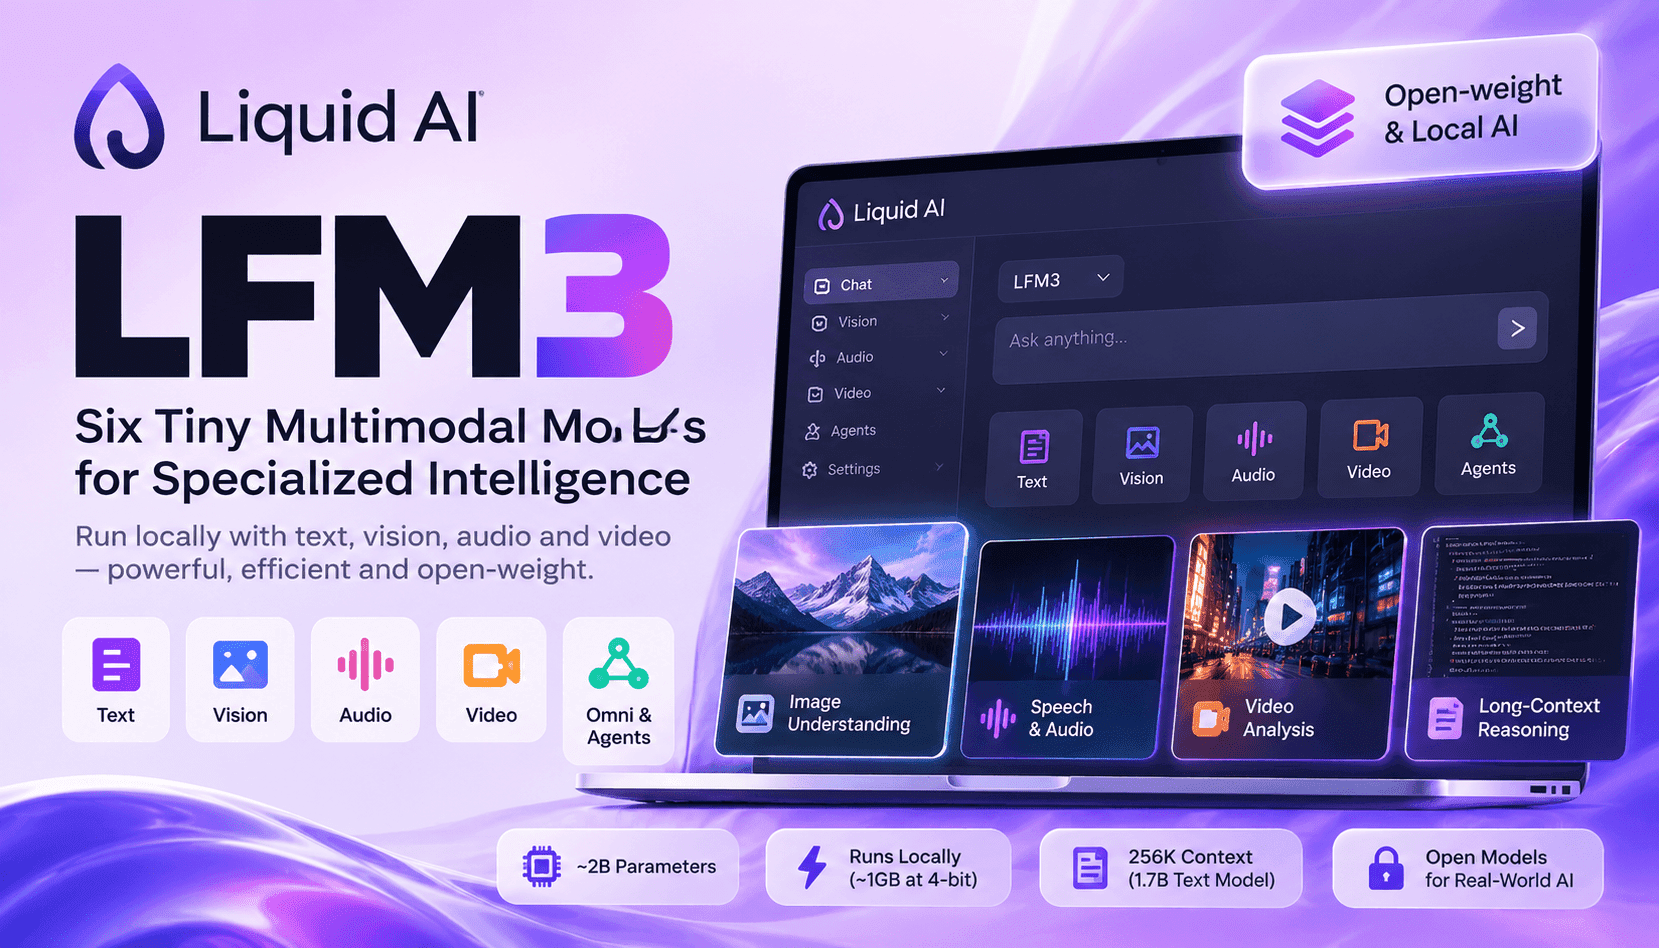
Liquid AI 发布 LFM3,体现了一种务实的转向:团队没有一味追求更大的通用模型,而是基于同一个 1.7B 骨干网络,构建了由六款专业模型组成的系列。由此带来一套经过精细优化的多模态模型——涵盖文本、视觉、音频、全模态和决策,重点提升端侧吞吐量、长上下文处理能力和本地微调能力。对于从业者而言,这一点至关重要,因为该系列有意针对真实部署中的限制进行设计:有限的 RAM 和闪存预算、单 GPU 训练,以及对延迟敏感的交互式工作负载。
在技术层面,LFM3 采用三重混合架构,将门控短卷积、滑动窗口注意力和选择性全局注意力结合起来。这种设计提升了单位参数的能力,同时让长上下文处理成本保持在可控范围内。旗舰文本模型 LFM3-1.7B 支持 256K token 上下文窗口,采用 4 位格式量化后,体积约为 1GB。超长上下文与极小量化体积相结合,使其能够支持持续运行的后台智能体、大型文档推理,以及在私有环境中使用各类工具;在这些环境下,数据无法发送至云端 API,或这样做的成本过高。
除了底层架构,Liquid AI 还推出了新的视觉和音频编码器,在提升视频与语音处理能力的同时降低计算开销。视觉模型通过成对帧的时间切片,将视频处理所需的序列长度减半;音频模型则支持流式语音、多语言 ASR/TTS,以及工具调用工作流。这些能力结合后,可打造能够听、看、行动的混合型智能体,并实现较低的首 token 延迟——这对于车载对话助手、嵌入式机器人,以及处理多模态数据的私有企业智能体来说至关重要。
对于正在评估 LFM3 的团队来说,实际要考虑的是:在哪些场景、以何种方式替代云端 API。LFM3 适用于隐私、吞吐量和稳定延迟比极致准确率更重要的场景,例如处理敏感数据的企业助手、受监管行业的本地自动化、AI PC 和边缘设备上的嵌入式感知系统,以及网络连接有限的环境。本评测将介绍部署模式、单 GPU 微调方法、与云端模型相比的性能取舍,以及迁移过程中需要管理的运营风险。