

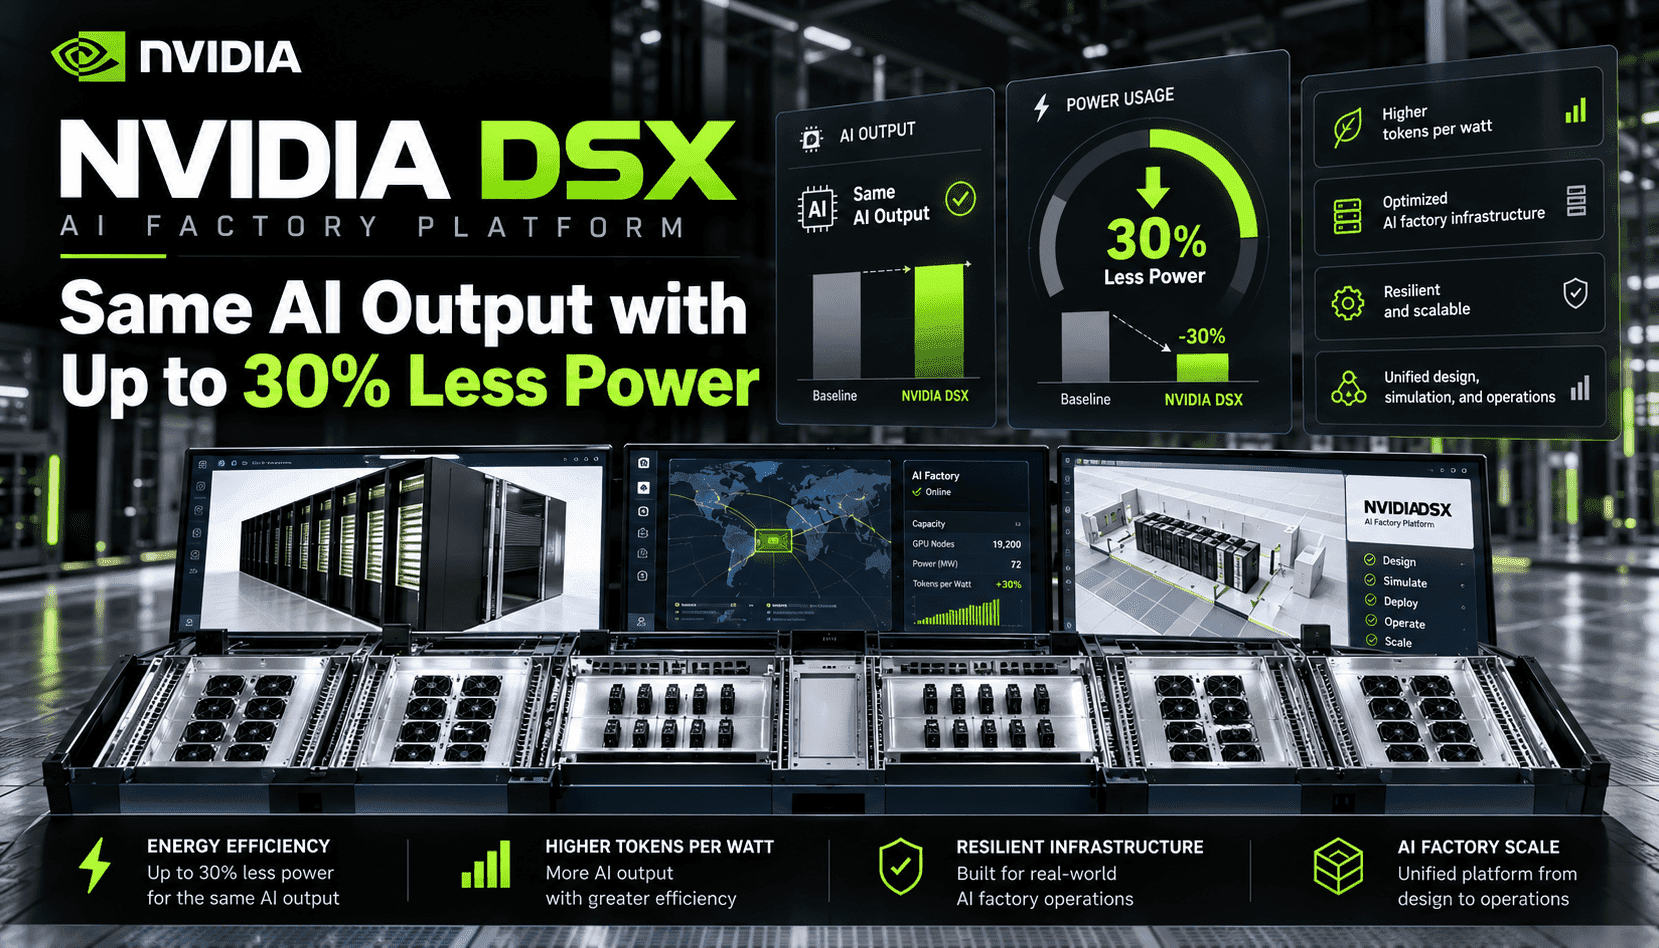
NVIDIA 的 DSX AI 工厂平台重新定义了数据中心效率:它不再只是追求机架层面的渐进式提升,而是对计算、电力和冷却进行系统级协同设计。其核心主张是,DSX MaxLPS 可在功耗最多降低 30% 的情况下生成相同数量的 Token。这一成果依托于跨机架动态分配电力,以及经过验证的参考架构;后者将液冷计算设备与室外干式冷却器结合,以减少蒸发损耗。这种组合旨在应对欧洲及其他电网和水资源受限地区大规模部署 AI 面临的两大难题:一个站点能接入多少兆瓦电力,以及当地水资源能否支撑传统的蒸发式冷却。
DSX 并非只有宣传概念,也着眼于实际应用。开展概念验证和早期试验的合作伙伴报告称,在固定功率范围内,实际可用容量有所提升。Lambda 在采用 MaxLPS 的 HGX B200 集群测试中发现,在预算固定的情况下,集群 Token 吞吐量约提升 24%,可用 GPU 容量增加 19%;Nscale 在冰岛的评估则报告称,在相同的 264 kW 配电额度内,推理吞吐量提升 49%,可管理的 GPU 容量增加 37%。这些运营层面的信号表明,动态分配电力并结合系统级冷却方案,无需全面更换芯片,也能释放更多余量。
对运营商和规划人员而言,关键指标正在转变:不再只看 GPU 浮点运算能力或单卡基准测试,而要关注每兆瓦能处理多少 Token。一旦电网接入能力和当地水资源限制了可部署的机架数量,唯一的办法就是从每个已获批的兆瓦中挖掘出更多可用的 AI 推理与训练能力。DSX 的软件管理电力配置、经过验证的基础设施堆栈和数字孪生仿真工具,共同开辟了新的优化空间:协调工作负载调度、机架功率范围与设施系统,在当地约束条件下最大化 Token 产出。