腾讯 Hy4 flash的定位是以性价比挑战市场,而非单纯追求能力领先。该模型总参数量为 2240 亿,推理时仅激活 120 亿参数,旨在降低运行成本,同时保留庞大的离线容量。腾讯强调其多模态输入能力和 1,000,000-token 上下文窗口,并称通过一系列推理优化,解码速度可超过每秒 150 tokens。对于正在评估模型选型的团队而言,Hy4 flash 有望提供务实的折中方案:以远低于部分前沿模型的单任务成本,实现强大的上下文记忆能力和视觉理解能力。
Hy4 flash 的底层架构采用了 Hy 系列中的多项技术:通过 Engram 参数化紧凑存储长期知识,借助 LatentMoE 条件容量将计算资源集中于需要处理的部分,并利用混合注意力高效扩展上下文。腾讯还表示,该模型大幅缩小了 KV 缓存占用——这是有意为之的工程取舍,能够降低推理时的内存和缓存 I/O 成本。据称,后训练强化学习使典型任务的端到端输出 token 平均长度缩短了一半,直接减少输出 token 费用,也能加快许多办公流程的周转。
宣称可支持 100 万 tokens 上下文窗口、解码速度超过每秒 150 tokens,这两项特性对企业部署最具实际意义。腾讯将这些表现归功于多种技术的组合:Megakernel 优化、4-bit 量化、DFly 执行策略和精简的 KV 缓存。在实践中,长上下文与快速解码相结合,可以一次性处理整份文档、幻灯片或多文件讨论串,无需进行成本高昂的分块、状态拼接或智能体编排。如果模型对上下文的处理在真实场景中足够稳健,这些优势就能降低客户实际工作流中的工程复杂度和延迟。
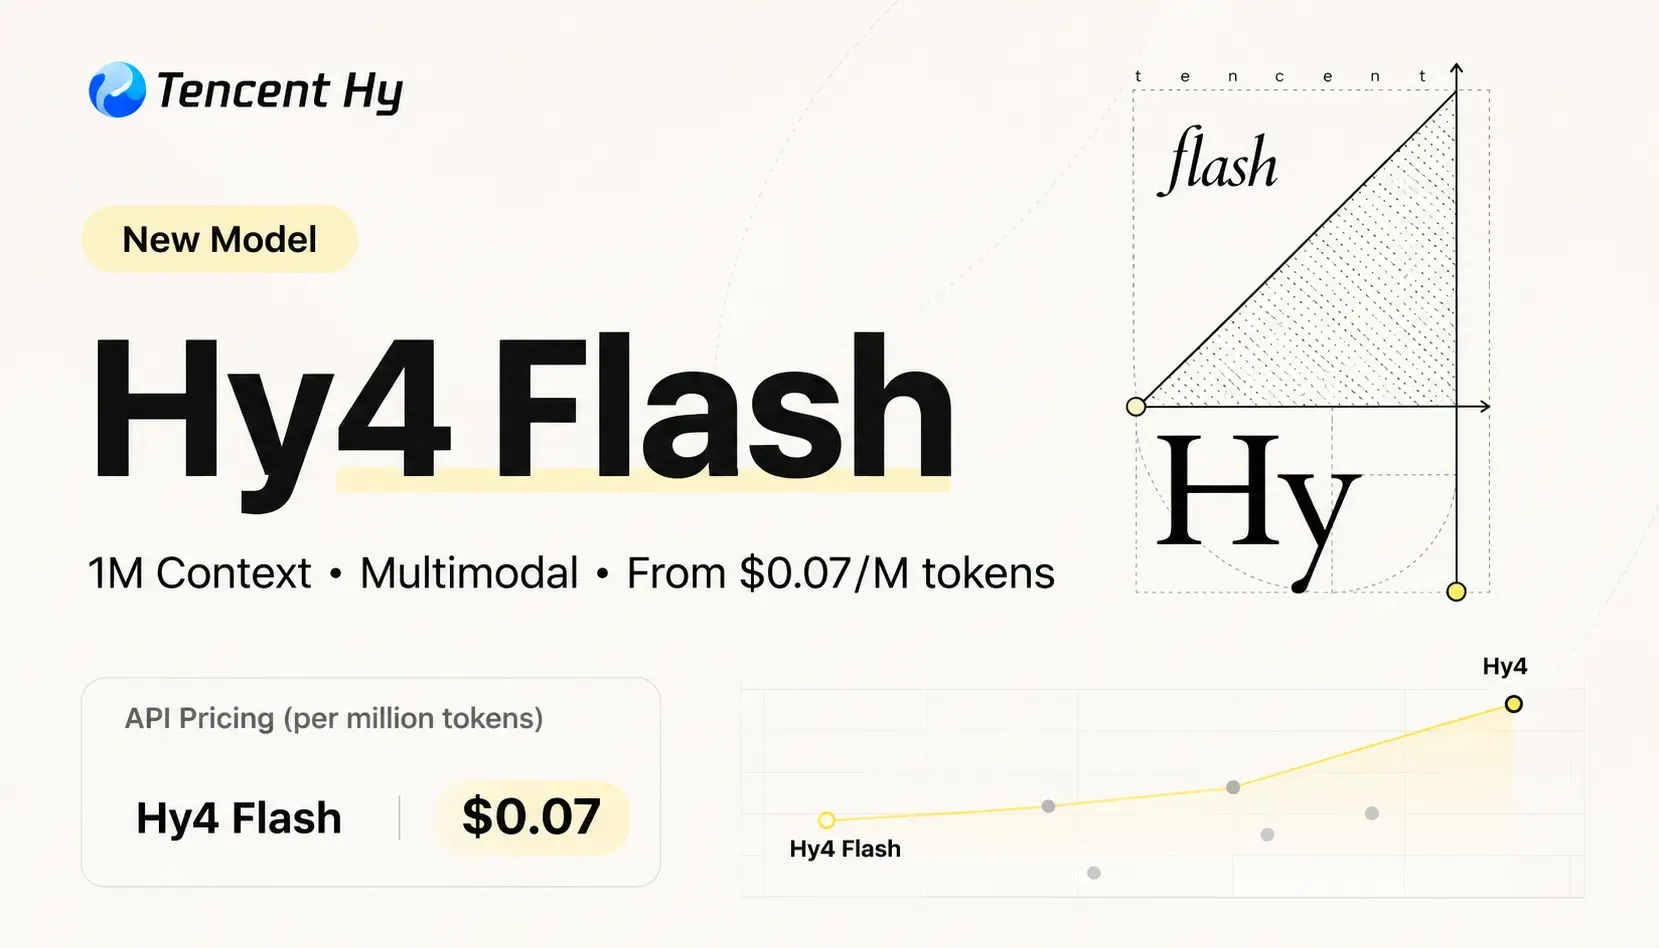
在成本方面,腾讯列出的 API 参考价格约为每百万输入 tokens 0.070 美元、每百万输出 tokens 0.281 美元,缓存输入价格则极低。腾讯称,与更大型的 Hy4 版本和其他前沿模型相比,Hy4 flash 在其内部 WorkIndex 上的单任务成本要低得多。这个角度很有参考价值:对于重视吞吐量、账单可预测性和文档处理流程的组织,Hy4 flash 或许能显著降低运营开支。不过,采购方应将腾讯的内部基准测试和盲测用户结果视为有参考价值、但未经独立验证的信息;成本与质量的比较仍应使用具有代表性的第三方任务进行验证。