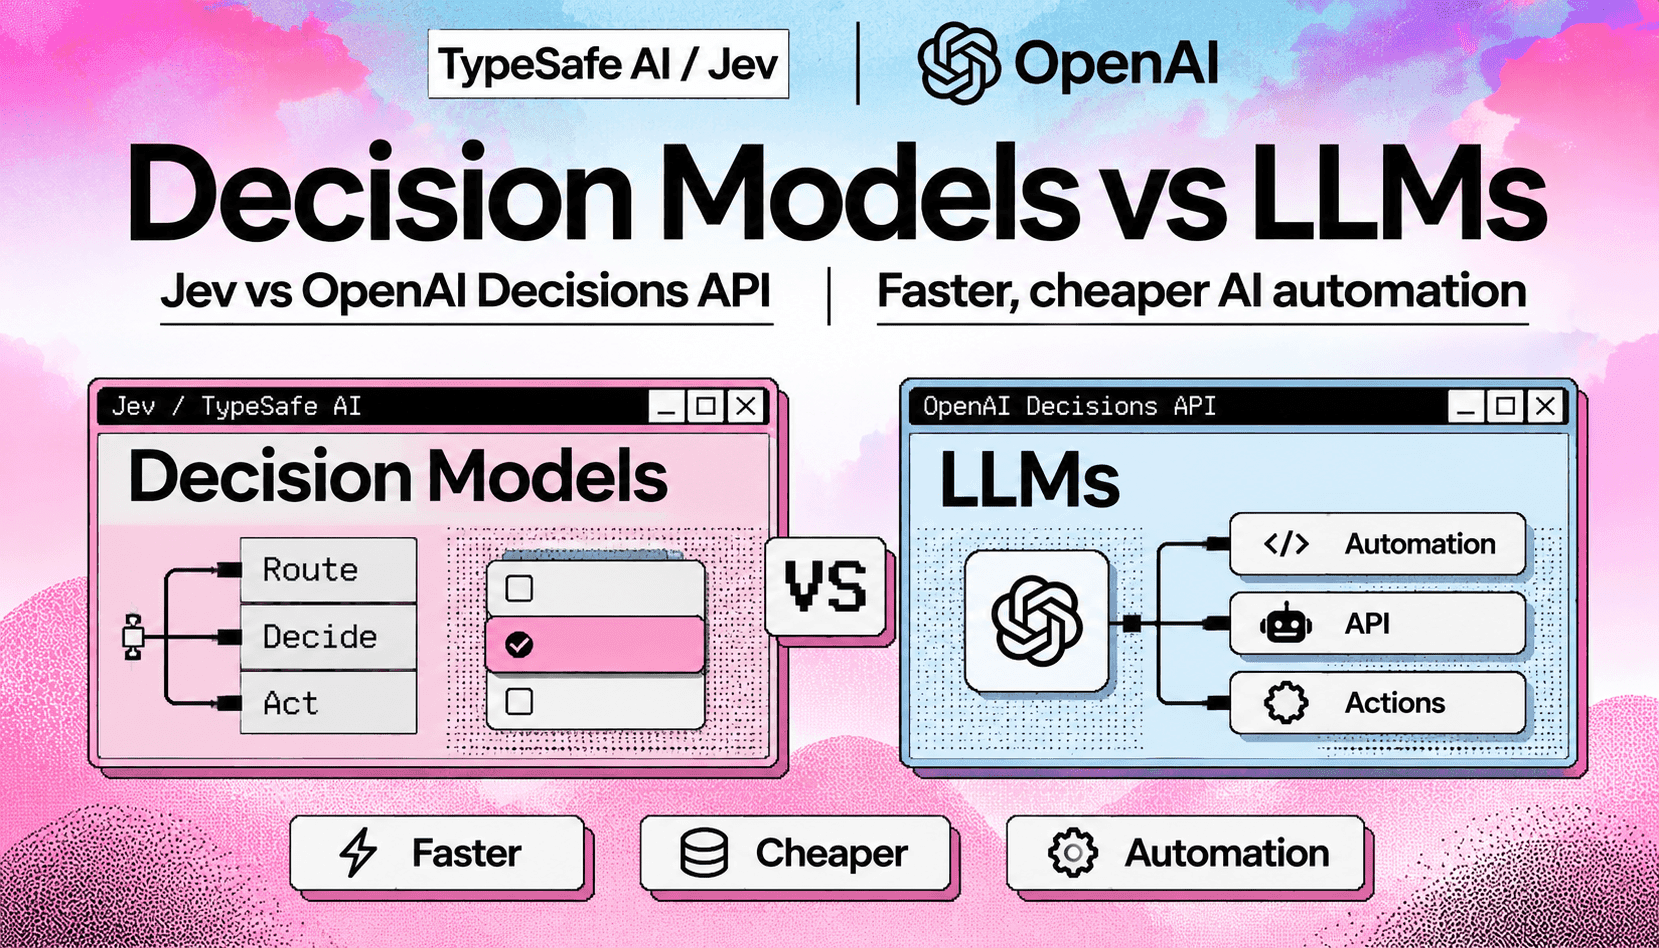
Les entreprises qui développent des pipelines d’automatisation se heurtent à un problème simple et récurrent : les LLM génératifs sont polyvalents, mais coûteux et lents lorsqu’on les utilise pour chaque décision de routage, de scoring ou de classification binaire. Une nouvelle catégorie de modèles de décision compacts, représentée par des produits comme Jev et la Decisions API d’OpenAI, cible précisément ces usages. Entraînés pour la classification déterministe, ils fournissent des scores de confiance calibrés et sont conçus pour fonctionner avec une latence et un coût de calcul inférieurs à ceux d’un LLM complet de raisonnement. Il ne s’agit pas de remplacer les LLM, mais d’adapter les capacités du modèle à la tâche afin d’obtenir des performances et des coûts prévisibles.
Les modèles de décision excellent dans la classification structurée, le routage et l’application de règles, lorsque les entrées correspondent à un nombre relativement restreint de résultats possibles. Concrètement, ils servent à classer rapidement les intentions, à orienter les demandes selon qu’elles relèvent ou non de la fraude, à effectuer de simples contrôles d’admissibilité ou à produire des scores enrichis en caractéristiques pour les agents en aval. Ils peuvent être déployés sous forme de microservices en périphérie ou intégrés à un moteur de règles, où ils jouent le rôle de premier filtre avant l’appel à un modèle de raisonnement plus puissant. Leurs résultats étant compacts et prévisibles, ils permettent de respecter des engagements de latence plus stricts et de simplifier la supervision, plutôt que de tout confier à un modèle génératif.
Cet article compare des critères mesurables — latence, coût par décision, score de confiance et explicabilité — entre des modèles de décision représentatifs, comme Jev, et la Decisions API d’OpenAI, d’une part, et les grands LLM génératifs, d’autre part. Il propose ensuite des architectures pragmatiques combinant des couches décisionnelles et des LLM afin de réduire le nombre d’appels coûteux, d’améliorer la fiabilité et de réserver les capacités de raisonnement aux cas qui en ont réellement besoin. Enfin, il présente des recommandations opérationnelles : quand choisir un modèle de routage ou de scoring, quand conserver un parcours de raisonnement et comment instrumenter une architecture hybride pour détecter et limiter les erreurs de routage.