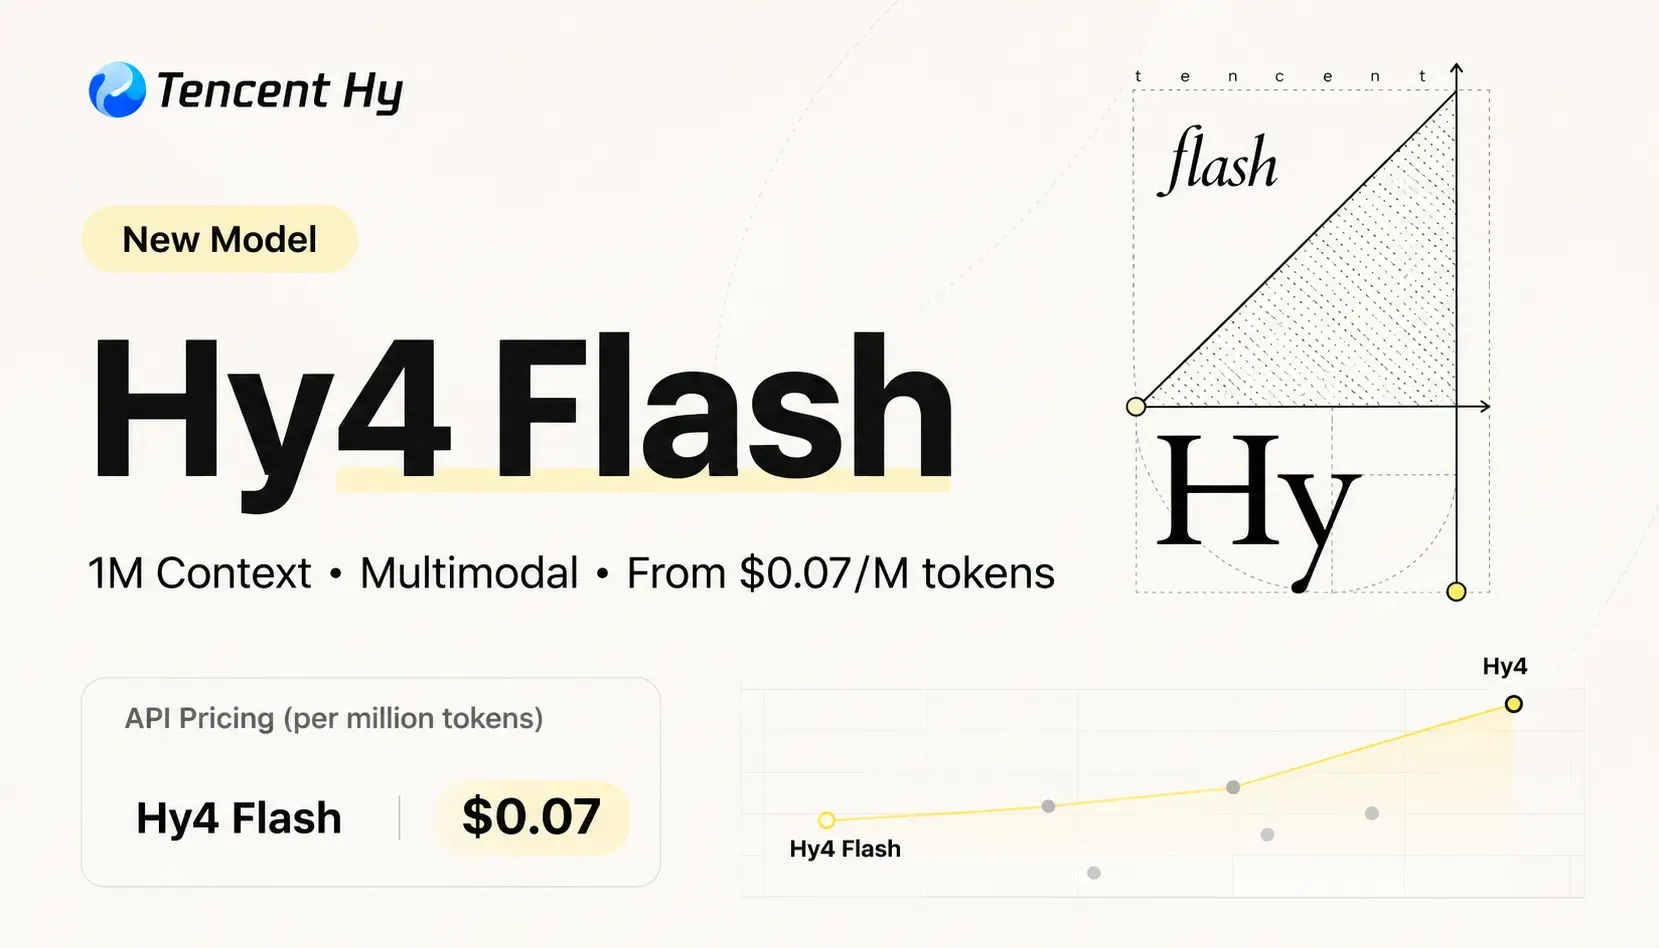
Hy4 flash de Tencent est conçu pour rivaliser sur le rapport qualité-prix, plutôt que pour dominer uniquement par ses capacités. Le modèle associe 224 milliards de paramètres au total, dont seulement 12 milliards sont actifs pendant l’inférence. Cette conception vise à réduire les coûts d’exécution sans renoncer à une vaste capacité de représentation acquise hors ligne. Tencent met en avant les entrées multimodales et une fenêtre de contexte de 1 000 000 de tokens, ainsi que des vitesses de décodage supérieures à 150 tokens par seconde grâce à une série d’optimisations de l’inférence. Pour les équipes qui évaluent différents modèles, Hy4 flash promet un compromis pragmatique : une mémoire contextuelle importante et une compréhension visuelle à un coût par tâche bien inférieur à celui de certains modèles de pointe.
En coulisses, Hy4 flash s’appuie sur des innovations architecturales introduites dans la gamme Hy : la paramétrisation Engram, qui stocke efficacement les connaissances à long terme ; la capacité conditionnelle LatentMoE, qui concentre les calculs là où ils sont nécessaires ; et l’attention hybride, qui permet d’augmenter efficacement la taille du contexte. Tencent fait également état d’une réduction considérable de l’empreinte du cache KV, un choix d’ingénierie délibéré qui diminue les coûts de mémoire et d’entrées-sorties du cache pendant l’inférence. L’apprentissage par renforcement après entraînement aurait réduit de moitié la longueur moyenne des réponses en tokens pour les tâches courantes, ce qui diminue directement la facturation des tokens générés et accélère de nombreux processus de travail.
La fenêtre de contexte annoncée d’un million de tokens et la vitesse de décodage supérieure à 150 tokens par seconde sont les caractéristiques les plus importantes sur le plan opérationnel pour les déploiements en entreprise. Tencent attribue ces résultats à la combinaison de plusieurs techniques : optimisation par méganoyau, quantification sur 4 bits, stratégies d’exécution DFly et cache KV compact. En pratique, un contexte étendu associé à un décodage rapide permet de traiter en une seule passe des documents entiers, des présentations ou des échanges répartis sur plusieurs fichiers, sans recourir à un découpage coûteux, à la reconstitution de l’état ou à l’orchestration d’agents. Ces avantages peuvent réduire la complexité technique et la latence dans les processus réels, à condition que la gestion du contexte du modèle se révèle suffisamment fiable en situation réelle.
Sur le plan économique, Tencent annonce des tarifs API indicatifs d’environ 0,070 $ par million de tokens en entrée et 0,281 $ par million de tokens en sortie, avec un tarif extrêmement bas pour les entrées mises en cache. L’entreprise affirme que Hy4 flash réduit nettement le coût par tâche sur son indice interne WorkIndex, par rapport aux variantes plus imposantes de Hy4 et à d’autres modèles de pointe. Cette approche est pertinente : pour les organisations qui privilégient le débit, la prévisibilité des factures et les processus documentaires, Hy4 flash pourrait réduire sensiblement les dépenses d’exploitation. Il convient toutefois de considérer les benchmarks internes de Tencent et les résultats obtenus auprès d’utilisateurs évaluant les modèles à l’aveugle comme des indications, et non comme des résultats vérifiés de manière indépendante. Les coûts et la qualité comparés doivent être validés sur des tâches représentatives et indépendantes.