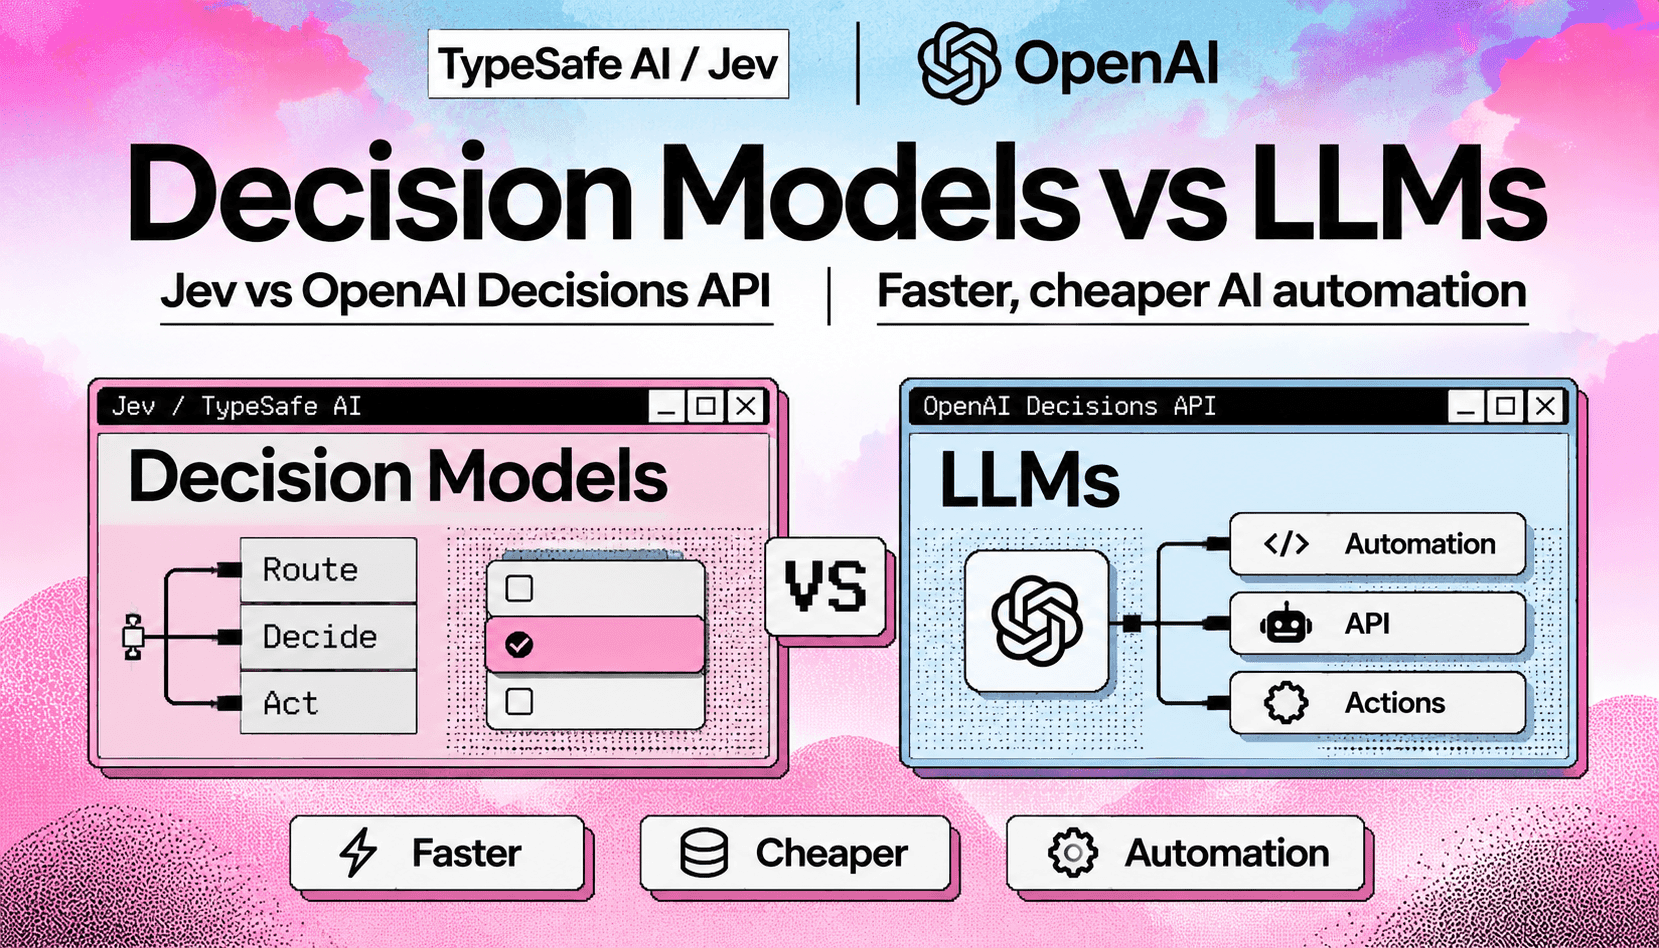
Empresas que criam pipelines de automação enfrentam um problema simples e recorrente: os LLMs generativos são flexíveis, mas ficam caros e lentos quando usados para cada encaminhamento, pontuação ou decisão binária. Uma nova categoria de modelos compactos de decisão — representada por produtos como o Jev e a Decisions API da OpenAI — foi criada para atender justamente a esses casos de uso. Esses modelos são treinados para classificação determinística, fornecem níveis de confiança calibrados e são projetados para operar com menor latência e custo computacional do que um LLM completo de raciocínio. Essa mudança não busca substituir os LLMs, mas adequar a capacidade do modelo à tarefa para obter desempenho e custos previsíveis.
Os modelos de decisão se destacam em classificação estruturada, encaminhamento e aplicação de políticas, quando as entradas correspondem a um conjunto relativamente pequeno de resultados possíveis. Na prática, isso inclui classificar intenções rapidamente, encaminhar casos de fraude ou não fraude, fazer verificações simples de elegibilidade ou gerar pontuações com muitos atributos para alimentar agentes posteriores. Eles podem ser implantados como microsserviços na borda ou dentro de um mecanismo de regras e usados como filtro inicial antes de chamar um modelo de raciocínio maior. Como suas saídas são compactas e previsíveis, eles permitem SLAs de latência mais rigorosos e um monitoramento mais simples do que delegar tudo a um modelo generativo.
Este artigo compara aspectos mensuráveis — latência, custo por decisão, pontuação de confiança e explicabilidade — entre modelos de decisão representativos, como o Jev, e a Decisions API da OpenAI, de um lado, e LLMs generativos maiores, de outro. Em seguida, apresenta arquiteturas práticas que combinam camadas de decisão e LLMs para reduzir chamadas caras, aumentar a confiabilidade e preservar a capacidade de raciocínio apenas onde ela é necessária. Para concluir, traz orientações operacionais: quando escolher modelos de encaminhamento ou pontuação, quando manter uma etapa de raciocínio e como instrumentar a arquitetura híbrida para identificar e corrigir encaminhamentos incorretos.